
12 Reguläre Ausdrücke
Übersicht
Perl Compatible Regular Expressions (PCRE, PCRE2) werden in Zabbix unterstützt.
Es gibt zwei Möglichkeiten, reguläre Ausdrücke in Zabbix zu verwenden:
- manuelle Eingabe eines regulären Ausdrucks
- Verwendung eines globalen regulären Ausdrucks, der in Zabbix erstellt wurde
Reguläre Ausdrücke
Sie können an unterstützten Stellen manuell einen regulären Ausdruck eingeben. Beachten Sie, dass der Ausdruck nicht mit @ beginnen darf, da dieses Symbol in Zabbix für Verweise auf globale reguläre Ausdrücke verwendet wird.
Bei der Verwendung regulärer Ausdrücke kann der Stack-Speicher erschöpft werden. Weitere Informationen finden Sie unter PCRE PERFORMANCE.
Beachten Sie, dass bei der mehrzeiligen Übereinstimmung die Anker ^ und $ jeweils am Anfang bzw. Ende jeder Zeile und nicht am Anfang bzw. Ende des gesamten Strings übereinstimmen.
Siehe auch Beispiele für korrektes Escaping in verschiedenen Kontexten.
Globale reguläre Ausdrücke
Im Zabbix-Frontend steht ein erweiterter Editor zum Erstellen und Testen komplexer regulärer Ausdrücke zur Verfügung.
Nachdem ein regulärer Ausdruck auf diese Weise erstellt wurde, kann er an mehreren Stellen im Frontend verwendet werden, indem auf seinen Namen mit dem Präfix @ verwiesen wird, zum Beispiel @mycustomregexp.
So erstellen Sie einen globalen regulären Ausdruck:
- Gehen Sie zu: Administration > Allgemein
- Wählen Sie im Dropdown-Menü Reguläre Ausdrücke aus
- Klicken Sie auf Neuer regulärer Ausdruck
Auf der Registerkarte Ausdrücke können Sie den Namen des regulären Ausdrucks festlegen und Unterausdrücke hinzufügen.
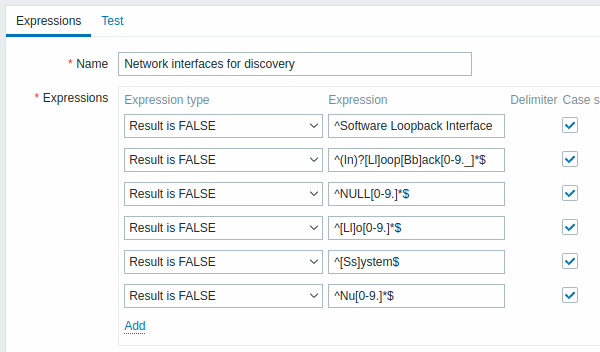
Alle Pflichtfelder sind mit einem roten Sternchen gekennzeichnet.
| Parameter | Beschreibung | |
|---|---|---|
| Name | Legen Sie den Namen des regulären Ausdrucks fest. Alle Unicode-Zeichen sind zulässig. | |
| Ausdrücke | Klicken Sie im Block „Ausdrücke“ auf Hinzufügen, um einen neuen Unterausdruck hinzuzufügen. | |
| Ausdruckstyp | Wählen Sie den Ausdruckstyp aus: Zeichenfolge enthalten – die Teilzeichenfolge muss übereinstimmen Beliebige Zeichenfolge enthalten – eine beliebige Teilzeichenfolge aus einer durch Trennzeichen getrennten Liste muss übereinstimmen. Die durch Trennzeichen getrennte Liste enthält ein Komma (,), einen Punkt (.) oder einen Schrägstrich (/). Zeichenfolge nicht enthalten – jede Zeichenfolge außer der Teilzeichenfolge muss übereinstimmen Ergebnis ist TRUE – der reguläre Ausdruck muss übereinstimmen Ergebnis ist FALSE – der reguläre Ausdruck darf nicht übereinstimmen |
|
| Ausdruck | Geben Sie eine Teilzeichenfolge/einen regulären Ausdruck ein. | |
| Trennzeichen | Ein Komma (,), ein Punkt (.) oder ein Schrägstrich (/), um Textzeichenfolgen in einem regulären Ausdruck zu trennen. Dieser Parameter ist nur aktiv, wenn der Ausdruckstyp „Beliebige Zeichenfolge enthalten“ ausgewählt ist. | |
| Groß-/Kleinschreibung beachten | Ein Kontrollkästchen, mit dem festgelegt wird, ob beim regulären Ausdruck die Groß-/Kleinschreibung beachtet wird. | |
Ein Schrägstrich (/) im Ausdruck wird wörtlich und nicht als Trennzeichen behandelt. So können Ausdrücke mit einem Schrägstrich ohne Fehler gespeichert werden.
Ein benutzerdefinierter Name für einen regulären Ausdruck in Zabbix darf Kommas, Leerzeichen usw. enthalten.
Wenn dies bei der Referenzierung zu Fehlinterpretationen führen kann (zum Beispiel ein Komma im Parameter eines Datenpunktschlüssels), kann die gesamte Referenz wie folgt in Anführungszeichen gesetzt werden: "@My custom regexp for purpose1, purpose2".
Namen regulärer Ausdrücke dürfen an anderen Stellen nicht in Anführungszeichen gesetzt werden (zum Beispiel in den Eigenschaften von LLD-Regeln).
Auf der Registerkarte Test können der reguläre Ausdruck und seine Unterausdrücke getestet werden, indem Sie eine Testzeichenfolge angeben.
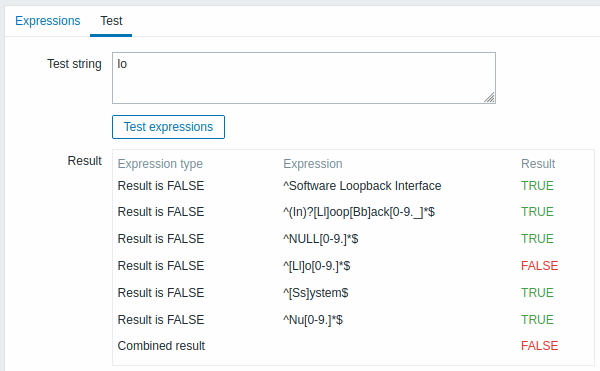
Die Ergebnisse zeigen den Status jedes Unterausdrucks sowie den Gesamtstatus des benutzerdefinierten Ausdrucks.
Der Gesamtstatus des benutzerdefinierten Ausdrucks wird als Kombiniertes Ergebnis definiert. Wenn mehrere Unterausdrücke definiert sind, verwendet Zabbix den logischen AND-Operator zur Berechnung des Kombinierten Ergebnisses. Das bedeutet, dass das Kombinierte Ergebnis ebenfalls den Status „False“ hat, wenn mindestens ein Ergebnis „False“ ist.
Standardmäßige globale reguläre Ausdrücke
Zabbix wird mit mehreren globalen regulären Ausdrücken in seinem Standarddatensatz geliefert.
| Name | Expression | Matches |
|---|---|---|
| Dateisysteme für die Erkennung | ^(btrfs|ext2|ext3|ext4|jfs|reiser|xfs|ffs|ufs|jfs|jfs2|vxfs|hfs|refs|apfs|ntfs|fat32|zfs)$ |
"btrfs" oder "ext2" oder "ext3" oder "ext4" oder "jfs" oder "reiser" oder "xfs" oder "ffs" oder "ufs" oder "jfs" oder "jfs2" oder "vxfs" oder "hfs" oder "refs" oder "apfs" oder "ntfs" oder "fat32" oder "zfs" |
| Netzwerkschnittstellen für die Erkennung | ^Software Loopback Interface |
Zeichenfolgen, die mit "Software Loopback Interface" beginnen. |
^lo$ |
"lo" | |
^(In)?[Ll]oop[Bb]ack[0-9._]*$ |
Zeichenfolgen, die optional mit "In" beginnen, dann "L" oder "l" enthalten, dann "oop", dann "B" oder "b", dann "ack", gefolgt von beliebig vielen Ziffern, Punkten oder Unterstrichen. | |
^NULL[0-9.]*$ |
Zeichenfolgen, die mit "NULL" beginnen und optional von beliebig vielen Ziffern oder Punkten gefolgt werden. | |
^[Ll]o[0-9.]*$ |
Zeichenfolgen, die mit "Lo" oder "lo" beginnen und optional von beliebig vielen Ziffern oder Punkten gefolgt werden. | |
^[Ss]ystem$ |
"System" oder "system" | |
^Nu[0-9.]*$ |
Zeichenfolgen, die mit "Nu" beginnen und optional von beliebig vielen Ziffern oder Punkten gefolgt werden. | |
| Speichergeräte für die SNMP-Erkennung | ^(Physical memory|Virtual memory|Memory buffers|Cached memory|Swap space)$ |
"Physical memory" oder "Virtual memory" oder "Memory buffers" oder "Cached memory" oder "Swap space" |
| Windows-Dienstnamen für die Erkennung | ^(MMCSS|gupdate|SysmonLog|clr_optimization_v2.0.50727_32|clr_optimization_v4.0.30319_32)$ |
"MMCSS" oder "gupdate" oder "SysmonLog" oder Zeichenfolgen wie "clr_optimization_v2.0.50727_32" und "clr_optimization_v4.0.30319_32", wobei Sie anstelle der Punkte beliebige Zeichen außer einem Zeilenumbruch verwenden können. |
| Windows-Dienststartzustände für die Erkennung | ^(automatic|automatic delayed)$ |
"automatic" oder "automatic delayed" |
Beispiele
Beispiel 1
Verwendung des folgenden Ausdrucks in der Low-Level-Discovery, um Datenbanken zu entdecken, außer einer Datenbank mit einem bestimmten Namen:
^TESTDATABASE$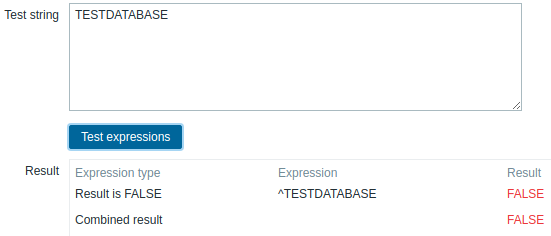
Gewählter Ausdruckstyp: "Result is FALSE". Entspricht nicht dem Namen, der die Zeichenfolge "TESTDATABASE" enthält.
Beispiel mit einem Inline-Regex-Modifikator
Verwendung des folgenden regulären Ausdrucks einschließlich eines Inline-Modifikators (?i), um die Zeichen "error" abzugleichen:
(?i)error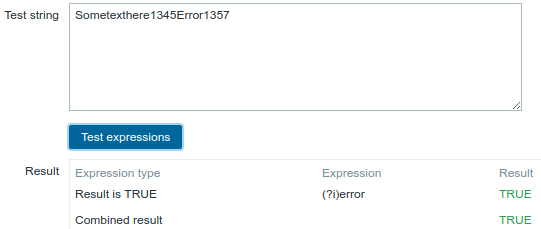
Gewählter Ausdruckstyp: "Result is TRUE". Die Zeichen "error" werden abgeglichen.
Ein weiteres Beispiel mit einem Inline-Regex-Modifikator
Verwendung des folgenden regulären Ausdrucks einschließlich mehrerer Inline-Modifikatoren, um die Zeichen nach einer bestimmten Zeile abzugleichen:
(?<=match (?i)everything(?-i) after this line\n)(?sx).*# we add s modifier to allow . match newline characters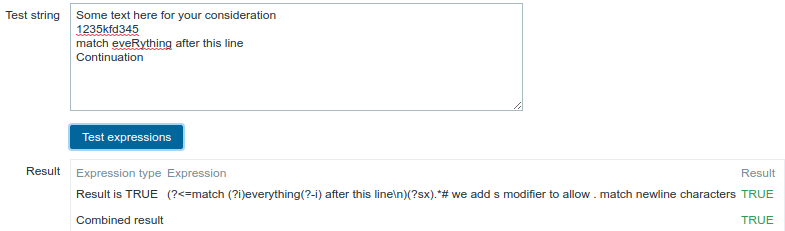
Gewählter Ausdruckstyp: "Result is TRUE". Zeichen nach einer bestimmten Zeile werden abgeglichen.
Der Modifikator g kann nicht in der Zeile angegeben werden. Die Liste der verfügbaren Modifikatoren finden Sie auf der pcresyntax man page. Weitere Informationen zur PCRE-Syntax finden Sie in der PCRE HTML documentation.
Unterstützung regulärer Ausdrücke nach Ort
| Ort | Regulärer Ausdruck | Globaler regulärer Ausdruck | Mehrzeilenabgleich | Kommentare | |
|---|---|---|---|---|---|
| Agent items | |||||
| eventlog[] | Yes | Yes | Yes | Parameter regexp, severity, source, eventid |
|
| eventlog.count[] | Parameter regexp, severity, source, eventid |
||||
| log[] | Parameter regexp |
||||
| log.count[] | |||||
| logrt[] | Yes/No | Parameter regexp unterstützt beides, Parameter file_regexp unterstützt nur nicht-globale Ausdrücke |
|||
| logrt.count[] | |||||
| proc.cpu.util[] | No | No | Parameter cmdline |
||
| proc.get[] | |||||
| proc.mem[] | |||||
| proc.num[] | |||||
| sensor[] | Parameter device und sensor unter Linux 2.4 |
||||
| system.hw.macaddr[] | Parameter interface |
||||
| system.sw.packages[] | Parameter regexp |
||||
| system.sw.packages.get[] | Parameter regexp |
||||
| vfs.dir.count[] | Parameter regex_incl, regex_excl, regex_excl_dir |
||||
| vfs.dir.get[] | Parameter regex_incl, regex_excl, regex_excl_dir |
||||
| vfs.dir.size[] | Parameter regex_incl, regex_excl, regex_excl_dir |
||||
| vfs.file.regexp[] | Yes | Parameter regexp |
|||
| vfs.file.regmatch[] | |||||
| web.page.regexp[] | |||||
| SNMP traps | |||||
| snmptrap[] | Yes | Yes | No | Parameter regexp |
|
| Item value preprocessing | Yes | No | No | Parameter pattern |
|
| Functions for triggers/calculated items | |||||
| count() | Yes | Yes | Yes | Parameter pattern, wenn der Parameter operator regexp oder iregexp ist |
|
| countunique() | Yes | Yes | |||
| find() | Yes | Yes | |||
| logeventid() | Yes | Yes | No | Parameter pattern |
|
| logsource() | |||||
| Low-level discovery | |||||
| Filters | Yes | Yes | No | Feld Regular expression | |
| Overrides | Yes | No | In den Optionen matches, does not match für Operation-Bedingungen | ||
| Action conditions | Yes | No | No | In den Optionen matches, does not match für die Autoregistrierungsbedingungen Host name und Host metadata | |
| Scripts | Yes | Yes | No | Feld Input validation rule | |
| Web monitoring | Yes | No | Yes | Variables mit Präfix regex: Feld Required string |
|
| User macro context | Yes | No | No | Im Makrokontext mit Präfix regex: | |
| Macro functions | |||||
| regsub() | Yes | No | No | Parameter pattern |
|
| iregsub() | |||||
| Link indicators in maps | Yes | No | No | Feld Pattern (für Textelemente) | |
| Icon mapping | Yes | Yes | No | Feld Expression | |
| Value mapping | Yes | No | No | Feld Value, wenn der Zuordnungstyp regexp ist |
|