
2 Priekšapstrādes detaļas
Pārskats
Šajā sadaļā ir sniegta informācija par vienumu vērtību priekšapstrādi. Vienumu vērtību priekšapstrāde ļauj definēt un izpildīt transformācijas noteikumus saņemtajām vienumu vērtībām.
Priekšapstrādi pārvalda priekšapstrādes pārvaldnieka process kopā ar priekšapstrādes darba procesiem, kas izpilda priekšapstrādes darbības. Visas vērtības, kurām tiek veikta priekšapstrāde (pirms Zabbix 7.0.17 — visas vērtības), kas saņemtas no dažādiem datu ieguves procesiem, pirms pievienošanas vēstures kešatmiņai iziet cauri priekšapstrādes pārvaldniekam. Starp datu ieguves procesiem (aptaujātājiem, uztvērējiem u. c.) un priekšapstrādes procesu tiek izmantota uz ligzdām balstīta IPC saziņa. Priekšapstrādes darbības veic Zabbix serveris vai Zabbix starpniekserveris (starpniekservera uzraudzītajiem vienumiem).
Vienuma vērtības apstrāde
Lai vizualizētu datu plūsmu no datu avota uz Zabbix datubāzi, var izmantot šo vienkāršoto diagrammu:
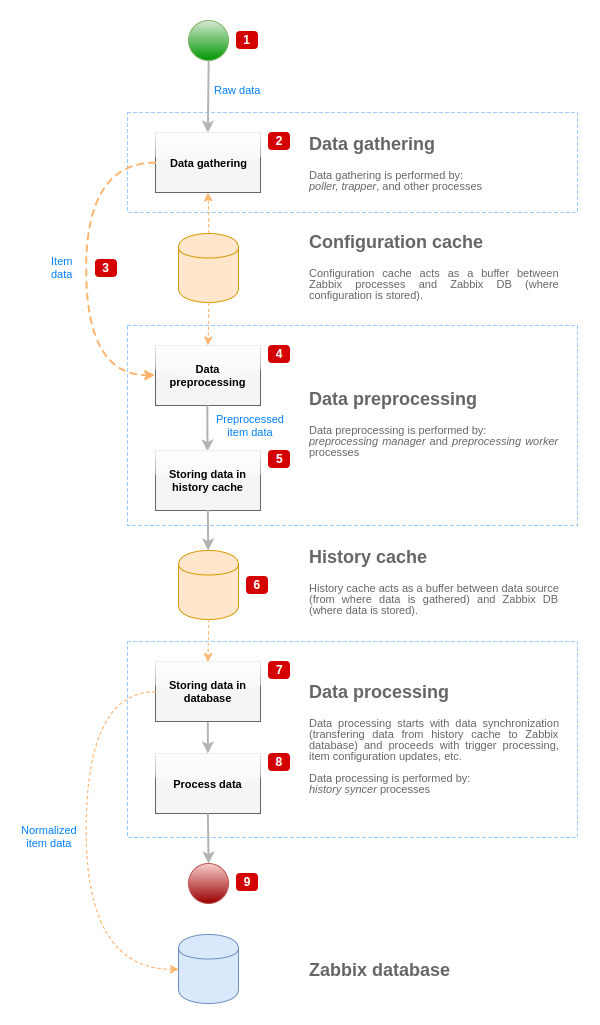
Iepriekš redzamajā diagrammā vienkāršotā veidā ir parādīti tikai procesi, objekti un darbības, kas saistītas ar vienuma vērtības apstrādi. Diagrammā nav parādītas nosacītas virziena izmaiņas, kļūdu apstrāde vai cikli. Nav parādīta arī priekšapstrādes pārvaldnieka lokālā datu kešatmiņa, jo tā tieši neietekmē datu plūsmu. Šīs diagrammas mērķis ir parādīt vienuma vērtības apstrādē iesaistītos procesus un to mijiedarbību.
- Datu apkopošana sākas ar neapstrādātiem datiem no datu avota. Šajā brīdī dati satur tikai ID, laika zīmogu un vērtību (var būt arī vairākas vērtības).
- Neatkarīgi no izmantotā datu apkopotāja veida princips aktīvajām un pasīvajām pārbaudēm, trapper vienumiem u. c. ir vienāds, jo mainās tikai datu formāts un komunikācijas iniciators (vai nu datu apkopotājs gaida savienojumu un datus, vai arī datu apkopotājs sāk komunikāciju un pieprasa datus). Neapstrādātie dati tiek validēti, un vienuma konfigurācija tiek iegūta no konfigurācijas kešatmiņas (dati tiek papildināti ar konfigurācijas datiem).
- Datu pārsūtīšanai no datu apkopotājiem uz priekšapstrādes pārvaldnieku tiek izmantots uz ligzdām balstīts IPC mehānisms. Šajā brīdī datu apkopotājs turpina apkopot datus, negaidot atbildi no priekšapstrādes pārvaldnieka.
- Tiek veikta datu priekšapstrāde. Tā ietver priekšapstrādes darbību izpildi un atkarīgo vienumu apstrādi.
Vienums priekšapstrādes laikā var mainīt savu stāvokli uz NOT SUPPORTED, ja kāda no priekšapstrādes darbībām neizdodas.
- Vēstures dati no priekšapstrādes pārvaldnieka lokālās datu kešatmiņas tiek pārsūtīti uz vēstures kešatmiņu.
- Šajā brīdī datu plūsma apstājas līdz nākamajai vēstures kešatmiņas sinhronizācijai (kad vēstures sinhronizētāja process veic datu sinhronizāciju).
- Sinhronizācijas process sākas ar datu normalizēšanu pirms datu saglabāšanas Zabbix datubāzē.
Datu normalizēšanas laikā tiek veikta konvertēšana uz vēlamo vienuma tipu (tipu, kas definēts vienuma konfigurācijā), tostarp teksta datu saīsināšana, pamatojoties uz iepriekš definētajiem izmēriem, kas atļauti šiem tipiem (
HISTORY_STR_VALUE_LENvirknei,HISTORY_TEXT_VALUE_LENtekstam unHISTORY_LOG_VALUE_LENžurnāla vērtībām). Pēc normalizēšanas dati tiek nosūtīti uz Zabbix datubāzi.
Vienums var mainīt savu stāvokli uz NOT SUPPORTED, ja datu normalizēšana neizdodas (piemēram, ja teksta vērtību nevar konvertēt par skaitli).
- Apkopotie dati tiek apstrādāti - tiek pārbaudīti trigeri, atjaunināta vienuma konfigurācija, ja vienums kļūst NOT SUPPORTED, u. c.
- No vienuma vērtības apstrādes viedokļa tas tiek uzskatīts par datu plūsmas beigām.
Vienuma vērtības priekšapstrāde
Datu priekšapstrāde tiek veikta, veicot tālāk norādītās darbības:
- Ja vienumam nav ne priekšapstrādes, ne atkarīgo vienumu, tā vērtība tiek pievienota vēstures kešatmiņai vai nosūtīta LLD pārvaldniekam. Pretējā gadījumā vienuma vērtība tiek nodota priekšapstrādes pārvaldniekam, izmantojot uz UNIX ligzdām balstītu IPC mehānismu (pirms Zabbix 7.0.17 visas vērtības tika nodotas caur priekšapstrādes pārvaldnieku, pirms tās tika pievienotas vēstures kešatmiņai vai nosūtītas LLD pārvaldniekam).
- Tiek izveidots priekšapstrādes uzdevums un pievienots rindai, un priekšapstrādes izpildītāji tiek informēti par jauno uzdevumu.
- Šajā brīdī datu plūsma apstājas, līdz ir pieejams vismaz viens neaizņemts (t. i., neviens uzdevums netiek izpildīts) priekšapstrādes izpildītājs.
- Kad priekšapstrādes izpildītājs ir pieejams, tas paņem nākamo uzdevumu no rindas.
- Pēc priekšapstrādes pabeigšanas (neatkarīgi no tā, vai priekšapstrādes darbības ir izpildītas veiksmīgi vai neveiksmīgi) priekšapstrādātā vērtība tiek pievienota pabeigto uzdevumu rindai, un pārvaldnieks tiek informēts par jaunu pabeigtu uzdevumu.
- Priekšapstrādes pārvaldnieks pārveido rezultātu vajadzīgajā formātā (ko nosaka vienuma vērtības tips) un vai nu pievieno to vēstures kešatmiņai, vai nosūta LLD pārvaldniekam.
- Ja apstrādātajam vienumam ir atkarīgie vienumi, tie tiek pievienoti priekšapstrādes rindai kopā ar priekšapstrādāto galvenā vienuma vērtību.
Atkarīgie vienumi tiek ievietoti rindā, apejot parastos vērtību priekšapstrādes pieprasījumus, bet tikai tiem galvenajiem vienumiem, kuriem ir iestatīta vērtība un kuri nav stāvoklī NOT SUPPORTED.

Ņemiet vērā, ka diagrammā galvenā vienuma priekšapstrāde ir nedaudz vienkāršota, izlaižot priekšapstrādes kešatmiņu.
Priekšapstrādes rinda
Priekšapstrādes rinda ir organizēta šādi:
- gaidošo uzdevumu saraksts:
- uzdevumi, kas izveidoti tieši no vērtību priekšapstrādes pieprasījumiem to saņemšanas secībā
- tūlītējo uzdevumu saraksts (apstrādāti pirms gaidošajiem uzdevumiem):
- testēšanas uzdevumi (izveidoti, reaģējot uz vienuma/priekšapstrādes testēšanas pieprasījumiem no lietotāja saskarnes)
- atkarīgo vienumu uzdevumi
- secības uzdevumi (uzdevumi, kas jāizpilda stingrā secībā):
- ar priekšapstrādes soļiem, kuros tiek izmantota pēdējā vērtība:
- izmaiņas
- ierobežošana
- JavaScript (baitu koda kešatmiņa)
- atkarīgo vienumu priekšapstrādes kešatmiņa
- ar priekšapstrādes soļiem, kuros tiek izmantota pēdējā vērtība:
- pabeigto uzdevumu saraksts
Priekšapstrādes kešatmiņa
Priekšapstrādes kešatmiņa tika ieviesta, lai uzlabotu priekšapstrādes veiktspēju vairākiem atkarīgajiem vienumiem ar līdzīgām priekšapstrādes darbībām (kas ir bieži sastopams LLD rezultāts).
Kešatmiņa tiek izmantota, priekšapstrādājot vienu atkarīgo vienumu un atkārtoti izmantojot daļu iekšējo priekšapstrādes datu pārējiem atkarīgajiem vienumiem. Priekšapstrādes kešatmiņa tiek atbalstīta tikai pirmajam priekšapstrādes solim ar šādiem tipiem:
- Prometheus pattern (indeksē ievadi pēc metrikām)
- JSONPath (parsē datus objektu kokā un indeksē pirmo izteiksmi
[?(@.path == "value")])
Priekšapstrādes darbinieki
Zabbix servera konfigurācijas fails ļauj lietotājiem iestatīt priekšapstrādes darbinieku pavedienu skaitu. Konfigurācijas parametrs StartPreprocessors jāizmanto, lai iestatītu iepriekš palaisto priekšapstrādes darbinieku instanču skaitu, kam vajadzētu vismaz atbilst pieejamo CPU kodolu skaitam.
Ja priekšapstrādes uzdevumi nav saistīti ar CPU noslodzi un ietver biežus tīkla pieprasījumus, ieteicams konfigurēt papildu darbiniekus. Optimālo priekšapstrādes darbinieku skaitu var noteikt, ņemot vērā daudzus faktorus, tostarp "priekšapstrādājamo" vienumu skaitu (vienumi, kuriem jāizpilda jebkādi priekšapstrādes soļi), datu apkopošanas procesu skaitu, vidējo soļu skaitu vienuma priekšapstrādei u. c. Nepietiekams darbinieku skaits var izraisīt lielu atmiņas lietojumu. Lai novērstu pārmērīgu atmiņas lietojumu jūsu Zabbix instalācijā, skatiet sadaļu Pārmērīga atmiņas lietojuma profilēšana ar tcmalloc.
Tomēr, pieņemot, ka netiek veiktas smagas priekšapstrādes darbības, piemēram, lielu XML/JSON fragmentu parsēšana, priekšapstrādes darbinieku skaits var atbilst kopējam datu apkopotāju skaitam. Tādējādi apkopotajiem datiem lielākoties (izņemot gadījumus, kad dati no apkopotāja tiek saņemti lielapjomā) būs pieejams vismaz viens neaizņemts priekšapstrādes darbinieks.
Pārāk daudz datu apkopošanas procesu (aptaukošanas procesi, nepieejamu resursdatoru aptaukošanas procesi, ODBC aptaukošanas procesi, HTTP aptaukošanas procesi, Java aptaukošanas procesi, pingotāji, uztvērēji, starpniekserveru aptaukošanas procesi) kopā ar IPMI pārvaldnieku, SNMP uztvērēju un priekšapstrādes darbiniekiem var izsmelt priekšapstrādes pārvaldniekam noteikto failu deskriptoru ierobežojumu katram procesam.
Failu deskriptoru ierobežojuma izsmelšana katram procesam izraisīs Zabbix servera apturēšanu, parasti neilgi pēc palaišanas, taču dažkārt tas var aizņemt vairāk laika.
Lai izvairītos no šādām problēmām, pārskatiet Zabbix servera konfigurācijas failu, lai optimizētu vienlaicīgo pārbaužu un procesu skaitu.
Turklāt, ja nepieciešams, pārbaudiet un pielāgojiet sistēmas ierobežojumus, lai nodrošinātu, ka failu deskriptoru ierobežojums ir iestatīts pietiekami augsts.
Vērtību apstrādes konveijers
Vienuma vērtības apstrādi vairākos soļos (jeb fāzēs) veic vairāki procesi. Tas var izraisīt tālāk norādīto.
- Atkarīgais vienums var saņemt vērtības, kamēr PAMATVIENUMS vērtību nevar saņemt.
To var panākt, izmantojot šādu lietošanas gadījumu:
- Pamatvienumam ir
UINTvērtības tips (var izmantot trapper vienumu), bet atkarīgajam vienumam irTEXTvērtības tips. - Ne pamatvienumam, ne atkarīgajam vienumam nav nepieciešamas priekšapstrādes darbības.
- Pamatvienumam jānosūta teksta vērtība (piemēram, "abc").
- Tā kā nav izpildāmu priekšapstrādes darbību, priekšapstrādes pārvaldnieks pārbauda, vai pamatvienums nav stāvoklī NOT SUPPORTED un vai vērtība ir iestatīta (abi nosacījumi ir izpildīti), un ievieto rindā atkarīgo vienumu ar tādu pašu vērtību kā pamatvienumam (jo priekšapstrādes darbību nav).
- Kad gan pamatvienums, gan atkarīgais vienums sasniedz vēstures sinhronizācijas fāzi, pamatvienums kļūst par NOT SUPPORTED, jo rodas vērtības konvertēšanas kļūda (teksta datus nevar konvertēt par neparakstītu veselu skaitli).
- Pamatvienumam ir
Rezultātā atkarīgais vienums saņem vērtību, bet pamatvienuma stāvoklis mainās uz NOT SUPPORTED.
- Atkarīgais vienums saņem vērtību, kas nav pieejama pamatvienuma vēsturē.
Lietošanas gadījums ir ļoti līdzīgs iepriekšējam, izņemot pamatvienuma tipu.
Piemēram, ja pamatvienumam tiek izmantots
CHARtips, pamatvienuma vērtība vēstures sinhronizācijas fāzē tiks saīsināta, savukārt atkarīgie vienumi saņems savas vērtības no pamatvienuma sākotnējās (nesaīsinātās) vērtības.