
2 Details zur Vorverarbeitung
Übersicht
Dieser Abschnitt enthält Details zur Vorverarbeitung von Datenpunktwerten. Mit der Vorverarbeitung von Datenpunkten können Transformationsregeln für die empfangenen Datenpunktwerte definiert und ausgeführt werden.
Die Vorverarbeitung wird vom Prozess des Vorverarbeitungsmanagers zusammen mit Vorverarbeitungs-Workern verwaltet, die die Vorverarbeitungsschritte ausführen. Alle Werte mit Vorverarbeitung (vor Zabbix 7.0.17 alle Werte), die von verschiedenen Datensammlern empfangen werden, durchlaufen den Vorverarbeitungsmanager, bevor sie dem Verlaufscache hinzugefügt werden. Zwischen Datensammlern (Pollern, Trappern usw.) und dem Vorverarbeitungsprozess wird eine socketbasierte IPC-Kommunikation verwendet. Entweder der Zabbix Server oder der Zabbix Proxy (für die vom Proxy überwachten Datenpunkte) führt die Vorverarbeitungsschritte aus.
Verarbeitung von Datenpunktwerten
Um den Datenfluss von der Datenquelle zur Zabbix-Datenbank zu veranschaulichen, kann das folgende vereinfachte Diagramm verwendet werden:
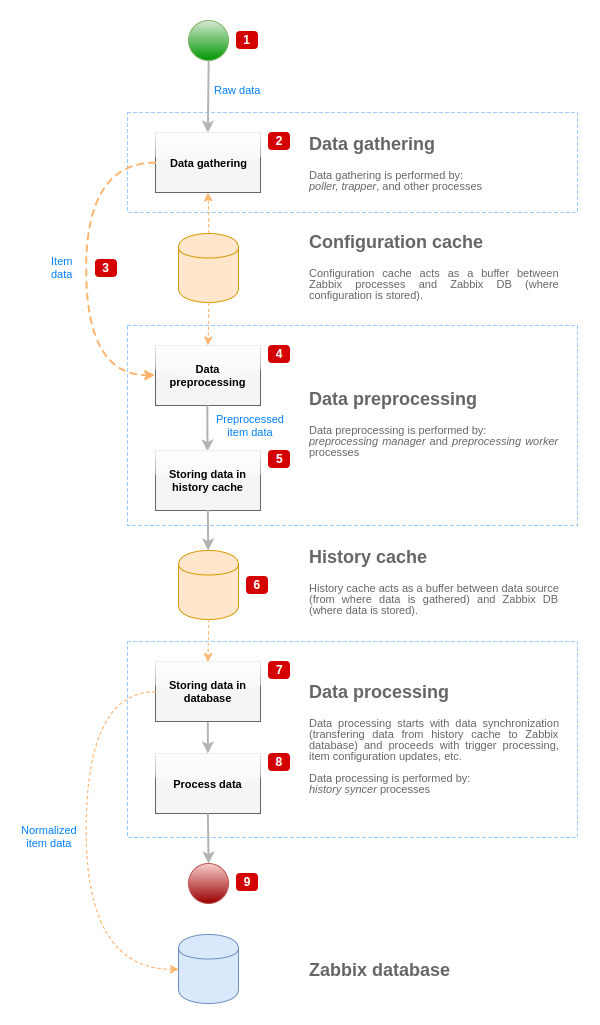
Das obige Diagramm zeigt nur Prozesse, Objekte und Aktionen im Zusammenhang mit der Verarbeitung von Datenpunktwerten in vereinfachter Form. Bedingte Richtungsänderungen, Fehlerbehandlung und Schleifen werden im Diagramm nicht dargestellt. Der lokale Datencache des Vorverarbeitungsmanagers wird ebenfalls nicht dargestellt, da er den Datenfluss nicht direkt beeinflusst. Ziel dieses Diagramms ist es, die an der Verarbeitung von Datenpunktwerten beteiligten Prozesse und deren Zusammenspiel zu veranschaulichen.
- Die Datenerfassung beginnt mit Rohdaten aus einer Datenquelle. Zu diesem Zeitpunkt enthalten die Daten nur die ID, den Zeitstempel und den Wert (es können auch mehrere Werte enthalten sein).
- Unabhängig vom verwendeten Datensammler ist das Prinzip bei aktiven oder passiven Prüfungen, bei Trapper-Datenpunkten usw. dasselbe, da sich lediglich das Datenformat und der Kommunikationsinitiator ändern (entweder wartet der Datensammler auf eine Verbindung und Daten, oder der Datensammler initiiert die Kommunikation und fordert die Daten an). Die Rohdaten werden validiert, und die Datenpunktkonfiguration wird aus dem Konfigurationscache abgerufen (die Daten werden um die Konfigurationsdaten ergänzt).
- Für die Übertragung der Daten von den Datensammlern an den Vorverarbeitungsmanager wird ein socketbasierter IPC-Mechanismus verwendet. Zu diesem Zeitpunkt setzt der Datensammler die Datenerfassung fort, ohne auf die Antwort des Vorverarbeitungsmanagers zu warten.
- Die Datenvorverarbeitung wird durchgeführt. Dazu gehören die Ausführung der Vorverarbeitungsschritte und die Verarbeitung abhängiger Datenpunkte.
Ein Datenpunkt kann während der Vorverarbeitung in den Status NOT SUPPORTED wechseln, wenn einer der Vorverarbeitungsschritte fehlschlägt.
- Die Verlaufsdaten aus dem lokalen Datencache des Vorverarbeitungsmanagers werden in den Verlaufscache übertragen.
- An diesem Punkt wird der Datenfluss bis zur nächsten Synchronisierung des Verlaufscaches angehalten (wenn der Prozess des Verlaufssynchronisierers die Datensynchronisierung durchführt).
- Der Synchronisierungsprozess beginnt mit der Datennormalisierung, bevor die Daten in der Zabbix-Datenbank gespeichert werden.
Bei der Datennormalisierung werden Konvertierungen in den gewünschten Datenpunkttyp (den in der Datenpunktkonfiguration definierten Typ) durchgeführt. Dazu gehört auch das Kürzen von Textdaten auf Grundlage der für diese Typen zulässigen vordefinierten Größen (
HISTORY_STR_VALUE_LENfür Zeichenfolgen,HISTORY_TEXT_VALUE_LENfür Text undHISTORY_LOG_VALUE_LENfür Protokollwerte). Nach Abschluss der Normalisierung werden die Daten an die Zabbix-Datenbank gesendet.
Ein Datenpunkt kann in den Status NOT SUPPORTED wechseln, wenn die Datennormalisierung fehlschlägt (beispielsweise wenn ein Textwert nicht in eine Zahl konvertiert werden kann).
- Die erfassten Daten werden verarbeitet – Auslöser werden überprüft, die Datenpunktkonfiguration wird aktualisiert, wenn der Datenpunkt in den Status NOT SUPPORTED wechselt usw.
- Aus Sicht der Verarbeitung von Datenpunktwerten gilt dies als Ende des Datenflusses.
Vorverarbeitung von Datenpunktwerten
Die Datenvorverarbeitung erfolgt in den folgenden Schritten:
- Wenn der Datenpunkt weder über eine Vorverarbeitung noch über abhängige Datenpunkte verfügt, wird sein Wert entweder zum Verlaufscache hinzugefügt oder an den LLD-Manager gesendet. Andernfalls wird der Datenpunktwert mithilfe eines IPC-Mechanismus auf UNIX-Socket-Basis an den Vorverarbeitungsmanager übergeben (vor Zabbix 7.0.17 werden alle Werte an den Vorverarbeitungsmanager übergeben, bevor sie zum Verlaufscache hinzugefügt oder an den LLD-Manager gesendet werden).
- Eine Vorverarbeitungsaufgabe wird erstellt und zur Warteschlange hinzugefügt. Anschließend werden die Vorverarbeitungs-Worker über die neue Aufgabe benachrichtigt.
- An diesem Punkt wird der Datenfluss angehalten, bis mindestens ein nicht belegter Vorverarbeitungs-Worker verfügbar ist, der also keine Aufgaben ausführt.
- Sobald ein Vorverarbeitungs-Worker verfügbar ist, übernimmt er die nächste Aufgabe aus der Warteschlange.
- Nach Abschluss der Vorverarbeitung, unabhängig davon, ob die Ausführung der Vorverarbeitungsschritte erfolgreich war oder fehlgeschlagen ist, wird der vorverarbeitete Wert zur Warteschlange der abgeschlossenen Aufgaben hinzugefügt und der Manager über eine neue abgeschlossene Aufgabe benachrichtigt.
- Der Vorverarbeitungsmanager konvertiert das Ergebnis in das gewünschte Format, das durch den Werttyp des Datenpunkts definiert ist, und fügt es entweder zum Verlaufscache hinzu oder sendet es an den LLD-Manager.
- Wenn für den verarbeiteten Datenpunkt abhängige Datenpunkte vorhanden sind, werden diese mit dem vorverarbeiteten Wert des Master-Datenpunkts zur Vorverarbeitungswarteschlange hinzugefügt. Abhängige Datenpunkte werden unter Umgehung der normalen Anforderungen zur Wertvorverarbeitung in die Warteschlange eingereiht, jedoch nur für Master-Datenpunkte, bei denen der Wert festgelegt ist und die sich nicht im Status NOT SUPPORTED befinden.

Beachten Sie, dass die Vorverarbeitung des Master-Datenpunkts im Diagramm leicht vereinfacht dargestellt ist, da das Caching der Vorverarbeitung übersprungen wird.
Vorverarbeitungswarteschlange
Die Vorverarbeitungswarteschlange ist wie folgt organisiert:
- die Liste der ausstehenden Aufgaben:
- Aufgaben, die direkt aus Anforderungen zur Datenpunktvorverarbeitung in der Reihenfolge erstellt wurden, in der sie empfangen wurden
- die Liste der sofort auszuführenden Aufgaben (werden vor ausstehenden Aufgaben verarbeitet):
- Testaufgaben (als Antwort auf Testanforderungen für Datenpunkte bzw. Vorverarbeitung durch das Frontend erstellt)
- Aufgaben für abhängige Datenpunkte
- Sequenzaufgaben (Aufgaben, die in einer strikt festgelegten Reihenfolge ausgeführt werden müssen):
- mit Vorverarbeitungsschritten, die den letzten Wert verwenden:
- Änderung
- Drosselung
- JavaScript (Bytecode-Caching)
- Caching der Vorverarbeitung abhängiger Datenpunkte
- mit Vorverarbeitungsschritten, die den letzten Wert verwenden:
- die Liste der abgeschlossenen Aufgaben
Caching der Vorverarbeitung
Das Caching der Vorverarbeitung wurde eingeführt, um die Leistung der Vorverarbeitung für mehrere abhängige Datenpunkte mit ähnlichen Vorverarbeitungsschritten zu verbessern (was ein häufiges Ergebnis von LLD ist).
Beim Caching wird ein abhängiger Datenpunkt vorverarbeitet und ein Teil der internen Vorverarbeitungsdaten für die übrigen abhängigen Datenpunkte wiederverwendet. Der Vorverarbeitungs-Cache wird nur für den ersten Vorverarbeitungsschritt der folgenden Typen unterstützt:
- Prometheus-Muster (indiziert die Eingabe nach Metriken)
- JSONPath (analysiert die Daten in einen Objektbaum und indiziert den ersten Ausdruck
[?(@.path == "value")])
Preprocessing-Worker
Die Konfigurationsdatei des Zabbix Servers ermöglicht es Benutzern, die Anzahl der Threads für Preprocessing-Worker festzulegen. Der Konfigurationsparameter StartPreprocessors sollte verwendet werden, um die Anzahl der vorab gestarteten Instanzen von Preprocessing-Workern festzulegen. Diese sollte mindestens der Anzahl der verfügbaren CPU-Kerne entsprechen.
Wenn Preprocessing-Aufgaben nicht CPU-intensiv sind und häufige Netzwerkanfragen beinhalten, wird empfohlen, zusätzliche Worker zu konfigurieren. Die optimale Anzahl von Preprocessing-Workern kann anhand vieler Faktoren bestimmt werden, darunter die Anzahl der „preprocessbaren“ Datenpunkte (Datenpunkte, für die Preprocessing-Schritte ausgeführt werden müssen), die Anzahl der Datensammlungsprozesse, die durchschnittliche Anzahl der Schritte beim Preprocessing von Datenpunkten usw. Eine unzureichende Anzahl von Workern kann zu einer hohen Speichernutzung führen. Informationen zur Fehlerbehebung bei übermäßiger Speichernutzung in Ihrer Zabbix-Installation finden Sie unter Profiling excessive memory usage with tcmalloc.
Wenn jedoch keine aufwendigen Preprocessing-Vorgänge wie das Parsen großer XML-/JSON-Blöcke ausgeführt werden, kann die Anzahl der Preprocessing-Worker der Gesamtzahl der Datensammler entsprechen. Auf diese Weise steht für die gesammelten Daten meistens (außer in Fällen, in denen Daten vom Datensammler in großen Mengen eintreffen) mindestens ein nicht belegter Preprocessing-Worker zur Verfügung.
Zu viele Datensammlungsprozesse (Poller, nicht erreichbare Poller, ODBC-Poller, HTTP-Poller, Java-Poller, Pinger, Trapper, Proxy-Poller) können zusammen mit dem IPMI-Manager, dem SNMP-Trapper und den Preprocessing-Workern das Limit der Dateideskriptoren pro Prozess für den Preprocessing-Manager ausschöpfen.
Das Ausschöpfen des Limits der Dateideskriptoren pro Prozess führt dazu, dass der Zabbix Server beendet wird, normalerweise kurz nach dem Start, manchmal jedoch erst später.
Um solche Probleme zu vermeiden, überprüfen Sie die Zabbix-Server-Konfigurationsdatei, um die Anzahl der gleichzeitigen Prüfungen und Prozesse zu optimieren.
Stellen Sie außerdem bei Bedarf sicher, dass das Limit der Dateideskriptoren ausreichend hoch festgelegt ist, indem Sie die Systemlimits überprüfen und anpassen.
Pipeline zur Wertverarbeitung
Die Verarbeitung von Datenpunktwerten wird von mehreren Prozessen in mehreren Schritten (oder Phasen) ausgeführt. Dies kann zu Folgendem führen:
- Ein abhängiger Datenpunkt kann Werte empfangen, während der Wert des MASTER-Datenpunkts dies nicht kann.
Dies kann mit folgendem Anwendungsfall erreicht werden:
- Der Master-Datenpunkt hat den Werttyp
UINT(ein Trapper-Datenpunkt kann verwendet werden), der abhängige Datenpunkt hat den WerttypTEXT. - Für den Master- und den abhängigen Datenpunkt sind keine Vorverarbeitungsschritte erforderlich.
- Der Textwert (zum Beispiel „abc“) sollte an den Master-Datenpunkt übergeben werden.
- Da keine Vorverarbeitungsschritte ausgeführt werden müssen, prüft der Vorverarbeitungsmanager, ob sich der Master-Datenpunkt nicht im Zustand NICHT UNTERSTÜTZT befindet und ob ein Wert festgelegt ist (beides trifft zu), und reiht den abhängigen Datenpunkt mit demselben Wert wie den Master-Datenpunkt ein (da keine Vorverarbeitungsschritte vorhanden sind).
- Wenn sowohl der Master- als auch der abhängige Datenpunkt die Phase der Verlaufssynchronisierung erreichen, wechselt der Master-Datenpunkt aufgrund des Wertkonvertierungsfehlers in den Zustand NICHT UNTERSTÜTZT (Textdaten können nicht in eine vorzeichenlose Ganzzahl konvertiert werden).
- Der Master-Datenpunkt hat den Werttyp
Als Ergebnis empfängt der abhängige Datenpunkt einen Wert, während der Master-Datenpunkt seinen Zustand in NICHT UNTERSTÜTZT ändert.
- Ein abhängiger Datenpunkt empfängt einen Wert, der im Verlauf des Master-Datenpunkts nicht vorhanden ist.
Der Anwendungsfall ist dem vorherigen sehr ähnlich, mit Ausnahme des Typs des Master-Datenpunkts.
Wenn beispielsweise der Typ
CHARfür den Master-Datenpunkt verwendet wird, wird der Wert des Master-Datenpunkts in der Phase der Verlaufssynchronisierung abgeschnitten, während die abhängigen Datenpunkte ihre Werte aus dem ursprünglichen (nicht abgeschnittenen) Wert des Master-Datenpunkts erhalten.