
2 保存前処理の詳細
概要
このセクションでは、アイテムの値の前処理について説明します。 アイテムの値の前処理では、受信したアイテムの値に対して変換ルールを定義して実行できます。
前処理は、前処理の手順を実行する前処理ワーカーとともに、前処理マネージャープロセスによって管理されます。 さまざまなデータ収集プロセスから受信した前処理対象のすべての値(Zabbix 7.0.17より前はすべての値)は、ヒストリキャッシュに追加される前に前処理マネージャーを通過します。 データ収集プロセス(ポーラー、トラッパーなど)と前処理プロセスの間では、ソケットベースのIPC通信が使用されます。 前処理の手順は、ZabbixサーバーまたはZabbixプロキシ(プロキシが監視するアイテムの場合)が実行します。
アイテム値の処理
データソースからZabbixデータベースまでのデータフローを可視化するために、次の簡略化した図を使用できます。
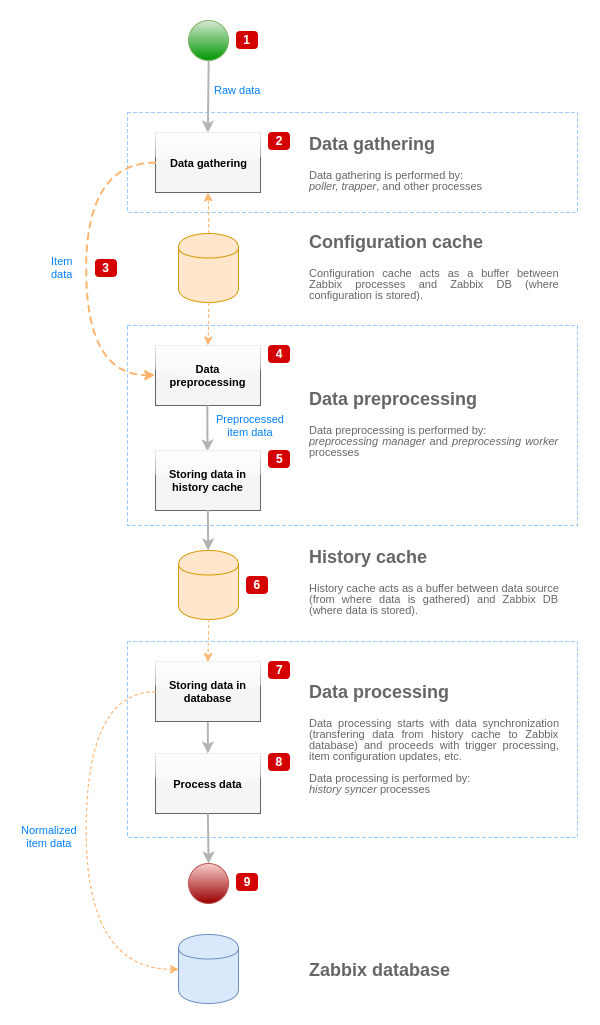
上の図では、アイテム値の処理に関連するプロセス、オブジェクト、アクションのみを簡略化して示しています。 条件による方向の変更、エラー処理、ループは示していません。 また、前処理マネージャーのローカルデータキャッシュも、データフローに直接影響しないため示していません。 この図の目的は、アイテム値の処理に関係するプロセスと、それらの相互作用を示すことです。
- データ収集は、データソースからの未加工データから始まります。 この時点で、データにはID、タイムスタンプ、値のみが含まれます(複数の値を含む場合もあります)。
- 使用するデータ収集方式の種類に関係なく、アクティブチェック、パッシブチェック、トラッパーアイテムなどで基本的な考え方は同じです。異なるのはデータ形式と通信の開始方法だけです(データ収集方式が接続とデータを待機するか、データ収集方式が通信を開始してデータを要求するかの違いです)。 未加工データが検証され、設定キャッシュからアイテム設定が取得されます(データに設定データが追加されます)。
- データ収集方式から前処理マネージャーへデータを渡すために、ソケットベースのIPCメカニズムが使用されます。 この時点で、データ収集方式は前処理マネージャーからの応答を待たずにデータ収集を続行します。
- データの前処理が実行されます。 これには、前処理ステップの実行と依存アイテムの処理が含まれます。
前処理中にいずれかの前処理ステップが失敗すると、アイテムの状態が「サポートされていません(NOT SUPPORTED)」に変わる場合があります。
- 前処理マネージャーのローカルデータキャッシュにある履歴データが、履歴キャッシュにフラッシュされます。
- この時点で、次回の履歴キャッシュの同期(履歴同期プロセスがデータ同期を実行するとき)までデータフローは停止します。
- 同期プロセスは、Zabbixデータベースにデータを保存する前に、データの正規化を行うことから始まります。
データの正規化では、目的のアイテムタイプ(アイテム設定で定義されたタイプ)への変換が実行されます。これには、各タイプで許可される定義済みのサイズに基づくテキストデータの切り詰めも含まれます(文字列の場合は
HISTORY_STR_VALUE_LEN、テキストの場合はHISTORY_TEXT_VALUE_LEN、ログ値の場合はHISTORY_LOG_VALUE_LEN)。 正規化が完了すると、データがZabbixデータベースに送信されます。
データの正規化に失敗した場合(たとえば、テキスト値を数値に変換できない場合)、アイテムの状態が「サポートされていません(NOT SUPPORTED)」に変わることがあります。
- 収集されたデータが処理されます。トリガーがチェックされ、アイテムが「サポートされていません(NOT SUPPORTED)」になるとアイテム設定が更新されるなどの処理が行われます。
- これは、アイテム値の処理という観点から見たデータフローの終点です。
アイテム値の前処理
データの前処理は、次の手順で実行されます。
- アイテムに前処理も依存アイテムもない場合、その値は履歴キャッシュに追加されるか、LLDマネージャーに送信されます。 それ以外の場合、アイテム値はUNIXソケットベースのIPCメカニズムを使用して前処理マネージャーに渡されます(Zabbix 7.0.17より前は、履歴キャッシュに追加されるかLLDマネージャーに送信される前に、すべての値が前処理マネージャーを経由します)。
- 前処理タスクが作成されてキューに追加され、前処理ワーカーに新しいタスクが通知されます。
- この時点で、空き状態(つまり、タスクを実行していない状態)の前処理ワーカーが少なくとも1つ存在するまで、データフローは停止します。
- 前処理ワーカーが使用可能になると、キューから次のタスクを取得します。
- 前処理が完了すると(前処理ステップの実行が失敗した場合も成功した場合も)、前処理済みの値が完了タスクキューに追加され、マネージャーに新しい完了タスクが通知されます。
- 前処理マネージャーは結果を目的の形式(アイテムの値のタイプで定義)に変換し、履歴キャッシュに追加するか、LLDマネージャーに送信します。
- 処理されたアイテムに依存アイテムがある場合、前処理済みのマスターアイテム値とともに、依存アイテムが前処理キューに追加されます。 依存アイテムは通常の値の前処理リクエストを経由せずにキューに追加されます。ただし、これは値が設定されていて、NOT SUPPORTED状態ではないマスターアイテムに限られます。
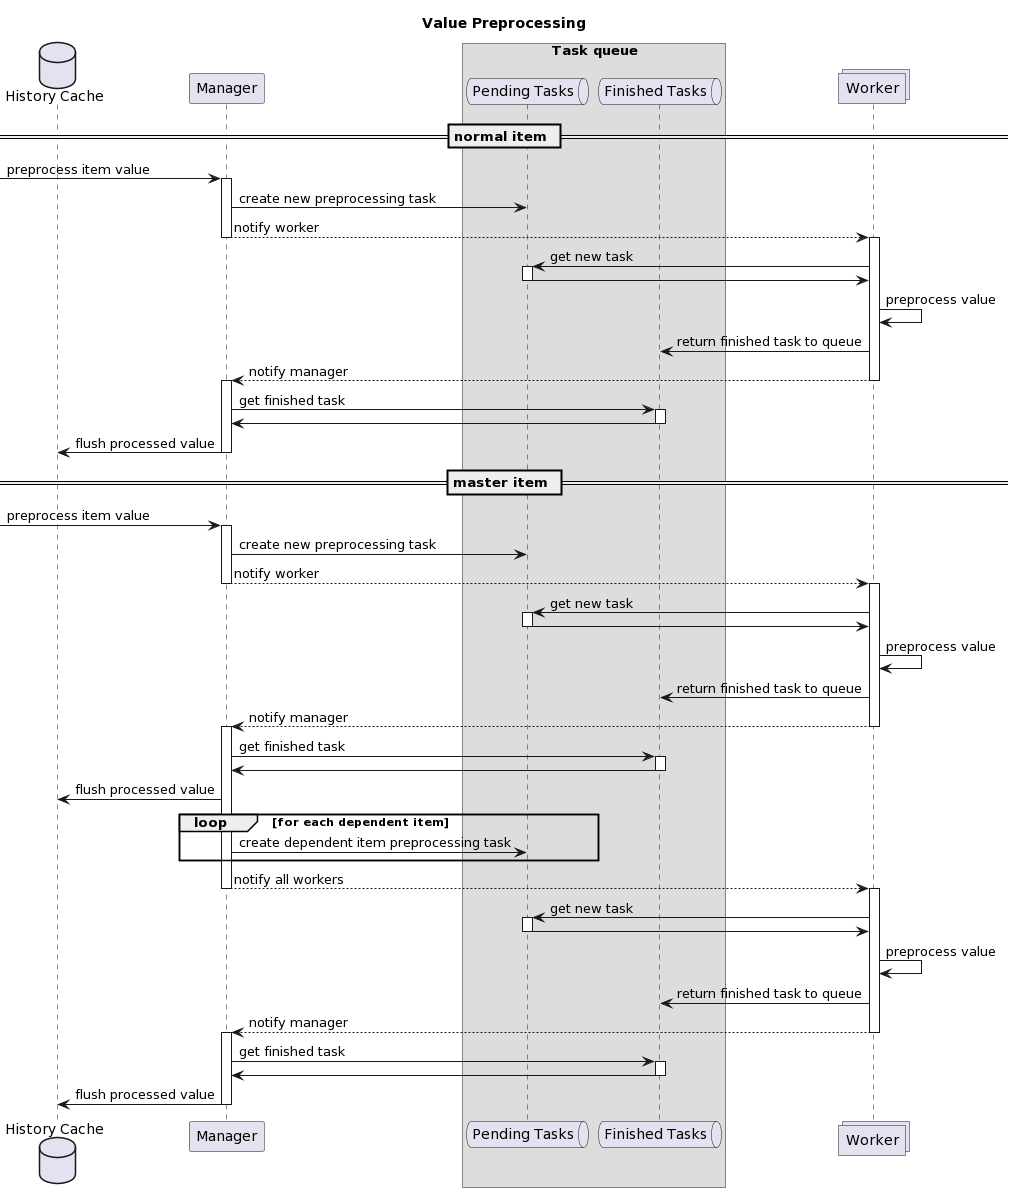
図では、前処理キャッシュを省略しているため、マスターアイテムの前処理が若干簡略化されている点に注意してください。
前処理キュー
前処理キューは次のように構成されています。
- 保留中のタスクのリスト:
- 受信した順序で、値の前処理リクエストから直接作成されたタスク
- 即時タスクのリスト(保留中のタスクより先に処理):
- テストタスク(Webインターフェースからのアイテム/前処理テストリクエストに応じて作成)
- 依存アイテムのタスク
- シーケンスタスク(厳密な順序で実行する必要があるタスク):
- 最新の値を使用する前処理ステップを含むもの:
- 変化
- スロットリング
- JavaScript(バイトコードキャッシュ)
- 依存アイテムの前処理キャッシュ
- 最新の値を使用する前処理ステップを含むもの:
- 完了したタスクのリスト
前処理のキャッシュ
前処理のキャッシュは、類似した前処理ステップを持つ複数の依存アイテム(LLDでよく発生します)の前処理パフォーマンスを向上させるために導入されました。
キャッシュは、1つの依存アイテムの前処理を実行し、内部の前処理データの一部を残りの依存アイテムで再利用することで行われます。 前処理キャッシュは、次のタイプの最初の前処理ステップでのみサポートされます。
- Prometheusパターン(メトリクスによって入力をインデックス化)
- JSONPath(データをオブジェクトツリーに解析し、最初の式
[?(@.path == "value")]をインデックス化)
プリプロセスワーカー
Zabbixサーバーの設定ファイルでは、プリプロセスワーカースレッド数を設定できます。 StartPreprocessors設定パラメータを使用して、あらかじめ起動しておくプリプロセスワーカーのインスタンス数を設定します。この数は、少なくとも利用可能なCPUコア数と一致させる必要があります。
プリプロセスのタスクがCPUバウンドではなく、ネットワーク要求を頻繁に実行する場合は、ワーカーを追加することを推奨します。 最適なプリプロセスワーカー数は、「プリプロセス可能な」アイテム(いずれかのプリプロセス手順の実行が必要なアイテム)の数、データ収集プロセス数、アイテムのプリプロセスにおける平均手順数など、多くの要因によって決まります。 ワーカー数が不足すると、メモリ使用量が増加する可能性があります。 Zabbix環境で過剰なメモリ使用量が発生した場合のトラブルシューティングについては、tcmallocを使用した過剰なメモリ使用量のプロファイリングを参照してください。
ただし、大規模なXML/JSONチャンクの解析など、負荷の高いプリプロセス処理がない場合は、プリプロセスワーカー数をデータ収集プロセスの合計数と一致させることができます。 これにより、(データ収集プロセスからデータが一括で送信される場合を除き)収集データに対して、ほとんどの場合、少なくとも1つの空きプリプロセスワーカーが確保されます。
IPMIマネージャー、SNMPトラッパー、プリプロセスワーカーと、多数のデータ収集プロセス(ポーラー、到達不能ポーラー、ODBCポーラー、HTTPポーラー、Javaポーラー、ピング、トラッパー、プロキシポーラー)を組み合わせると、プリプロセスマネージャーのプロセスごとのファイルディスクリプター上限を超える可能性があります。
プロセスごとのファイルディスクリプター上限を超えると、Zabbixサーバーが停止します。通常は起動直後に発生しますが、停止までに時間がかかる場合もあります。
このような問題を回避するには、Zabbixサーバーの設定ファイルを確認し、同時実行するチェック数とプロセス数を最適化してください。
また、必要に応じて、システムの上限を確認および調整し、ファイルディスクリプター上限が十分に高く設定されていることを確認してください。
値の処理パイプライン
アイテムの値の処理は、複数のプロセスによって複数のステップ(またはフェーズ)で実行されます。 これにより、次のようなことが発生する可能性があります。
- 依存アイテムは値を受信できる一方で、マスター値は受信できない。
これは、次のユースケースで実現できます。
- マスターアイテムの値のタイプが
UINT(トラッパーアイテムを使用可能)で、依存アイテムの値のタイプがTEXTである。 - マスターアイテムと依存アイテムの両方に前処理ステップが必要ない。
- テキスト値(例: "abc")をマスターアイテムに渡す。
- 実行する前処理ステップがないため、前処理マネージャーはマスターアイテムが NOT SUPPORTED 状態ではなく、値が設定されているかを確認します(どちらも条件を満たします)。その後、マスターアイテムと同じ値を持つ依存アイテムをキューに追加します(前処理ステップがないため)。
- マスターアイテムと依存アイテムの両方が履歴同期フェーズに到達すると、値の変換エラー(テキストデータを符号なし整数に変換できない)のため、マスターアイテムは NOT SUPPORTED になります。
- マスターアイテムの値のタイプが
結果として、依存アイテムは値を受信しますが、マスターアイテムの状態は NOT SUPPORTED に変わります。
- 依存アイテムが、マスターアイテムの履歴に存在しない値を受信する。
このユースケースは、マスターアイテムのタイプを除いて、前の例と非常によく似ています。
たとえば、マスターアイテムに
CHARタイプを使用した場合、履歴同期フェーズでマスターアイテムの値は切り捨てられます。一方、依存アイテムは、マスターアイテムの初期値(切り捨て前の値)から値を受信します。