
2 预处理详情
概述
本节介绍监控项值预处理的详细信息。 监控项值预处理允许为接收到的监控项值定义并执行转换规则。
预处理由预处理管理器进程负责管理,并由预处理工作进程执行预处理步骤。 来自不同数据收集器的所有经过预处理的值(在 Zabbix 7.0.17 之前为所有值)都会先经过预处理管理器,然后再添加到历史记录缓存中。 数据收集器(轮询器、捕获器等)与预处理进程之间使用基于套接字的 IPC 通信。 预处理步骤由 Zabbix 服务器或 Zabbix proxy(对于由 proxy 监控的监控项)执行。
监控项值处理
要直观地展示从数据源到 Zabbix 数据库的数据流,我们可以使用以下简化图示:
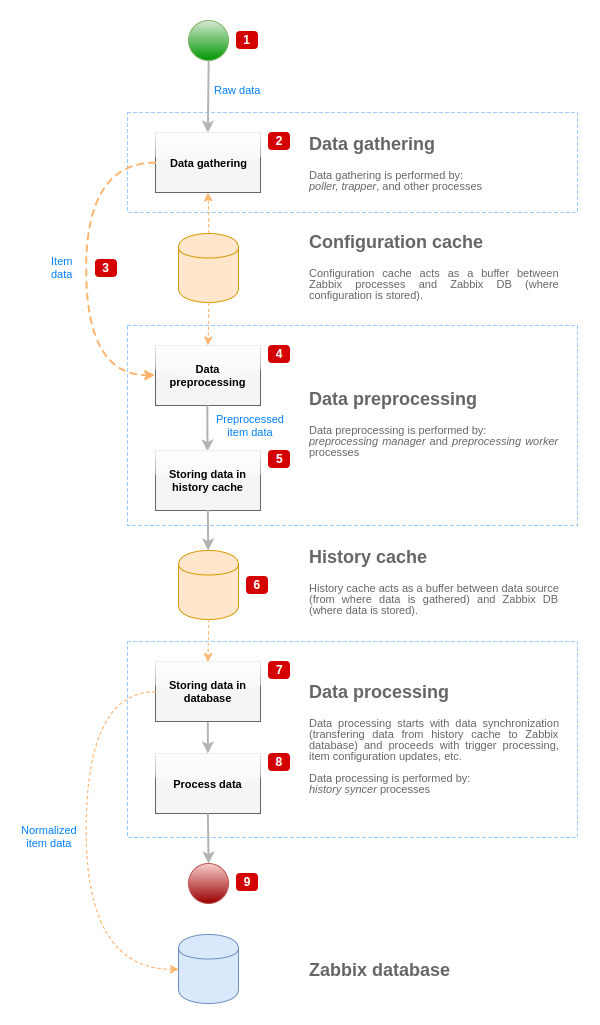
上图仅以简化形式展示了与监控项值处理相关的进程、对象和操作。 该图未展示条件性方向变化、错误处理或循环。 预处理管理器的本地数据缓存也未显示,因为它不会直接影响数据流。 此图旨在展示监控项值处理中涉及的进程及其交互方式。
- 数据采集从数据源提供的原始数据开始。 此时,数据仅包含 ID、时间戳和值(也可以包含多个值)。
- 无论使用哪种类型的数据采集器,主动检查、被动检查、trapper 监控项等的处理原理都是相同的,因为它们的区别仅在于数据格式和通信发起方(数据采集器等待连接和数据,或者数据采集器发起通信并请求数据)。 系统会验证原始数据,并从配置缓存中获取监控项配置(使用配置数据丰富数据)。
- 系统使用基于套接字的 IPC 机制,将数据从数据采集器传递到预处理管理器。 此时,数据采集器会继续采集数据,而无需等待预处理管理器的响应。
- 执行数据预处理。 这包括执行预处理步骤和处理依赖监控项。
如果任何预处理步骤失败,监控项可能会在执行预处理期间将其状态更改为 NOT SUPPORTED。
- 预处理管理器本地数据缓存中的历史数据会被刷新到历史缓存中。
- 此时数据流会暂停,直到历史缓存进行下一次同步(即历史同步器进程执行数据同步时)。
- 同步过程首先会对数据进行规范化,然后将数据存储到 Zabbix 数据库中。
数据规范化会将数据转换为所需的监控项类型(监控项配置中定义的类型),其中包括根据这些类型允许的预定义大小截断文本数据(字符串使用
HISTORY_STR_VALUE_LEN,文本使用HISTORY_TEXT_VALUE_LEN,日志值使用HISTORY_LOG_VALUE_LEN)。 完成规范化后,数据会被发送到 Zabbix 数据库。
如果数据规范化失败,监控项可能会将其状态更改为 NOT SUPPORTED(例如,文本值无法转换为数字时)。
- 系统会处理采集到的数据,包括检查触发器、在监控项变为 NOT SUPPORTED 时更新监控项配置等。
- 从监控项值处理的角度来看,这被视为数据流的结束。
监控项值预处理
数据预处理按以下步骤执行:
- 如果监控项既没有预处理,也没有依赖监控项,则其值会被添加到历史记录缓存,或发送到 LLD 管理器。 否则,监控项值会通过基于 UNIX 套接字的 IPC 机制传递给预处理管理器(在 Zabbix 7.0.17 之前,所有值都会先经过预处理管理器,然后再添加到历史记录缓存或发送到 LLD 管理器)。
- 创建预处理任务并将其添加到队列,同时通知预处理工作进程有新任务。
- 此时数据流会暂停,直到至少有一个空闲的(即未执行任何任务的)预处理工作进程。
- 预处理工作进程可用后,会从队列中获取下一个任务。
- 预处理完成后(无论预处理步骤执行失败还是成功),预处理后的值都会被添加到已完成任务队列,并通知管理器有新的已完成任务。
- 预处理管理器会将结果转换为所需格式(由监控项值类型定义),然后将其添加到历史记录缓存,或发送到 LLD 管理器。
- 如果已处理的监控项存在依赖监控项,则会将依赖监控项连同预处理后的主监控项值一起添加到预处理队列。 依赖监控项会绕过常规值预处理请求直接进入队列,但仅适用于已设置值且不处于 NOT SUPPORTED 状态的主监控项。

请注意,图中对主监控项预处理进行了简化,省略了预处理缓存步骤。
预处理队列
预处理队列的组织方式如下:
- 待处理任务列表:
- 按接收顺序直接根据监控项值预处理请求创建的任务
- 即时任务列表(在待处理任务之前处理):
- 测试任务(前端响应监控项/预处理测试请求而创建)
- 依赖监控项任务
- 序列任务(必须严格按顺序执行的任务):
- 使用最新值的预处理步骤:
- 变化
- 限流
- JavaScript(字节码缓存)
- 依赖监控项预处理缓存
- 使用最新值的预处理步骤:
- 已完成任务列表
预处理缓存
引入预处理缓存是为了提升多个具有相似预处理步骤的依赖监控项的预处理性能(这是 LLD 的常见结果)。
缓存通过对一个依赖监控项执行预处理,并将部分内部预处理数据复用于其余依赖监控项来实现。 预处理缓存仅支持以下类型的第一个预处理步骤:
- Prometheus 模式(按指标为输入建立索引)
- JSONPath(将数据解析为对象树,并为第一个表达式
[?(@.path == "value")]建立索引)
预处理工作进程
Zabbix 服务器配置文件允许用户设置预处理工作线程的数量。 应使用 StartPreprocessors 配置参数设置预先启动的预处理工作进程实例数量,该数量至少应与可用 CPU 核心数相匹配。
如果预处理任务不受 CPU 限制,并且涉及频繁的网络请求,建议配置更多工作进程。 预处理工作进程的最佳数量取决于许多因素,包括“可预处理”监控项的数量(需要执行任意预处理步骤的监控项)、数据采集进程的数量、监控项预处理的平均步骤数等。 工作进程数量不足可能导致内存使用率过高。 有关排查 Zabbix 安装中内存使用率过高的问题,请参阅使用 tcmalloc 分析过高的内存使用率。
但是,假设不存在解析大型 XML/JSON 数据块等高负载预处理操作,预处理工作进程的数量可以与数据采集进程的总数相匹配。 这样,对于采集的数据,通常(采集进程批量传入数据的情况除外)至少会有一个空闲的预处理工作进程。
过多的数据采集进程(轮询器、不可达轮询器、ODBC 轮询器、HTTP 轮询器、Java 轮询器、ping 进程、捕获器、proxy 轮询器)与 IPMI 管理器、SNMP trapper 和预处理工作进程一起运行时,可能耗尽预处理管理器的每进程文件描述符限制。
耗尽每进程文件描述符限制将导致 Zabbix 服务器停止运行,通常发生在启动后不久,但有时可能需要更长时间。
为避免此类问题,请查看 Zabbix 服务器配置文件,优化并发检查和进程数量。
此外,如有必要,请通过检查和调整系统限制,确保文件描述符限制设置得足够高。
值处理流程
监控项值处理由多个进程分多个步骤(或阶段)执行。 这可能导致:
- 依赖监控项可以接收值,而主监控项无法接收值。
可以通过以下用例实现:
- 主监控项的值类型为
UINT(可以使用 trapper 监控项),依赖监控项的值类型为TEXT。 - 主监控项和依赖监控项均不需要预处理步骤。
- 应将文本值(例如 "abc")传递给主监控项。
- 由于没有要执行的预处理步骤,预处理管理器会检查主监控项是否不处于 NOT SUPPORTED 状态,以及是否已设置值(两者均为 true),然后将依赖监控项加入队列,并使用与主监控项相同的值(因为没有预处理步骤)。
- 当主监控项和依赖监控项都到达历史数据同步阶段时,主监控项会因值转换错误而变为 NOT SUPPORTED(文本数据无法转换为无符号整数)。
- 主监控项的值类型为
因此,依赖监控项会接收到一个值,而主监控项的状态会变为 NOT SUPPORTED。
- 依赖监控项接收到的值不存在于主监控项的历史数据中。
此用例与前一个用例非常相似,不同之处在于主监控项的类型。
例如,如果主监控项使用
CHAR类型,则主监控项的值会在历史数据同步阶段被截断,而依赖监控项会从主监控项的初始值(未截断)中获取其值。