
2. Дополнительные сведения о предобработке
Обзор
В этом разделе приведены сведения о предварительной обработке значений элементов данных. Предварительная обработка значений элементов данных позволяет определять и выполнять правила преобразования для полученных значений элементов данных.
Предварительная обработка управляется процессом диспетчера предварительной обработки и рабочими процессами предварительной обработки, которые выполняют этапы предварительной обработки. Все значения, для которых выполняется предварительная обработка (до Zabbix 7.0.17 — все значения), полученные от разных сборщиков данных, проходят через диспетчер предварительной обработки перед добавлением в кэш истории. Для взаимодействия между сборщиками данных (опросчиками, трапперами и т. д.) и процессом предварительной обработки используется обмен данными между процессами через сокеты. Этапы предварительной обработки выполняет либо сервер Zabbix, либо прокси Zabbix (для элементов данных, которые отслеживаются прокси).
Обработка значений элементов данных
Для визуализации потока данных от источника данных к базе данных Zabbix можно использовать следующую упрощенную диаграмму:
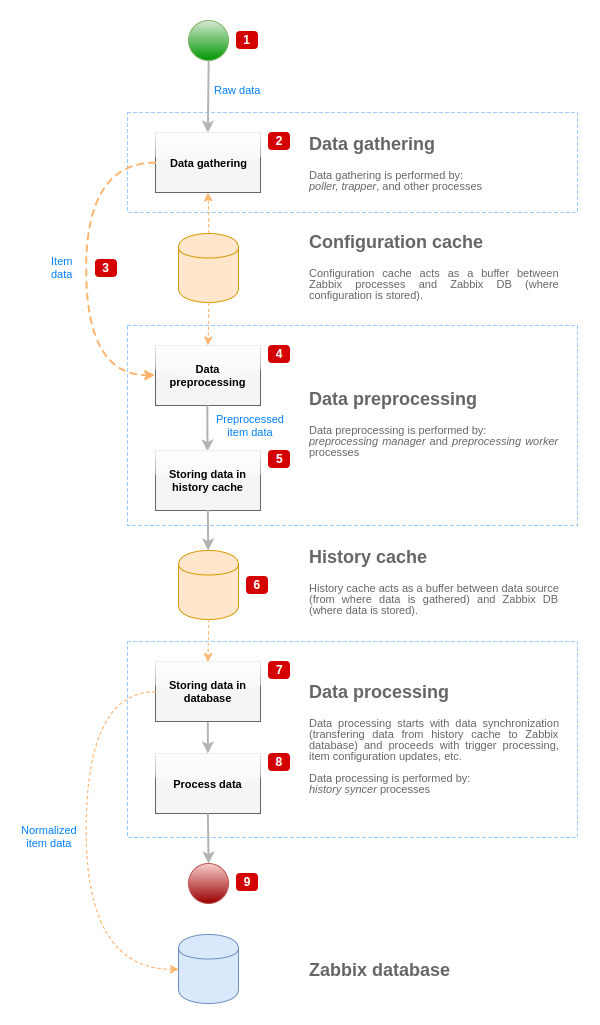
На приведенной выше диаграмме в упрощенном виде показаны только процессы, объекты и действия, связанные с обработкой значений элементов данных. На диаграмме не показаны условные изменения направления, обработка ошибок и циклы. Локальный кэш данных менеджера предварительной обработки также не показан, поскольку он напрямую не влияет на поток данных. Цель этой диаграммы - показать процессы, участвующие в обработке значений элементов данных, и способ их взаимодействия.
- Сбор данных начинается с необработанных данных из источника данных. На этом этапе данные содержат только идентификатор, временную метку и значение (значений также может быть несколько).
- Независимо от используемого типа сборщика данных принцип остается одинаковым для активных или пассивных проверок, элементов данных типа «траппер» и т. д., поскольку изменяются только формат данных и инициатор обмена данными (сборщик данных либо ожидает подключения и данных, либо инициирует обмен данными и запрашивает данные). Необработанные данные проверяются, а конфигурация элемента данных извлекается из кэша конфигурации (данные дополняются данными конфигурации).
- Для передачи данных от сборщиков данных менеджеру предварительной обработки используется механизм IPC на основе сокетов. На этом этапе сборщик данных продолжает собирать данные, не дожидаясь ответа от менеджера предварительной обработки.
- Выполняется предварительная обработка данных. Она включает выполнение шагов предварительной обработки и обработку зависимых элементов данных.
Элемент данных может изменить свое состояние на NOT SUPPORTED во время предварительной обработки, если какой-либо шаг предварительной обработки завершится ошибкой.
- Данные истории из локального кэша данных менеджера предварительной обработки записываются в кэш истории.
- На этом этапе поток данных останавливается до следующей синхронизации кэша истории (когда процесс синхронизации истории выполняет синхронизацию данных).
- Процесс синхронизации начинается с нормализации данных перед их сохранением в базе данных Zabbix.
Нормализация данных выполняет преобразование в требуемый тип элемента данных (тип, определенный в конфигурации элемента данных), включая усечение текстовых данных в соответствии с предопределенными размерами, разрешенными для этих типов (
HISTORY_STR_VALUE_LENдля строковых значений,HISTORY_TEXT_VALUE_LENдля текстовых значений иHISTORY_LOG_VALUE_LENдля значений журнала). После завершения нормализации данные отправляются в базу данных Zabbix.
Элемент данных может изменить свое состояние на NOT SUPPORTED, если нормализация данных завершится ошибкой (например, если текстовое значение невозможно преобразовать в число).
- Собранные данные обрабатываются: проверяются триггеры, обновляется конфигурация элемента данных, если элемент данных становится NOT SUPPORTED, и т. д.
- С точки зрения обработки значений элементов данных это считается концом потока данных.
Предобработка значения элемента данных
Предобработка данных выполняется в следующие этапы:
- Если для элемента данных не настроены ни предобработка, ни зависимые элементы данных, его значение добавляется в кэш истории или отправляется диспетчеру НСД. В противном случае значение элемента данных передается диспетчеру предобработки с использованием механизма IPC на основе UNIX-сокетов (до Zabbix 7.0.17 все значения перед добавлением в кэш истории или отправкой диспетчеру НСД передаются через диспетчер предобработки).
- Создается задача предобработки, добавляется в очередь, а рабочие процессы предобработки уведомляются о новой задаче.
- На этом этапе поток данных останавливается до тех пор, пока не появится хотя бы один свободный рабочий процесс предобработки (то есть рабочий процесс, не выполняющий никаких задач).
- Когда рабочий процесс предобработки становится доступен, он извлекает из очереди следующую задачу.
- После завершения предобработки (как при успешном, так и при неуспешном выполнении этапов предобработки) обработанное значение добавляется в очередь завершенных задач, а диспетчер уведомляется о новой завершенной задаче.
- Диспетчер предобработки преобразует результат в требуемый формат (определяемый типом значения элемента данных) и либо добавляет его в кэш истории, либо отправляет диспетчеру НСД.
- Если для обработанного элемента данных существуют зависимые элементы данных, они добавляются в очередь предобработки вместе с обработанным значением главного элемента данных. Зависимые элементы данных помещаются в очередь в обход обычных запросов на предобработку значений, но только для главных элементов данных, для которых задано значение и которые не находятся в состоянии NOT SUPPORTED.

Обратите внимание, что на диаграмме предобработка главного элемента данных немного упрощена: кэширование результатов предобработки не показано.
Очередь предварительной обработки
Очередь предварительной обработки организована следующим образом:
- список ожидающих задач:
- задачи, созданные непосредственно из запросов на предварительную обработку значений, в порядке их получения
- список немедленных задач (обрабатываются перед ожидающими задачами):
- задачи тестирования (создаются в ответ на запросы веб-интерфейса на тестирование элементов данных/предварительной обработки)
- задачи зависимых элементов данных
- последовательные задачи (задачи, которые должны выполняться в строгом порядке):
- использующие шаги предварительной обработки с последним значением:
- изменение
- ограничение частоты
- JavaScript (кэширование байт-кода)
- кэширование предварительной обработки зависимых элементов данных
- использующие шаги предварительной обработки с последним значением:
- список завершенных задач
Кэширование предварительной обработки
Кэширование предварительной обработки было введено для повышения производительности предварительной обработки нескольких зависимых элементов данных с похожими шагами предварительной обработки (что часто является результатом LLD).
Кэширование выполняется путем предварительной обработки одного зависимого элемента данных и повторного использования некоторых внутренних данных предварительной обработки для остальных зависимых элементов данных. Кэш предварительной обработки поддерживается только для первого шага предварительной обработки следующих типов:
- Шаблон Prometheus (индексирует входные данные по метрикам)
- JSONPath (анализирует данные в дерево объектов и индексирует первое выражение
[?(@.path == "value")])
Рабочие процессы предварительной обработки
Файл конфигурации сервера Zabbix позволяет задать количество потоков рабочих процессов предварительной обработки. Для задания количества предварительно запущенных экземпляров рабочих процессов предварительной обработки следует использовать параметр конфигурации StartPreprocessors. Это количество должно как минимум соответствовать числу доступных ядер ЦП.
Если задачи предварительной обработки не требуют значительных ресурсов ЦП и включают частые сетевые запросы, рекомендуется настроить дополнительные рабочие процессы. Оптимальное количество рабочих процессов предварительной обработки зависит от многих факторов, включая количество «обрабатываемых» элементов данных (элементов данных, для которых требуется выполнить какие-либо шаги предварительной обработки), количество процессов сбора данных, среднее количество шагов предварительной обработки элементов данных и т. д. Недостаточное количество рабочих процессов может привести к высокому потреблению памяти. Для устранения неполадок, связанных с чрезмерным потреблением памяти в вашей установке Zabbix, см. раздел Профилирование чрезмерного потребления памяти с помощью tcmalloc.
Однако при условии отсутствия ресурсоемких операций предварительной обработки, таких как разбор больших фрагментов XML/JSON, количество рабочих процессов предварительной обработки может соответствовать общему количеству процессов сбора данных. В этом случае для собранных данных в основном (за исключением случаев, когда данные от процесса сбора поступают пакетами) будет доступен как минимум один незанятый рабочий процесс предварительной обработки.
Слишком большое количество процессов сбора данных (опросчиков, опросчиков недоступных узлов сети, опросчиков ODBC, HTTP-опросчиков, Java-опросчиков, проверяющих доступность, трапперов, опросчиков прокси) вместе с менеджером IPMI, траппером SNMP и рабочими процессами предварительной обработки может исчерпать установленный для каждого процесса лимит файловых дескрипторов менеджера предварительной обработки.
Исчерпание установленного для каждого процесса лимита файловых дескрипторов приведет к остановке сервера Zabbix, обычно вскоре после запуска, но иногда это может занять больше времени.
Чтобы избежать подобных проблем, проверьте файл конфигурации сервера Zabbix, чтобы оптимизировать количество параллельных проверок и процессов.
Кроме того, при необходимости убедитесь, что лимит файловых дескрипторов достаточно высок, проверив и скорректировав системные ограничения.
Конвейер обработки значений
Обработка значений элементов данных выполняется в несколько шагов (или фаз) несколькими процессами. Это может привести к следующему:
- Зависимый элемент данных может получить значения, в то время как значение ГЛАВНОГО элемента данных не может быть сохранено.
Этого можно добиться в следующем случае:
- Главный элемент данных имеет тип значения
UINT(можно использовать элемент данных типа «траппер»), а зависимый элемент данных — тип значенияTEXT. - Для главного и зависимого элементов данных не требуются шаги предварительной обработки.
- Текстовое значение (например, «abc») передается главному элементу данных.
- Поскольку шаги предварительной обработки отсутствуют, менеджер предварительной обработки проверяет, что главный элемент данных не находится в состоянии NOT SUPPORTED и что значение задано (оба условия выполняются), а затем ставит зависимый элемент данных в очередь с тем же значением, что и у главного элемента данных (поскольку шаги предварительной обработки отсутствуют).
- Когда главный и зависимый элементы данных достигают фазы синхронизации истории, главный элемент данных переходит в состояние NOT SUPPORTED из-за ошибки преобразования значения (текстовые данные нельзя преобразовать в беззнаковое целое число).
- Главный элемент данных имеет тип значения
В результате зависимый элемент данных получает значение, а главный элемент данных изменяет свое состояние на NOT SUPPORTED.
- Зависимый элемент данных получает значение, отсутствующее в истории главного элемента данных.
Этот сценарий очень похож на предыдущий, за исключением типа главного элемента данных.
Например, если для главного элемента данных используется тип
CHAR, его значение будет усечено на этапе синхронизации истории, тогда как зависимые элементы данных получат свои значения из исходного (неусеченного) значения главного элемента данных.