
2 Detalles del preprocesamiento
Descripción general
Esta sección proporciona información detallada sobre el preprocesamiento de los valores de los item. El preprocesamiento de los valores de los item permite definir y ejecutar reglas de transformación para los valores de los item recibidos.
El preprocesamiento es gestionado por el proceso de gestión del preprocesamiento, junto con los workers de preprocesamiento que ejecutan los pasos de preprocesamiento. Todos los valores con preprocesamiento (antes de Zabbix 7.0.17, todos los valores) recibidos de diferentes recopiladores de datos pasan por el proceso de gestión del preprocesamiento antes de añadirse a la caché de historial. La comunicación IPC basada en sockets se utiliza entre los recopiladores de datos (pollers, trappers, etc.) y el proceso de preprocesamiento. El server de Zabbix o el proxy de Zabbix (para los item supervisados por el proxy) ejecuta los pasos de preprocesamiento.
Procesamiento del valor del item
Para visualizar el flujo de datos desde el origen de datos hasta la base de datos de Zabbix, podemos utilizar el siguiente diagrama simplificado:
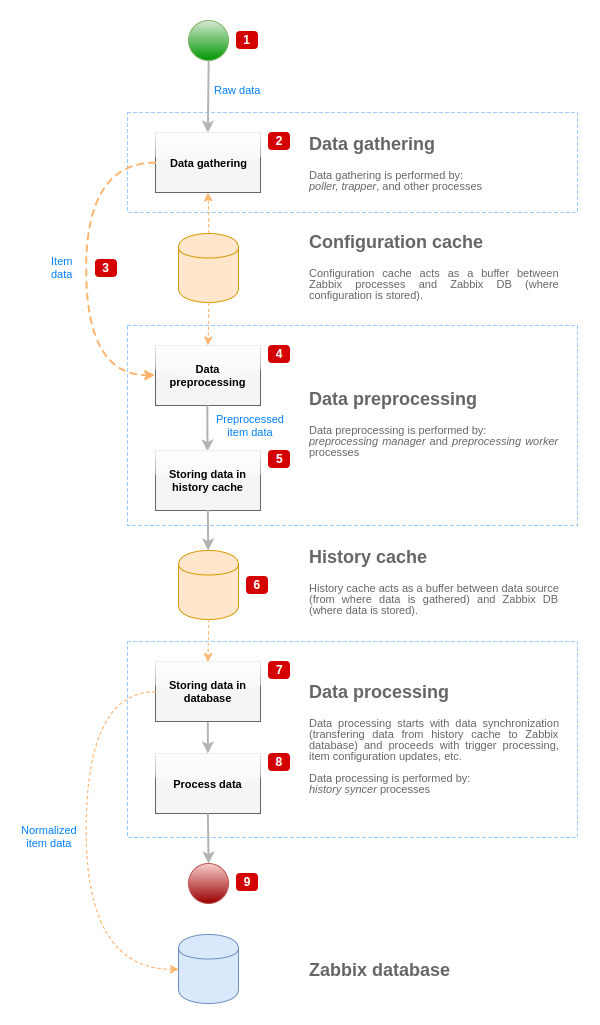
El diagrama anterior muestra únicamente los procesos, objetos y acciones relacionados con el procesamiento del valor del item de forma simplificada.
El diagrama no muestra los cambios de dirección condicionales, el manejo de errores ni los bucles.
Tampoco se muestra la caché de datos local del gestor de preprocesamiento, ya que no afecta directamente al flujo de datos.
El objetivo de este diagrama es mostrar los procesos involucrados en el procesamiento del valor del item y la forma en que interactúan.
- La recopilación de datos comienza con datos sin procesar procedentes de un origen de datos.
En este punto, los datos contienen únicamente el ID, la marca de tiempo y el valor (también pueden contener varios valores). - Independientemente del tipo de recopilador de datos utilizado, la idea es la misma para las comprobaciones activas o pasivas, para los items trapper, etc., ya que solo cambia el formato de los datos y quién inicia la comunicación (el recopilador de datos espera una conexión y los datos, o bien inicia la comunicación y solicita los datos).
Los datos sin procesar se validan y la configuración del item se recupera de la caché de configuración (los datos se enriquecen con los datos de configuración). - Se utiliza un mecanismo IPC basado en sockets para pasar los datos de los recopiladores de datos al gestor de preprocesamiento.
En este punto, el recopilador de datos continúa recopilando datos sin esperar la respuesta del gestor de preprocesamiento. - Se realiza el preprocesamiento de los datos.
Esto incluye la ejecución de los pasos de preprocesamiento y el procesamiento de items dependientes.
Un item puede cambiar su estado a NOT SUPPORTED durante el preprocesamiento si alguno de los pasos de preprocesamiento falla.
- Los datos de historial de la caché de datos local del gestor de preprocesamiento se vacían en la caché de historial.
- En este punto, el flujo de datos se detiene hasta la siguiente sincronización de la caché de historial (cuando el proceso de sincronización del historial realiza la sincronización de datos).
- El proceso de sincronización comienza con la normalización de los datos antes de almacenarlos en la base de datos de Zabbix.
La normalización de datos realiza conversiones al tipo de item deseado (el tipo definido en la configuración del item), incluido el truncamiento de los datos textuales según los tamaños predefinidos permitidos para esos tipos (HISTORY_STR_VALUE_LENpara cadenas,HISTORY_TEXT_VALUE_LENpara texto yHISTORY_LOG_VALUE_LENpara valores de registro).
Los datos se envían a la base de datos de Zabbix una vez finalizada la normalización.
Un item puede cambiar su estado a NOT SUPPORTED si la normalización de datos falla (por ejemplo, cuando un valor textual no se puede convertir en un número).
- Los datos recopilados se procesan: se comprueban los triggers, se actualiza la configuración del item si el item pasa a estar NOT SUPPORTED, etc.
- Desde el punto de vista del procesamiento del valor del item, este se considera el final del flujo de datos.
Preprocesamiento del valor del item
El preprocesamiento de datos se realiza en los siguientes pasos:
- Si el item no tiene ni preprocesamiento ni items dependientes, su valor se añade a la caché del historial o se envía al gestor de LLD. De lo contrario, el valor del item se pasa al gestor de preprocesamiento mediante un mecanismo IPC basado en sockets UNIX (antes de Zabbix 7.0.17, todos los valores se pasaban por el gestor de preprocesamiento antes de añadirse a la caché del historial o enviarse al gestor de LLD).
- Se crea una tarea de preprocesamiento, se añade a la cola y se notifica a los workers de preprocesamiento sobre la nueva tarea.
- En este punto, el flujo de datos se detiene hasta que haya al menos un worker de preprocesamiento libre (es decir, que no esté ejecutando ninguna tarea).
- Cuando hay un worker de preprocesamiento disponible, toma la siguiente tarea de la cola.
- Una vez finalizado el preprocesamiento (tanto si la ejecución de los pasos de preprocesamiento falla como si se realiza correctamente), el valor preprocesado se añade a la cola de tareas finalizadas y se notifica al gestor sobre una nueva tarea finalizada.
- El gestor de preprocesamiento convierte el resultado al formato deseado (definido por el tipo de valor del item) y lo añade a la caché del historial o lo envía al gestor de LLD.
- Si existen items dependientes del item procesado, los items dependientes se añaden a la cola de preprocesamiento con el valor preprocesado del item maestro. Los items dependientes se ponen en cola omitiendo las solicitudes normales de preprocesamiento de valores, pero solo para items maestros cuyo valor esté establecido y que no se encuentren en estado NOT SUPPORTED.

Tenga en cuenta que, en el diagrama, el preprocesamiento del item maestro está ligeramente simplificado, ya que se omite la caché del preprocesamiento.
Cola de preprocesamiento
La cola de preprocesamiento está organizada de la siguiente manera:
- la lista de tareas pendientes:
- tareas creadas directamente a partir de solicitudes de preprocesamiento de valores, en el orden en que se recibieron
- la lista de tareas inmediatas (procesadas antes que las tareas pendientes):
- tareas de prueba (creadas en respuesta a solicitudes de prueba de item/preprocesamiento realizadas desde el frontend)
- tareas de item dependientes
- tareas secuenciales (tareas que deben ejecutarse en un orden estricto):
- que tienen pasos de preprocesamiento que utilizan el último valor:
- cambio
- limitación
- JavaScript (almacenamiento en caché del bytecode)
- almacenamiento en caché del preprocesamiento de items dependientes
- que tienen pasos de preprocesamiento que utilizan el último valor:
- la lista de tareas finalizadas
Caché de preprocesamiento
El almacenamiento en caché del preprocesamiento se introdujo para mejorar el rendimiento del preprocesamiento de varios items dependientes que tienen pasos de preprocesamiento similares (un resultado común de LLD).
El almacenamiento en caché se realiza mediante el preprocesamiento de un item dependiente y la reutilización de algunos datos internos de preprocesamiento para el resto de los items dependientes. La caché de preprocesamiento solo es compatible con el primer paso de preprocesamiento de los siguientes tipos:
- Patrón de Prometheus (indexa la entrada por métricas)
- JSONPath (analiza los datos en un árbol de objetos e indexa la primera expresión
[?(@.path == "value")])
Trabajadores de preprocesamiento
El archivo de configuración del Zabbix server permite establecer la cantidad de hilos de trabajadores de preprocesamiento. Debe utilizarse el parámetro de configuración StartPreprocessors para establecer el número de instancias de trabajadores de preprocesamiento iniciadas previamente, que debe coincidir como mínimo con el número de núcleos de CPU disponibles.
Si las tareas de preprocesamiento no están limitadas por la CPU e implican solicitudes de red frecuentes, se recomienda configurar trabajadores adicionales. El número óptimo de trabajadores de preprocesamiento puede determinarse en función de muchos factores, incluido el número de items "preprocesables" (items que requieren la ejecución de cualquier paso de preprocesamiento), el número de procesos de recopilación de datos, el número promedio de pasos del preprocesamiento de los items, etc. Un número insuficiente de trabajadores puede provocar un uso elevado de memoria. Para solucionar problemas relacionados con un uso excesivo de memoria en su instalación de Zabbix, consulte Perfilado del uso excesivo de memoria con tcmalloc.
Sin embargo, suponiendo que no haya operaciones de preprocesamiento pesadas, como el análisis de grandes fragmentos XML/JSON, el número de trabajadores de preprocesamiento puede coincidir con el número total de recopiladores de datos. De este modo, habrá principalmente (excepto en los casos en que los datos del recopilador lleguen en bloque) al menos un trabajador de preprocesamiento desocupado para los datos recopilados.
Demasiados procesos de recopilación de datos (pollers, pollers inaccesibles, pollers ODBC, pollers HTTP, pollers Java, pingers, trappers, proxypollers), junto con el administrador de IPMI, el trapper SNMP y los trabajadores de preprocesamiento, pueden agotar el límite de descriptores de archivo por proceso del administrador de preprocesamiento.
Agotar el límite de descriptores de archivo por proceso hará que el Zabbix server se detenga, normalmente poco después del inicio, aunque en algunos casos puede tardar más.
Para evitar estos problemas, revise el archivo de configuración del Zabbix server para optimizar el número de comprobaciones y procesos simultáneos.
Además, si es necesario, asegúrese de que el límite de descriptores de archivo sea suficientemente alto comprobando y ajustando los límites del sistema.
Canalización del procesamiento de valores
El procesamiento de los valores de los item se ejecuta en varios pasos (o fases) mediante varios procesos. Esto puede provocar lo siguiente:
- Un item dependiente puede recibir valores, mientras que el valor del item maestro no puede recibirse.
Esto se puede lograr mediante el siguiente caso de uso:
- El item maestro tiene el tipo de valor
UINT(se puede utilizar un item trapper), mientras que el item dependiente tiene el tipo de valorTEXT. - No se requieren pasos de preprocesamiento para los item maestro y dependiente.
- Se debe pasar un valor textual (por ejemplo, "abc") al item maestro.
- Como no hay pasos de preprocesamiento que ejecutar, el gestor de preprocesamiento comprueba si el item maestro no se encuentra en estado NOT SUPPORTED y si el valor está establecido (ambas condiciones se cumplen), y pone en cola el item dependiente con el mismo valor que el item maestro (ya que no hay pasos de preprocesamiento).
- Cuando los item maestro y dependiente llegan a la fase de sincronización del historial, el item maestro pasa a estar NOT SUPPORTED debido al error de conversión del valor (los datos textuales no se pueden convertir en un entero sin signo).
- El item maestro tiene el tipo de valor
Como resultado, el item dependiente recibe un valor, mientras que el item maestro cambia su estado a NOT SUPPORTED.
- Un item dependiente recibe un valor que no está presente en el historial del item maestro.
El caso de uso es muy similar al anterior, excepto por el tipo del item maestro.
Por ejemplo, si se utiliza el tipo
CHARpara el item maestro, su valor se truncará en la fase de sincronización del historial, mientras que los item dependientes recibirán sus valores del valor inicial (sin truncar) del item maestro.