
2 Dettagli di preelaborazione
Panoramica
Questa sezione fornisce dettagli sulla pre-elaborazione dei valori degli item. La pre-elaborazione dei valori degli item consente di definire ed eseguire regole di trasformazione per i valori degli item ricevuti.
La pre-elaborazione è gestita dal processo di gestione della pre-elaborazione insieme ai worker di pre-elaborazione che eseguono le fasi di pre-elaborazione. Tutti i valori con pre-elaborazione (prima di Zabbix 7.0.17, tutti i valori), ricevuti da diversi raccoglitori di dati, passano attraverso il gestore della pre-elaborazione prima di essere aggiunti alla cache della cronologia. La comunicazione IPC basata su socket viene utilizzata tra i raccoglitori di dati (poller, trapper, ecc.) e il processo di pre-elaborazione. Il server Zabbix o il proxy Zabbix (per gli item monitorati dal proxy) esegue le fasi di pre-elaborazione.
Elaborazione del valore dell'item
Per visualizzare il flusso dei dati dalla fonte dati al database Zabbix, è possibile utilizzare il seguente diagramma semplificato:
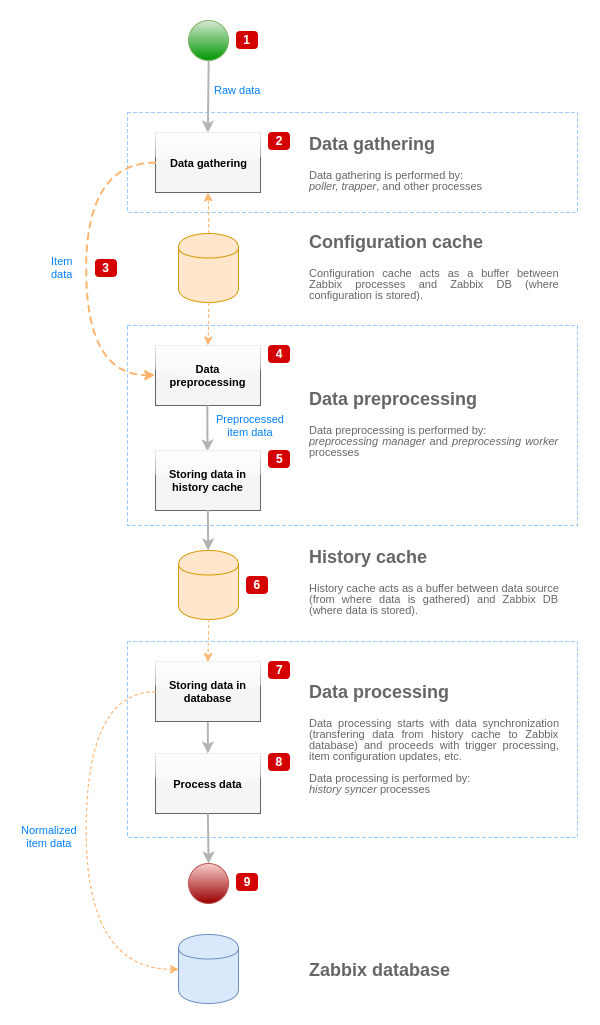
Il diagramma sopra mostra solo i processi, gli oggetti e le azioni relativi all'elaborazione del valore dell'item in forma semplificata.
Il diagramma non mostra i cambiamenti condizionali di direzione, la gestione degli errori o i cicli.
Inoltre, non viene mostrata la cache locale dei dati del gestore della pre-elaborazione, poiché non influisce direttamente sul flusso dei dati.
Lo scopo di questo diagramma è mostrare i processi coinvolti nell'elaborazione del valore dell'item e il modo in cui interagiscono.
- La raccolta dei dati inizia con i dati grezzi provenienti da una fonte dati.
A questo punto, i dati contengono solo l'ID, il timestamp e il valore (possono essere presenti anche più valori). - Indipendentemente dal tipo di raccoglitore di dati utilizzato, il principio è lo stesso per i controlli attivi o passivi, per gli item trapper e così via, poiché cambiano solo il formato dei dati e l'iniziatore della comunicazione (il raccoglitore di dati attende una connessione e i dati oppure avvia la comunicazione e richiede i dati).
I dati grezzi vengono convalidati e la configurazione dell'item viene recuperata dalla cache di configurazione (i dati vengono arricchiti con i dati di configurazione). - Per trasferire i dati dai raccoglitori di dati al gestore della pre-elaborazione viene utilizzato un meccanismo IPC basato su socket.
A questo punto, il raccoglitore di dati continua a raccogliere dati senza attendere la risposta del gestore della pre-elaborazione. - Viene eseguita la pre-elaborazione dei dati.
Questa include l'esecuzione dei passaggi di pre-elaborazione e l'elaborazione degli item dipendenti.
Un item può cambiare stato in NOT SUPPORTED durante la pre-elaborazione se uno dei passaggi di pre-elaborazione non riesce.
- I dati della cronologia presenti nella cache locale dei dati del gestore della pre-elaborazione vengono trasferiti nella cache della cronologia.
- A questo punto, il flusso dei dati si interrompe fino alla sincronizzazione successiva della cache della cronologia (quando il processo di sincronizzazione della cronologia esegue la sincronizzazione dei dati).
- Il processo di sincronizzazione inizia con la normalizzazione dei dati prima della memorizzazione dei dati nel database Zabbix.
La normalizzazione dei dati esegue le conversioni nel tipo di item desiderato (il tipo definito nella configurazione dell'item), inclusa la troncatura dei dati testuali in base alle dimensioni predefinite consentite per tali tipi (HISTORY_STR_VALUE_LENper le stringhe,HISTORY_TEXT_VALUE_LENper il testo eHISTORY_LOG_VALUE_LENper i valori di log).
Dopo il completamento della normalizzazione, i dati vengono inviati al database Zabbix.
Un item può cambiare stato in NOT SUPPORTED se la normalizzazione dei dati non riesce (ad esempio, quando un valore testuale non può essere convertito in un numero).
- I dati raccolti vengono elaborati: vengono verificati i trigger, la configurazione dell'item viene aggiornata se l'item diventa NOT SUPPORTED e così via.
- Questo è considerato il termine del flusso dei dati dal punto di vista dell'elaborazione del valore dell'item.
Pre-elaborazione del valore dell'item
L'elaborazione preliminare dei dati viene eseguita nei seguenti passaggi:
- Se l'item non dispone né di pre-elaborazione né di item dipendenti, il suo valore viene aggiunto alla cache della cronologia oppure inviato al gestore LLD. In caso contrario, il valore dell'item viene passato al gestore della pre-elaborazione utilizzando un meccanismo IPC basato su socket UNIX (prima di Zabbix 7.0.17, tutti i valori venivano passati attraverso il gestore della pre-elaborazione prima di essere aggiunti alla cache della cronologia o inviati al gestore LLD).
- Viene creata un'attività di pre-elaborazione, che viene aggiunta alla coda, e i worker di pre-elaborazione vengono informati della nuova attività.
- A questo punto il flusso di dati si interrompe finché non è disponibile almeno un worker di pre-elaborazione libero (ovvero che non sta eseguendo alcuna attività).
- Quando un worker di pre-elaborazione è disponibile, preleva l'attività successiva dalla coda.
- Al termine della pre-elaborazione (sia in caso di esecuzione riuscita sia in caso di errore dei passaggi di pre-elaborazione), il valore pre-elaborato viene aggiunto alla coda delle attività completate e il gestore viene informato della presenza di una nuova attività completata.
- Il gestore della pre-elaborazione converte il risultato nel formato desiderato (definito dal tipo di valore dell'item) e lo aggiunge alla cache della cronologia oppure lo invia al gestore LLD.
- Se per l'item elaborato sono presenti item dipendenti, questi vengono aggiunti alla coda di pre-elaborazione insieme al valore pre-elaborato dell'item master. Gli item dipendenti vengono accodati ignorando le normali richieste di pre-elaborazione dei valori, ma solo per gli item master con un valore impostato e che non si trovano nello stato NOT SUPPORTED.

Si noti che nel diagramma la pre-elaborazione dell'item master è leggermente semplificata, poiché viene omessa la memorizzazione nella cache della pre-elaborazione.
Coda di pre-elaborazione
La coda di pre-elaborazione è organizzata come segue:
- l'elenco delle attività in attesa:
- attività create direttamente dalle richieste di pre-elaborazione dei valori, nell'ordine in cui sono state ricevute
- l'elenco delle attività immediate (elaborate prima delle attività in attesa):
- attività di test (create in risposta alle richieste di test di item/pre-elaborazione dal frontend)
- attività degli item dipendenti
- attività sequenziali (attività che devono essere eseguite in un ordine rigoroso):
- con passaggi di pre-elaborazione che utilizzano l'ultimo valore:
- modifica
- limitazione
- JavaScript (memorizzazione nella cache del bytecode)
- memorizzazione nella cache della pre-elaborazione degli item dipendenti
- con passaggi di pre-elaborazione che utilizzano l'ultimo valore:
- l'elenco delle attività completate
Memorizzazione nella cache della pre-elaborazione
La memorizzazione nella cache della pre-elaborazione è stata introdotta per migliorare le prestazioni della pre-elaborazione per più item dipendenti con passaggi di pre-elaborazione simili (un risultato comune dell'LLD).
La memorizzazione nella cache viene eseguita elaborando un item dipendente e riutilizzando alcuni dati interni della pre-elaborazione per gli altri item dipendenti. La cache della pre-elaborazione è supportata solo per il primo passaggio di pre-elaborazione dei seguenti tipi:
- Pattern Prometheus (indicizza l'input in base alle metriche)
- JSONPath (analizza i dati in un albero di oggetti e indicizza la prima espressione
[?(@.path == "value")])
Worker di preprocessing
Il file di configurazione del server Zabbix consente agli utenti di impostare il numero di thread worker di preprocessing. Il parametro di configurazione StartPreprocessors deve essere utilizzato per impostare il numero di istanze preavviate dei worker di preprocessing, che dovrebbe almeno corrispondere al numero di core CPU disponibili.
Se le attività di preprocessing non sono vincolate dalla CPU e comportano frequenti richieste di rete, è consigliabile configurare worker aggiuntivi. Il numero ottimale di worker di preprocessing può essere determinato da molti fattori, tra cui il numero di item "preprocessabili" (item che richiedono l'esecuzione di uno o più passaggi di preprocessing), il numero di processi di raccolta dati, il numero medio di passaggi per il preprocessing degli item e così via. Un numero insufficiente di worker può causare un utilizzo elevato della memoria. Per la risoluzione dei problemi relativi a un utilizzo eccessivo della memoria nell'installazione di Zabbix, vedere Profilazione dell'utilizzo eccessivo della memoria con tcmalloc.
Tuttavia, supponendo che non siano presenti operazioni di preprocessing pesanti, come l'analisi di grandi blocchi XML/JSON, il numero di worker di preprocessing può corrispondere al numero totale di processi di raccolta dati. In questo modo, per i dati raccolti sarà presente per lo più (tranne nei casi in cui i dati provenienti dal processo di raccolta arrivino in blocco) almeno un worker di preprocessing non occupato.
Un numero eccessivo di processi di raccolta dati (poller, poller non raggiungibili, poller ODBC, poller HTTP, poller Java, pinger, trapper, proxypoller), insieme a IPMI manager, SNMP trapper e worker di preprocessing, può esaurire il limite di descrittori di file per processo del preprocessing manager.
L'esaurimento del limite di descrittori di file per processo farà sì che il server Zabbix si arresti, in genere poco dopo l'avvio, ma talvolta anche dopo un periodo più lungo.
Per evitare questi problemi, esaminare il file di configurazione del server Zabbix per ottimizzare il numero di controlli e processi simultanei.
Inoltre, se necessario, assicurarsi che il limite dei descrittori di file sia sufficientemente elevato verificando e modificando i limiti di sistema.
Pipeline di elaborazione dei valori
L'elaborazione del valore di un item viene eseguita in più passaggi (o fasi) da più processi. Questo può causare:
- Un item dipendente può ricevere valori, mentre IL valore master non può essere ricevuto.
Questo può essere ottenuto utilizzando il seguente caso d'uso:
- L'item master ha il tipo di valore
UINT(è possibile utilizzare un item trapper), mentre l'item dipendente ha il tipo di valoreTEXT. - Non sono richiesti passaggi di pre-elaborazione né per l'item master né per gli item dipendenti.
- Il valore testuale (ad esempio, "abc") deve essere passato all'item master.
- Poiché non ci sono passaggi di pre-elaborazione da eseguire, il gestore della pre-elaborazione verifica che l'item master non sia nello stato NOT SUPPORTED e che il valore sia impostato (entrambe le condizioni sono vere), quindi accoda l'item dipendente con lo stesso valore dell'item master (poiché non ci sono passaggi di pre-elaborazione).
- Quando entrambi gli item raggiungono la fase di sincronizzazione della cronologia, l'item master diventa NOT SUPPORTED a causa dell'errore di conversione del valore (i dati testuali non possono essere convertiti in un intero senza segno).
- L'item master ha il tipo di valore
Di conseguenza, l'item dipendente riceve un valore, mentre l'item master cambia il proprio stato in NOT SUPPORTED.
- Un item dipendente riceve un valore che non è presente nella cronologia dell'item master.
Il caso d'uso è molto simile a quello precedente, ad eccezione del tipo dell'item master.
Ad esempio, se per l'item master viene utilizzato il tipo
CHAR, il valore dell'item master verrà troncato nella fase di sincronizzazione della cronologia, mentre gli item dipendenti riceveranno i propri valori dal valore iniziale (non troncato) dell'item master.