

5 Escalonamentos
Visão geral
Com escalonamentos, você pode criar cenários personalizados para enviar notificações ou executar comandos remotos.
Em termos práticos, isso significa que:
- Os usuários podem ser informados sobre novos problemas imediatamente.
- As notificações podem ser repetidas até que o problema seja resolvido.
- O envio de uma notificação pode ser adiado.
- As notificações podem ser escalonadas para outro grupo de usuários "superior".
- Comandos remotos podem ser executados imediatamente ou quando um problema não for resolvido por um longo período.
As ações são escalonadas com base na etapa de escalonamento. Cada etapa tem uma duração.
Você pode definir tanto a duração padrão quanto uma duração personalizada de uma etapa individual. A duração mínima de uma etapa de escalonamento é de 60 segundos.
Você pode iniciar ações, como enviar notificações ou executar comandos, a partir de qualquer etapa. A etapa um é para ações imediatas. Se você quiser adiar uma ação, poderá atribuí-la a uma etapa posterior. Para cada etapa, várias ações podem ser definidas.
O número de etapas de escalonamento não é limitado.
Os escalonamentos são definidos ao configurar uma operação. Os escalonamentos são compatíveis apenas com operações de problema, não de recuperação.
Aspectos diversos do comportamento de escalonamento
Vamos considerar o que acontece em diferentes circunstâncias quando uma ação contém várias etapas de escalonamento.
| Situação | Comportamento |
|---|---|
| O host em questão entra em manutenção após o envio da notificação inicial do problema | Dependendo da configuração Pausar operações para problemas suprimidos na configuração da ação, todas as etapas de escalonamento restantes são executadas com um atraso causado pelo período de manutenção ou sem atraso. Um período de manutenção não cancela as operações. |
| O período definido na condição Período de tempo da ação termina após o envio da notificação inicial | Todas as etapas de escalonamento restantes são executadas. A condição Período de tempo não pode interromper as operações; ela tem efeito sobre quando as ações são iniciadas ou não, e não sobre as operações. |
| Um problema começa durante a manutenção e continua (não é resolvido) após o término da manutenção | Dependendo da configuração Pausar operações para problemas suprimidos na configuração da ação, todas as etapas de escalonamento são executadas a partir do momento em que a manutenção termina ou imediatamente. |
| Um problema começa durante uma manutenção sem dados e continua (não é resolvido) após o término da manutenção | É necessário aguardar o disparo do trigger antes que todas as etapas de escalonamento sejam executadas. |
| Diferentes escalonamentos ocorrem em rápida sucessão e se sobrepõem | A execução de cada novo escalonamento substitui o escalonamento anterior, mas pelo menos uma etapa de escalonamento é sempre executada no escalonamento anterior. Esse comportamento é relevante em ações relacionadas a eventos criados a cada avaliação de problema do trigger. |
| Durante um escalonamento em andamento (por exemplo, enquanto uma mensagem está sendo enviada), com base em qualquer tipo de evento: - a ação é desabilitada Com base em um evento de trigger: - o trigger é desabilitado - o host ou o item é desabilitado Com base em um evento interno sobre triggers: - o trigger é desabilitado Com base em um evento interno sobre itens/regras de descoberta de baixo nível: - o item é desabilitado - o host é desabilitado |
A mensagem em andamento é enviada e, em seguida, mais uma mensagem do escalonamento é enviada. A mensagem subsequente terá o texto de cancelamento no início do corpo da mensagem (OBSERVAÇÃO: Escalonamento cancelado), informando o motivo (por exemplo, OBSERVAÇÃO: Escalonamento cancelado: ação '<Action name>' desabilitada). Dessa forma, o destinatário é informado de que o escalonamento foi cancelado e que nenhuma outra etapa será executada. Essa mensagem é enviada a todos que receberam as notificações anteriormente. O motivo do cancelamento também é registrado no arquivo de log do server (a partir do Nível de depuração 3=Warning). Observe que a mensagem Escalonamento cancelado também é enviada quando as operações são concluídas, mas as operações de recuperação estão configuradas e ainda não foram executadas. |
| Durante um escalonamento em andamento (por exemplo, enquanto uma mensagem está sendo enviada), a ação é excluída | Nenhuma outra mensagem é enviada. As informações são registradas no arquivo de log do server (a partir do Nível de depuração 3=Warning), por exemplo: escalation canceled: action id:334 deleted |
Exemplos de escalonamento
Exemplo 1
Enviando uma notificação repetida a cada 30 minutos (5 vezes no total) para um grupo "Administradores MySQL". Para configurar:
- Na aba Operações, defina a Duração padrão do passo da operação como "30m" (30 minutos).
- Defina os Passos da escalonamento de "1" a "5".
- Selecione o grupo "Administradores MySQL" como destinatário da mensagem.
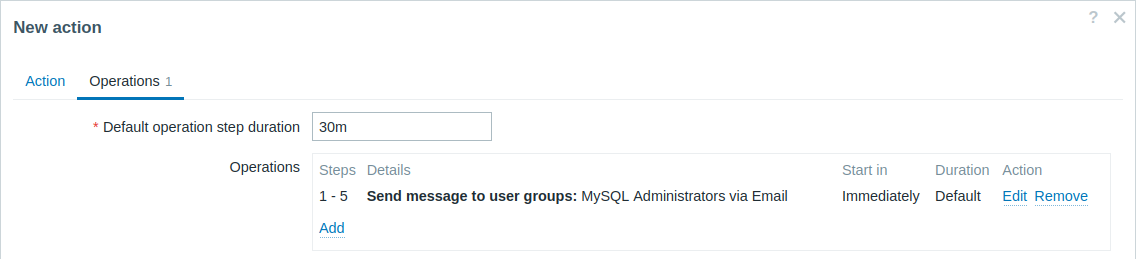
As notificações serão enviadas às 0:00, 0:30, 1:00, 1:30, 2:00 horas após o início do problema (a menos, é claro, que o problema seja resolvido antes).
Se o problema for resolvido e uma mensagem de recuperação estiver configurada, ela será enviada para aqueles que receberam pelo menos uma mensagem de problema dentro deste cenário de escalonamento.
Se o trigger que gerou um escalonamento ativo for desabilitado, o Zabbix envia uma mensagem informativa sobre isso para todos que já receberam notificações.
Exemplo 2
Enviando uma notificação atrasada sobre um problema de longa duração. Para configurar:
- Na aba Operações, defina a Duração padrão da etapa de operação como "10h" (10 horas).
- Defina as Etapas da escalonamento de "2" a "2".

Uma notificação só será enviada na Etapa 2 do cenário de escalonamento, ou seja, 10 horas após o início do problema.
Você pode personalizar o texto da mensagem para algo como "O problema tem mais de 10 horas".
Exemplo 3
Escalando o problema para o chefe.
No primeiro exemplo acima, configuramos o envio periódico de mensagens para os administradores do MySQL. Neste caso, os administradores receberão quatro mensagens antes que o problema seja escalado para o gerente do banco de dados. Observe que o gerente só receberá uma mensagem caso o problema ainda não tenha sido reconhecido, presumivelmente ninguém está trabalhando nele.

Detalhes da Operação 2:

Observe o uso da macro {ESC.HISTORY} na mensagem personalizada. A macro conterá informações sobre todas as etapas executadas anteriormente nesta escalada, como notificações enviadas e comandos executados.
Exemplo 4
Um cenário mais complexo. Após várias mensagens para os administradores do MySQL e escalonamento para o gerente, o Zabbix tentará reiniciar o banco de dados MySQL. Isso acontecerá se o problema existir por 2:30 horas e não tiver sido reconhecido.
Se o problema ainda existir, após mais 30 minutos o Zabbix enviará uma mensagem para todos os usuários convidados.
Se isso não ajudar, após mais uma hora o Zabbix irá reiniciar o servidor com o banco de dados MySQL (segundo comando remoto) usando comandos IPMI.

Exemplo 5
Uma escalada com várias operações que possuem intervalos de etapas sobrepostos e intervalos personalizados. A duração padrão da etapa da operação é de 30 minutos.

As notificações serão enviadas da seguinte forma:
- Para os administradores do MySQL às 0:00, 0:30, 1:00 e 1:30 após o início do problema.
- Para o gerente do banco de dados às 2:00 e 2:10 (a duração da etapa personalizada mais curta de 10 minutos definida na operação subsequente substitui a duração da etapa mais longa de 1 hora configurada aqui, conforme descrito em Detalhes da operação para Duração da etapa quando as etapas se sobrepõem).
- Para os administradores do Zabbix às 2:00, 2:10 e 2:20 após o início do problema (a duração da etapa personalizada de 10 minutos é aplicada).
- Para os usuários convidados às 4:00 após o início do problema (a duração padrão da etapa de 30 minutos entra em vigor entre as etapas 8 e 11).