
3 Descubrimiento de bajo nivel
Descripción general
La detección de bajo nivel (LLD) descubre automáticamente entidades (por ejemplo, sistemas de archivos, interfaces de red) en un host y crea los items, triggers y gráficos correspondientes sin necesidad de configuración manual para cada una.
Para usar LLD, se crea una regla de descubrimiento que recopila datos JSON que describen entidades, y prototipos (item, trigger y gráfico) para cada entidad.
El JSON devuelto por la regla debe ser un array de objetos, donde cada objeto representa una entidad descubierta mediante pares clave-valor. Por ejemplo, una regla de descubrimiento con net.if.discovery podría devolver:
[
  {"{#IFNAME}": "lo"},
  {"{#IFNAME}": "eth0"}
]
A continuación, se crea un conjunto correspondiente de items, triggers y gráficos a partir de los prototipos: uno por cada interfaz (lo y eth0).
Si los objetos contienen claves en el formato {#MACRO}, esas macros se usan directamente en los prototipos. Si no es así, o si se requieren macros adicionales/personalizadas, las macros pueden definirse manualmente y asignarse a campos JSON mediante JSONPath.
LLD también puede crear hosts (por ejemplo, para máquinas virtuales descubiertas en un hipervisor) y admite reglas de descubrimiento anidadas para el descubrimiento multinivel.
Las entidades que ya no se descubren pueden deshabilitarse o eliminarse automáticamente.
Configuración del descubrimiento de bajo nivel
Ilustraremos el descubrimiento de bajo nivel con un ejemplo de descubrimiento del sistema de archivos.
Para configurar el descubrimiento, haga lo siguiente:
- Vaya a Data collection > Templates o Hosts.
- Haga clic en Discovery en la fila de la template o host correspondiente.
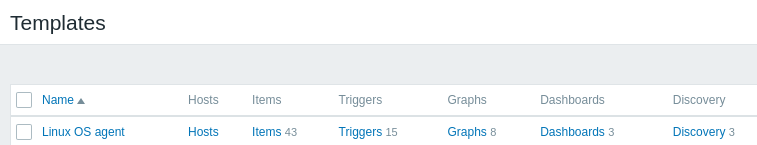
- Haga clic en Create discovery rule en la esquina superior derecha de la pantalla.
- Complete el formulario de la regla de descubrimiento con los detalles requeridos.
Regla de descubrimiento
El formulario de la regla de descubrimiento contiene cinco pestañas que representan, de izquierda a derecha, el flujo de datos durante el descubrimiento:
- Regla de descubrimiento: especifique qué item integrado o script personalizado se utilizará para recuperar los datos de descubrimiento.
- Preprocesamiento: aplique algún preprocesamiento a los datos descubiertos.
- Macros LLD: permiten extraer valores de macros para utilizarlos en items descubiertos, triggers, etc.
- Filtros: permiten filtrar los valores descubiertos.
- Anulaciones: permiten modificar items, triggers, gráficos o prototipos de host cuando se aplican a objetos descubiertos específicos.
La pestaña Regla de descubrimiento contiene la clave del item que se utilizará para el descubrimiento, así como algunos atributos generales de la regla de descubrimiento:
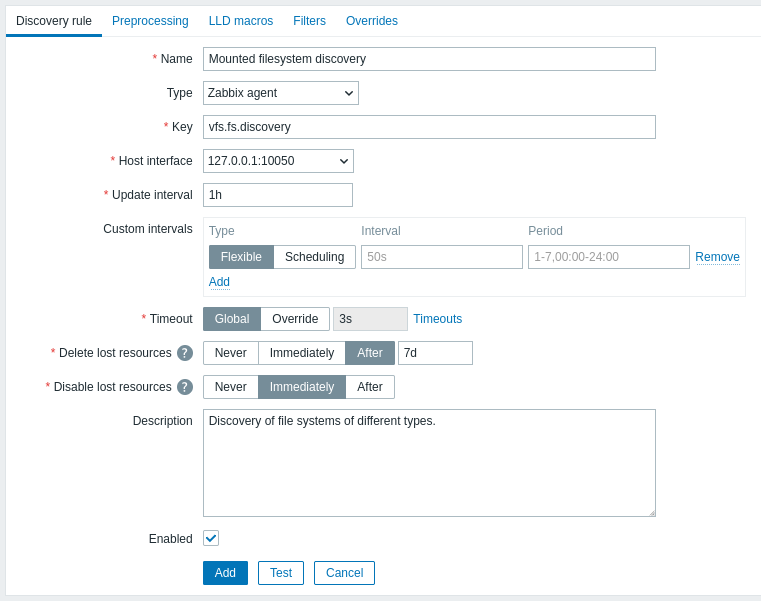
Todos los campos de entrada obligatorios están marcados con un asterisco rojo.
| Parámetro | Descripción |
|---|---|
| Nombre | Nombre de la regla de descubrimiento. |
| Tipo | Tipo de comprobación que se realizará para el descubrimiento. En este ejemplo utilizamos un tipo de item Zabbix agent. La regla de descubrimiento también puede ser un item dependiente, que dependa de un item normal. No puede depender de otra regla de descubrimiento. Para un item dependiente, seleccione el tipo correspondiente (Item dependiente) y especifique el item maestro en el campo «Item maestro». El item maestro debe existir. |
| Clave | Introduzca la clave del item de descubrimiento (hasta 2048 caracteres). Por ejemplo, puede utilizar la clave de item integrada "vfs.fs.discovery" para devolver una cadena JSON con la lista de sistemas de archivos presentes en el equipo, sus tipos y opciones de montaje. Tenga en cuenta que otra opción para descubrir sistemas de archivos consiste en utilizar los resultados de descubrimiento mediante la clave de agent "vfs.fs.get" (consulte el ejemplo). |
| Intervalo de actualización | Este campo especifica con qué frecuencia Zabbix realiza el descubrimiento. Al principio, mientras configura el descubrimiento de sistemas de archivos, puede establecer un intervalo pequeño, pero una vez que compruebe que funciona, puede establecerlo en 30 minutos o más, ya que los sistemas de archivos normalmente no cambian con mucha frecuencia. Se admiten sufijos de tiempo, por ejemplo, 30s, 1m, 2h, 1d. Se admiten macros de usuario. Nota: el intervalo de actualización solo puede establecerse en «0» si existen intervalos personalizados con un valor distinto de cero. Si se establece en «0» y existe un intervalo personalizado (flexible o programado) con un valor distinto de cero, el item se consultará durante la duración del intervalo personalizado. Las nuevas reglas de descubrimiento se comprobarán en un plazo de 60 segundos desde su creación, a menos que tengan un intervalo de actualización programado o flexible y Intervalo de actualización esté establecido en 0. Nota: en una regla de descubrimiento existente, el descubrimiento puede realizarse inmediatamente pulsando el botón Ejecutar ahora. |
| Intervalos personalizados | Puede crear reglas personalizadas para comprobar el item: Flexible: crea una excepción al Intervalo de actualización (un intervalo con una frecuencia diferente). Programación: crea una programación de consulta personalizada. Para obtener información detallada, consulte Intervalos personalizados. |
| Tiempo de espera | Establezca el tiempo de espera de la comprobación de descubrimiento. Seleccione la opción de tiempo de espera: Global: se utiliza el tiempo de espera del proxy/global (se muestra en el campo Tiempo de espera atenuado); Anulación: se utiliza un tiempo de espera personalizado (establecido en el campo Tiempo de espera; rango permitido: 1 - 600s). Se admiten sufijos de tiempo, por ejemplo, 30s y 1m, así como macros de usuario. Al hacer clic en el enlace Tiempos de espera, puede configurar los tiempos de espera del proxy o los tiempos de espera globales (si no se utiliza un proxy). Tenga en cuenta que el enlace Tiempos de espera solo está visible para usuarios de tipo Superadministrador con permisos para las secciones del frontend Administración > General o Administración > Proxies. |
| Eliminar recursos perdidos | Especifique cuánto tiempo debe transcurrir antes de eliminar la entidad descubierta una vez que su estado de descubrimiento cambie a «Ya no se descubre»: Nunca: no se eliminará; Inmediatamente: se eliminará de inmediato; Después de: se eliminará una vez transcurrido el período especificado. El valor debe ser mayor que el valor de Deshabilitar recursos perdidos. Se admiten sufijos de tiempo, por ejemplo, 2h y 1d. Se admiten macros de usuario. Nota: no se recomienda utilizar «Inmediatamente», ya que una edición incorrecta del filtro podría provocar la eliminación de la entidad junto con todos sus datos históricos. Tenga en cuenta que el descubrimiento de bajo nivel no eliminará los recursos deshabilitados manualmente. |
| Deshabilitar recursos perdidos | Especifique cuánto tiempo debe transcurrir antes de deshabilitar la entidad descubierta una vez que su estado de descubrimiento cambie a «Ya no se descubre»: Nunca: no se deshabilitará; Inmediatamente: se deshabilitará de inmediato; Después de: se deshabilitará una vez transcurrido el período especificado. El valor debe ser mayor que el intervalo de actualización de la regla de descubrimiento. Tenga en cuenta que los recursos deshabilitados automáticamente volverán a habilitarse si el descubrimiento de bajo nivel los descubre de nuevo. Los recursos deshabilitados manualmente no volverán a habilitarse aunque se descubran de nuevo. Este campo no se muestra si Eliminar recursos perdidos está establecido en «Inmediatamente». Se admiten sufijos de tiempo, por ejemplo, 2h y 1d. Se admiten macros de usuario. |
| Descripción | Introduzca una descripción. |
| Habilitada | Si se selecciona, la regla se procesará. |
El historial de la regla de descubrimiento no se conserva.
Preprocesamiento
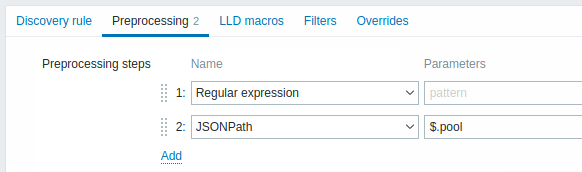
La pestaña Preprocesamiento permite definir reglas de transformación que se aplicarán al resultado del descubrimiento. En este paso se pueden realizar una o varias transformaciones. Las transformaciones se ejecutan en el orden en que se definen. Todo el preprocesamiento lo realiza el Zabbix server.
Véase también:
| Tipo | ||
|---|---|---|
| Transformación | Descripción | |
| Texto | ||
| Expresión regular | Compara el valor recibido con la expresión regular <pattern> y reemplaza el valor por el <output> extraído. La expresión regular admite la extracción de un máximo de 10 grupos capturados mediante la secuencia \N. Parámetros: pattern - expresión regular output - plantilla de formato de salida. Una secuencia de escape \N (donde N=1…9) se reemplaza por el grupo coincidente N. Una secuencia de escape \0 se reemplaza por el texto coincidente. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Reemplazar | Busca la cadena de búsqueda y la reemplaza por otra cadena (o por nada). Se reemplazarán todas las apariciones de la cadena de búsqueda. Parámetros: search string - cadena que se buscará y reemplazará, distingue entre mayúsculas y minúsculas (obligatorio) replacement - cadena por la que se reemplazará la cadena de búsqueda. La cadena de reemplazo también puede estar vacía, lo que permite eliminar la cadena de búsqueda cuando se encuentra. Es posible utilizar secuencias de escape para buscar o reemplazar saltos de línea, retornos de carro, tabulaciones y espacios "\n \r \t \s"; la barra inversa se puede escapar como "\\" y las secuencias de escape se pueden escapar como "\\n". El escape de saltos de línea, retornos de carro y tabulaciones se realiza automáticamente durante el descubrimiento de bajo nivel. |
|
| Datos estructurados | ||
| JSONPath | Extrae un valor o fragmento de datos JSON mediante la funcionalidad JSONPath. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| XML XPath | Extrae un valor o fragmento de datos XML mediante la funcionalidad XPath. Para que esta opción funcione, el Zabbix server debe compilarse con compatibilidad con libxml. Ejemplos: number(/document/item/value) extraerá 10 de <document><item><value>10</value></item></document>number(/document/item/@attribute) extraerá 10 de <document><item attribute="10"></item></document>/document/item extraerá <item><value>10</value></item> de <document><item><value>10</value></item></document>Tenga en cuenta que los espacios de nombres no son compatibles. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| CSV a JSON | Convierte los datos de un archivo CSV al formato JSON. Para obtener más información, consulte: Preprocesamiento de CSV a JSON. |
|
| XML a JSON | Convierte datos en formato XML a JSON. Para obtener más información, consulte: Reglas de serialización. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| SNMP | ||
| Valor de recorrido SNMP | Extrae el valor mediante el nombre OID/MIB especificado y aplica opciones de formato: Sin cambios - devuelve Hex-STRING como una cadena hexadecimal sin escapar (tenga en cuenta que las sugerencias de visualización se siguen aplicando); UTF-8 desde Hex-STRING - convierte Hex-STRING en una cadena UTF-8; MAC desde Hex-STRING - convierte Hex-STRING en una cadena de dirección MAC (en la que ' ' se reemplazará por ':');Entero desde BITS - convierte los primeros 8 bytes de una cadena de bits expresada como una secuencia de caracteres hexadecimales (por ejemplo, "1A 2B 3C 4D") en un entero sin signo de 64 bits. En cadenas de bits de más de 8 bytes, se ignorarán los bytes posteriores. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Recorrido SNMP a JSON | Convierte valores SNMP a JSON. Especifique un nombre de campo en JSON y la ruta OID SNMP correspondiente. Los valores de los campos se rellenarán con los valores de la ruta OID SNMP especificada. Puede utilizar este paso de preprocesamiento para el descubrimiento de OID SNMP. Están disponibles opciones de formato de valores similares a las del paso Valor de recorrido SNMP. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Obtener valor SNMP | Aplica opciones de formato al valor obtenido mediante SNMP: UTF-8 desde Hex-STRING - convierte Hex-STRING en una cadena UTF-8; MAC desde Hex-STRING - convierte Hex-STRING en una cadena de dirección MAC (en la que ' ' se reemplazará por ':');Entero desde BITS - convierte los primeros 8 bytes de una cadena de bits expresada como una secuencia de caracteres hexadecimales (por ejemplo, "1A 2B 3C 4D") en un entero sin signo de 64 bits. En cadenas de bits de más de 8 bytes, se ignorarán los bytes posteriores. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Scripts personalizados | ||
| JavaScript | Introduzca código JavaScript en el editor modal que se abre al hacer clic en el campo de parámetros o en el icono del lápiz situado junto a él. Tenga en cuenta que la longitud disponible de JavaScript depende de la base de datos utilizada. Para obtener más información, consulte: Preprocesamiento de Javascript |
|
| Validación | ||
| No coincide con la expresión regular | Especifique una expresión regular con la que el valor no debe coincidir. Por ejemplo, Error:(.*?)\.Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Comprobar si hay un error en JSON | Comprueba si hay un mensaje de error a nivel de aplicación ubicado en JSONPath. Detiene el procesamiento si la comprobación tiene éxito y el mensaje no está vacío; de lo contrario, continúa el procesamiento con el valor que existía antes de este paso de preprocesamiento. Tenga en cuenta que estos errores del servicio externo se notifican al usuario tal cual, sin añadir información sobre el paso de preprocesamiento. Por ejemplo, $.errors. Si se recibe un JSON como {"errors":"e1"}, no se ejecutará el siguiente paso de preprocesamiento.Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Comprobar si hay un error en XML | Comprueba si hay un mensaje de error a nivel de aplicación ubicado en XPath. Detiene el procesamiento si la comprobación tiene éxito y el mensaje no está vacío; de lo contrario, continúa el procesamiento con el valor que existía antes de este paso de preprocesamiento. Tenga en cuenta que estos errores del servicio externo se notifican al usuario tal cual, sin añadir información sobre el paso de preprocesamiento. No se notificará ningún error si no se puede analizar XML no válido. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Coincide con la expresión regular | Especifique una expresión regular con la que el valor debe coincidir. Si marca la casilla Personalizado en caso de error, puede especificar opciones personalizadas para gestionar errores: descartar el valor, establecer un valor especificado o establecer un mensaje de error especificado. |
|
| Limitación | ||
| Descartar los valores sin cambios con latido | Descarta un valor si no ha cambiado durante el período definido (en segundos). Se admiten valores enteros positivos para especificar los segundos (mínimo: 1 segundo). En este campo se pueden utilizar sufijos de tiempo (por ejemplo, 30s, 1m, 2h, 1d). En este campo se pueden utilizar macros de usuario y macros de descubrimiento de bajo nivel.Solo se puede especificar una opción de limitación para un discovery item. Por ejemplo, 1m. Si se pasa texto idéntico a esta regla dos veces en un intervalo de 60 segundos, se descartará.Nota: Cambiar los prototipos de item no restablece la limitación. La limitación solo se restablece cuando se modifican los pasos de preprocesamiento. |
|
| Prometheus | ||
| Prometheus a JSON | Convierte las métricas de Prometheus requeridas a JSON. Consulte Comprobaciones de Prometheus para obtener más información. |
|
Tenga en cuenta que, si la regla de descubrimiento se ha aplicado al host mediante un template, el contenido de esta pestaña es de solo lectura.
Macros personalizadas
La pestaña Macros LLD permite especificar macros personalizadas de descubrimiento de bajo nivel.
Las macros personalizadas son útiles cuando el JSON devuelto no contiene las macros necesarias ya definidas. Por ejemplo:
- La clave nativa
vfs.fs.discoverypara el descubrimiento de sistemas de archivos devuelve un JSON con algunas macros LLD predefinidas, como {#FSNAME}, {#FSTYPE}. Estas macros se pueden utilizar directamente en los prototipos de item y trigger (consulte las secciones siguientes de esta página); no es necesario definir macros personalizadas; - El item de agent
vfs.fs.gettambién devuelve un JSON con datos del sistema de archivos, pero sin macros LLD predefinidas. En este caso, puede definir las macros usted mismo y asignarlas a los valores del JSON mediante JSONPath:
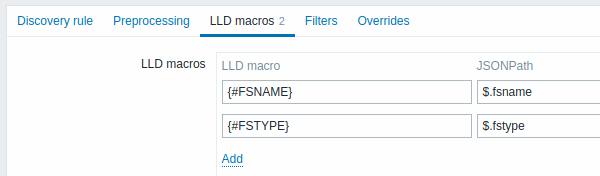
Los valores extraídos se pueden utilizar en items, triggers descubiertos, etc. Tenga en cuenta que los valores se extraerán del resultado del descubrimiento y de todos los pasos de preprocesamiento realizados hasta el momento.
| Parámetro | Descripción |
|---|---|
| Macro LLD | Nombre de la macro de descubrimiento de bajo nivel, utilizando la siguiente sintaxis: {#MACRO}. |
| JSONPath | Ruta utilizada para extraer el valor de la macro LLD de una fila LLD, utilizando la sintaxis JSONPath. Los valores extraídos del JSON devuelto se utilizan para reemplazar las macros LLD en los campos de los prototipos de item, trigger, etc. JSONPath se puede especificar mediante la notación de puntos o la notación de corchetes. La notación de corchetes debe utilizarse en caso de caracteres especiales y Unicode, como $['unicode + special chars #1']['unicode + special chars #2'].Por ejemplo, $.foo extraerá "bar" y "baz" de este JSON: [{"foo":"bar"}, {"foo":"baz"}]Tenga en cuenta que $.foo también extraerá "bar" y "baz" de este JSON: {"data":[{"foo":"bar"}, {"foo":"baz"}]}, porque un único objeto "data" se procesa automáticamente (por compatibilidad con versiones anteriores con la implementación del descubrimiento de bajo nivel en versiones de Zabbix anteriores a la 4.2). |
Filtro
Se puede utilizar un filtro para generar items, triggers y gráficos reales únicamente para las entidades que coincidan con los criterios. La pestaña Filtros contiene definiciones de filtros de reglas de descubrimiento que permiten filtrar los valores descubiertos:
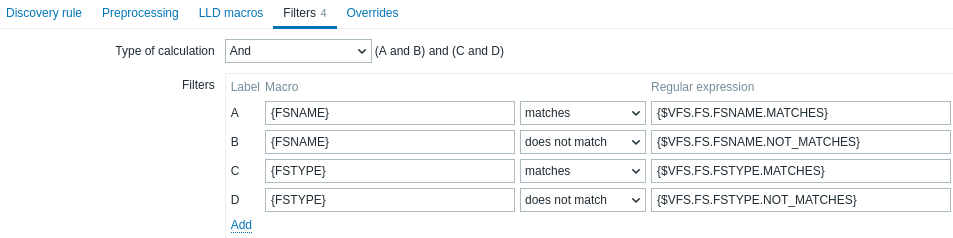
| Parámetro | Descripción |
|---|---|
| Tipo de cálculo | Están disponibles las siguientes opciones para calcular los filtros: And: deben cumplirse todos los filtros; Or: es suficiente con que se cumpla un filtro; And/Or: utiliza And con diferentes nombres de macro y Or con el mismo nombre de macro; Expresión personalizada: permite definir un cálculo personalizado de los filtros. La fórmula debe incluir todos los filtros de la lista. Está limitada a 255 símbolos. |
| Filtros | Están disponibles los siguientes operadores de condición de filtro: coincide, no coincide, existe, no existe. Los operadores coincide y no coincide esperan una expresión regular compatible con Perl (PCRE). Puede introducir una expresión regular o hacer referencia a una expresión regular global en el campo Expresión regular. Los operadores existe y no existe permiten filtrar entidades según la presencia o ausencia de la macro LLD especificada en la respuesta. Tenga en cuenta que, si falta en la respuesta una macro del filtro, la entidad encontrada se ignorará, a menos que se especifique una condición "no existe" para dicha macro. Se mostrará una advertencia si la ausencia de una macro afecta al resultado de la expresión. Por ejemplo, si {#B} falta en:{#A} coincide con 1 y {#B} coincide con 2: se mostrará una advertencia{#A} coincide con 1 o {#B} coincide con 2: no se mostrará ninguna advertencia. |
Por ejemplo, si solo le interesan los sistemas de archivos C:, D: y E:, puede introducir {#FSNAME} en el campo Macro y ^C|^D|^E en el campo Expresión regular.
También es posible filtrar por tipos de sistemas de archivos mediante la macro {#FSTYPE} (por ejemplo, ^ext|^reiserfs) y por tipos de unidad (compatibles únicamente con Windows agent) mediante la macro {#FSDRIVETYPE} (por ejemplo, fixed).
Para probar una expresión regular, puede utilizar grep -E, por ejemplo:
for f in ext2 nfs reiserfs smbfs;
do echo $f | grep -E '^ext|^reiserfs' || echo "SKIP: $f";
done
Un error o una errata en la expresión regular utilizada en la regla LLD (por ejemplo, una expresión regular incorrecta de "Sistemas de archivos para descubrir") puede provocar la eliminación de miles de elementos de configuración, valores históricos y eventos de muchos hosts.
La base de datos de Zabbix en MySQL debe crearse distinguiendo entre mayúsculas y minúsculas para que los nombres de sistemas de archivos que solo difieren en el uso de mayúsculas y minúsculas se descubran correctamente.
Anulación
La pestaña Anulaciones permite establecer reglas para modificar la lista de prototipos de item, trigger, gráfico, host y descubrimiento, o sus atributos, para los objetos descubiertos que cumplan determinados criterios.
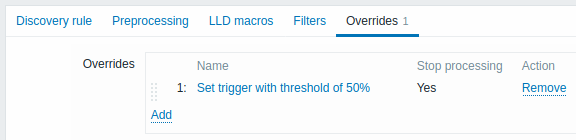
Las anulaciones (si existen) se muestran en una lista reordenable mediante arrastrar y soltar, y se ejecutan en el orden en que están definidas. Para configurar los detalles de una nueva anulación, haga clic en  en el bloque Anulaciones.
Para editar una anulación existente, haga clic en su nombre.
Se abrirá una ventana emergente que permite editar los detalles de la regla de anulación.
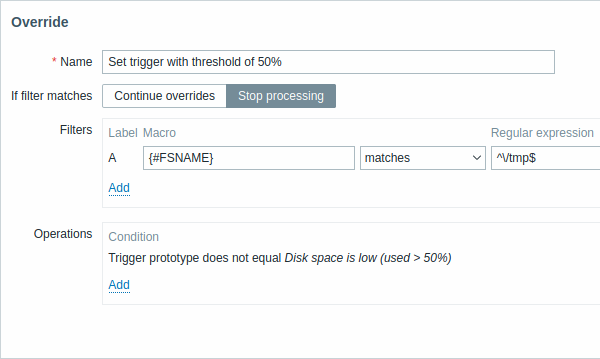
Todos los parámetros obligatorios están marcados con asteriscos rojos.
| Parámetro | Descripción |
|---|---|
| Nombre | Un nombre de anulación único (por regla de LLD). |
| Si el filtro coincide | Define si deben procesarse las siguientes anulaciones cuando se cumplen las condiciones del filtro: Continuar con las anulaciones: se procesarán las anulaciones posteriores. Detener el procesamiento: se ejecutarán las operaciones de la anulación anterior (si existe) y de esta anulación; las anulaciones posteriores se ignorarán para las filas de LLD coincidentes. |
| Filtros | Determina a qué entidades descubiertas debe aplicarse la anulación. Los filtros de anulación se procesan después de los filtros de la regla de descubrimiento y tienen la misma funcionalidad. |
| Operaciones | Las operaciones de anulación se muestran con estos detalles: Condición: un tipo de objeto y una condición que debe cumplirse para el nombre del objeto; por ejemplo: el prototipo de trigger no es igual a El espacio en disco es bajo (usado > 50%). Acciones: se muestran enlaces para editar y eliminar una operación. |
Configuración de una operación
Para configurar los detalles de una nueva operación, haga clic en en el bloque Operaciones.
Para editar una operación existente, haga clic en  junto a la operación.
Se abrirá una ventana emergente en la que podrá editar los detalles de la operación.
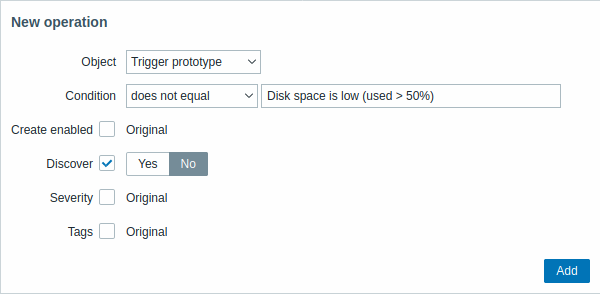
| Parámetro | Descripción | ||
|---|---|---|---|
| Objeto | Hay cinco tipos de objetos disponibles: Prototipo de item Prototipo de trigger Prototipo de gráfico Prototipo de host Prototipo de descubrimiento |
||
| Condición | Permite filtrar las entidades a las que debe aplicarse la operación. | ||
| Operador | Operadores compatibles: es igual a: aplicar a este prototipo no es igual a: aplicar a todos los prototipos excepto este contiene: aplicar si el nombre del prototipo contiene esta cadena no contiene: aplicar si el nombre del prototipo no contiene esta cadena coincide: aplicar si el nombre del prototipo coincide con la expresión regular no coincide: aplicar si el nombre del prototipo no coincide con la expresión regular |
||
| Patrón | Una expresión regular o una cadena que buscar. | ||
| Objeto: Prototipo de item | |||
| Crear habilitado | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de item: Sí: el item se añadirá en estado habilitado. No: el item se añadirá a una entidad descubierta, pero en estado deshabilitado. |
||
| Descubrir | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de item: Sí: el item se añadirá. No: el item no se añadirá. |
||
| Intervalo de actualización | Al marcar la casilla, aparecerán dos opciones que permiten establecer un intervalo diferente para el item: Retraso: intervalo de actualización del item. Se admiten macros de usuario, macros de LLD y sufijos de tiempo (por ejemplo, 30s, 1m, 2h, 1d). La compatibilidad con macros de LLD se restauró en Zabbix 7.4.11. Debe establecerse en 0 si se utiliza Intervalo personalizado. Intervalo personalizado: haga clic en para especificar intervalos flexibles o programados. Para obtener información detallada, consulte Intervalos personalizados. |
||
| Historial | Al marcar la casilla, aparecerán botones que permiten establecer un período de almacenamiento del historial diferente para el item: No almacenar: si se selecciona, el historial no se almacenará. Almacenar hasta: si se selecciona, aparecerá a la derecha un campo de entrada para especificar el período de almacenamiento. Se admiten macros de usuario y macros de LLD. La compatibilidad con macros de LLD se restauró en Zabbix 7.4.11. |
||
| Tendencias | Al marcar la casilla, aparecerán botones que permiten establecer un período de almacenamiento de tendencias diferente para el item: No almacenar: si se selecciona, las tendencias no se almacenarán. Almacenar hasta: si se selecciona, aparecerá a la derecha un campo de entrada para especificar el período de almacenamiento. Se admiten macros de usuario y macros de LLD. La compatibilidad con macros de LLD se restauró en Zabbix 7.4.11. |
||
| Etiquetas | Al marcar la casilla, aparecerá un nuevo bloque que permite especificar pares etiqueta-valor. Se admiten macros de usuario y macros de LLD. Estas etiquetas se añadirán a las etiquetas especificadas en el prototipo de item, incluso si los nombres de las etiquetas coinciden. |
||
| Objeto: Prototipo de trigger | |||
| Crear habilitado | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de trigger: Sí: el trigger se añadirá en estado habilitado. No: el trigger se añadirá a una entidad descubierta, pero en estado deshabilitado. |
||
| Descubrir | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de trigger: Sí: el trigger se añadirá. No: el trigger no se añadirá. |
||
| Severidad | Al marcar la casilla, aparecerán botones de severidad del trigger que permiten modificar su severidad. | ||
| Etiquetas | Al marcar la casilla, aparecerá un nuevo bloque que permite especificar pares etiqueta-valor. Se admiten macros de usuario y macros de LLD. Estas etiquetas se añadirán a las etiquetas especificadas en el prototipo de trigger, incluso si los nombres de las etiquetas coinciden. |
||
| Objeto: Prototipo de gráfico | |||
| Descubrir | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de gráfico: Sí: el gráfico se añadirá. No: el gráfico no se añadirá. |
||
| Objeto: Prototipo de host | |||
| Crear habilitado | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de host: Sí: el host se creará en estado habilitado. No: el host se creará en estado deshabilitado. |
||
| Descubrir | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de host: Sí: el host se descubrirá. No: el host no se descubrirá. |
||
| Vincular templates | Al marcar la casilla, aparecerá un campo de entrada para especificar templates. Comience a escribir el nombre del template o haga clic en Seleccionar junto al campo y seleccione templates de la lista en una ventana emergente. Los templates de esta anulación se añaden a todos los templates ya vinculados al prototipo de host. |
||
| Etiquetas | Al marcar la casilla, aparecerá un nuevo bloque que permite especificar pares etiqueta-valor. Se admiten macros de usuario y macros de LLD. Estas etiquetas se añadirán a las etiquetas especificadas en el prototipo de host, incluso si los nombres de las etiquetas coinciden. |
||
| Inventario del host | Al marcar la casilla, aparecerán botones que permiten seleccionar un modo de inventario diferente para el prototipo de host: Deshabilitado: no completar el inventario del host Manual: proporcionar los detalles manualmente Automatizado: completar automáticamente los datos del inventario del host según las métricas recopiladas. |
||
| Objeto: Prototipo de descubrimiento | |||
| Crear habilitado | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de descubrimiento: Sí: la regla de descubrimiento se añadirá en estado habilitado. No: la regla de descubrimiento se añadirá en estado deshabilitado. |
||
| Descubrir | Al marcar la casilla, aparecerán botones que permiten anular la configuración original del prototipo de descubrimiento: Sí: la regla de descubrimiento se añadirá. No: la regla de descubrimiento no se añadirá. |
||
| Intervalo de actualización | Al marcar la casilla, aparecerán dos opciones que permiten establecer un intervalo diferente para la regla de descubrimiento: Retraso: intervalo de actualización de la regla. Se admiten macros de usuario, macros de LLD y sufijos de tiempo (por ejemplo, 30s, 1m, 2h, 1d). Debe establecerse en 0 si se utiliza Intervalo personalizado. Intervalo personalizado: haga clic en para especificar intervalos flexibles o programados. Para obtener información detallada, consulte Intervalos personalizados. |
||
Botones del formulario
Los botones situados en la parte inferior del formulario permiten realizar varias operaciones.
 |
Añadir una regla de descubrimiento. Este botón solo está disponible para las reglas de descubrimiento nuevas. |
 |
Actualizar las propiedades de una regla de descubrimiento. Este botón solo está disponible para las reglas de descubrimiento existentes. |
 |
Crear otra regla de descubrimiento basada en las propiedades de la regla de descubrimiento actual. |
 |
Realizar inmediatamente el descubrimiento según la regla de descubrimiento. La regla de descubrimiento debe existir previamente. Consulte más detalles. Nota: al realizar el descubrimiento inmediatamente, la caché de configuración no se actualiza, por lo que el resultado no reflejará los cambios más recientes en la configuración de la regla de descubrimiento. |
 |
Probar la configuración de la regla de descubrimiento. Utilice este botón para verificar los ajustes de configuración (como la conectividad y la corrección de los parámetros) sin aplicar permanentemente ningún cambio. |
 |
Eliminar la regla de descubrimiento. |
 |
Cancelar la edición de las propiedades de la regla de descubrimiento. |
Entidades descubiertas
Las siguientes capturas de pantalla ilustran cómo se ven los items, triggers y gráficos descubiertos en la configuración del host. Las entidades descubiertas están precedidas por un enlace naranja a la regla de descubrimiento de la que provienen.

Tenga en cuenta que las entidades descubiertas no se crearán en caso de que ya existan entidades con los mismos criterios de unicidad, por ejemplo, un item con la misma clave o un gráfico con el mismo nombre. En este caso, se muestra un mensaje de error en el frontend indicando que la regla de descubrimiento de bajo nivel no pudo crear ciertas entidades. Sin embargo, la propia regla de descubrimiento no se volverá no soportada porque alguna entidad no pudo ser creada y tuvo que ser omitida. La regla de descubrimiento continuará creando/actualizando otras entidades.
Si una entidad descubierta (host, sistema de archivos, interfaz, etc.) deja de ser descubierta (o ya no pasa el filtro), las entidades que se crearon en base a ella pueden ser deshabilitadas automáticamente y eventualmente eliminadas.
Los recursos perdidos pueden ser deshabilitados automáticamente según el valor del parámetro Deshabilitar recursos perdidos. Esto afecta a los hosts, items y triggers perdidos.
Los recursos perdidos pueden ser eliminados automáticamente según el valor del parámetro Eliminar recursos perdidos. Esto afecta a los hosts, grupos de hosts, items, triggers y gráficos perdidos.
Cuando las entidades descubiertas pasan a estar 'Ya no descubiertas', se muestra un indicador de tiempo de vida en la lista de entidades. Mueva el puntero del ratón sobre él y se mostrará un mensaje que indica los detalles de su estado.

Si las entidades fueron marcadas para su eliminación, pero no se eliminaron en el momento esperado (regla de descubrimiento o host del item deshabilitado), se eliminarán la próxima vez que se procese la regla de descubrimiento.
Las entidades que contienen otras entidades, que están marcadas para su eliminación, no se actualizarán si se cambian a nivel de la regla de descubrimiento. Por ejemplo, los triggers basados en LLD no se actualizarán si contienen items que están marcados para su eliminación.


Otros tipos de descubrimiento
Más detalles y procedimientos sobre otros tipos de descubrimiento listos para usar están disponibles en las siguientes secciones:
- descubrimiento de interfaces de red
- descubrimiento de CPUs y núcleos de CPU
- descubrimiento de OIDs SNMP
- descubrimiento de objetos JMX;
- descubrimiento usando consultas SQL ODBC
- descubrimiento de servicios de Windows
- descubrimiento de interfaces de host en Zabbix
Para más detalles sobre el formato JSON para items de descubrimiento y un ejemplo de cómo implementar su propio descubridor de sistemas de archivos como un script Perl, consulte creación de reglas LLD personalizadas.