
3 Individuazione di basso livello
Panoramica
La discovery a basso livello (LLD) rileva automaticamente le entità (ad esempio, file system, interfacce di rete) su un host e crea i corrispondenti item, trigger e grafici senza configurazione manuale per ciascuno.
Per usare LLD, si crea una regola di discovery che raccoglie dati JSON che descrivono le entità e dei prototype (item, trigger e grafico) per ogni entità.
Il JSON restituito dalla regola deve essere un array di oggetti, in cui ogni oggetto rappresenta una singola entità rilevata tramite coppie chiave-valore. Ad esempio, una regola di discovery con net.if.discovery potrebbe restituire:
[
  {"{#IFNAME}": "lo"},
  {"{#IFNAME}": "eth0"}
]
Da questo insieme di prototype viene quindi creato un corrispondente set di item, trigger e grafici: uno per ogni interfaccia (lo e eth0).
Se gli oggetti contengono chiavi nel formato {#MACRO}, tali macro vengono usate direttamente nei prototype. In caso contrario, oppure se sono necessarie macro aggiuntive/personalizzate, le macro possono essere definite manualmente e mappate ai campi JSON tramite JSONPath.
LLD può anche creare host (ad esempio, per macchine virtuali rilevate su un hypervisor) e supporta regole di discovery annidate per la discovery multilivello.
Le entità che non vengono più rilevate possono essere automaticamente disabilitate o eliminate.
Configurazione della discovery a basso livello
Illustreremo la discovery a basso livello con un esempio di discovery del file system.
Per configurare la discovery, procedere come segue:
- Andare in Data collection > Templates o Hosts.
- Fare clic su Discovery nella riga del template/host appropriato.
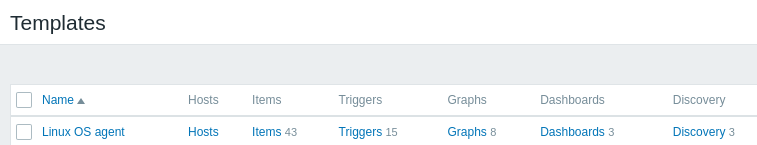
- Fare clic su Create discovery rule nell'angolo in alto a destra della schermata.
- Compilare il modulo della regola di discovery con i dettagli richiesti.
Regola di discovery
Il modulo della regola di discovery contiene cinque schede che rappresentano, da sinistra a destra, il flusso dei dati durante la discovery:
- Regola di discovery - specificare quale item integrato o script personalizzato utilizzare per recuperare i dati di discovery.
- Preprocessing - applicare il preprocessing ai dati rilevati.
- Macro LLD - consentire l'estrazione dei valori delle macro da utilizzare negli item rilevati, nei trigger e così via.
- Filtri - consentire il filtraggio dei valori rilevati.
- Override - consentire la modifica di item, trigger, grafici o prototipi di host quando applicati a oggetti rilevati specifici.
La scheda Regola di discovery contiene la chiave dell'item da utilizzare per la discovery, oltre ad alcuni attributi generali della regola di discovery:
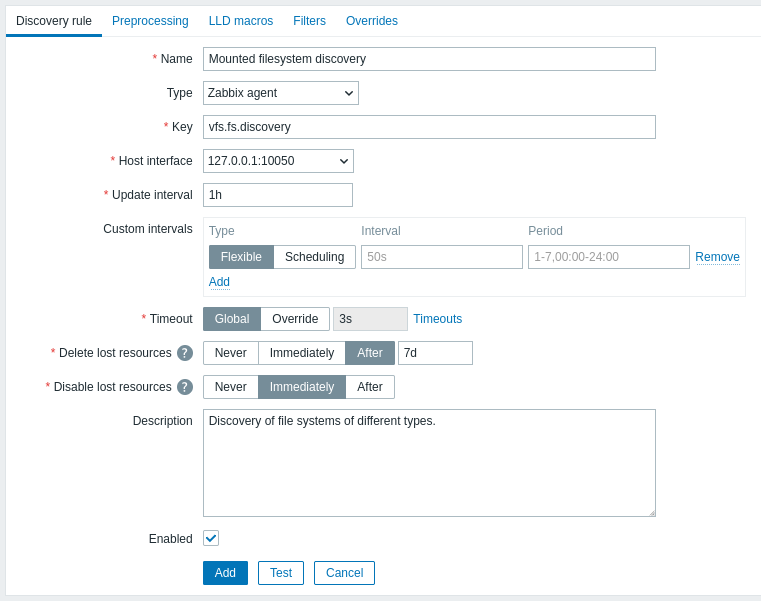
Tutti i campi obbligatori sono contrassegnati da un asterisco rosso.
| Parametro | Descrizione |
|---|---|
| Nome | Nome della regola di discovery. |
| Tipo | Tipo di controllo da eseguire per la discovery. In questo esempio utilizziamo un tipo di item Zabbix agent. La regola di discovery può anche essere un item dipendente, che dipende da un item normale. Non può dipendere da un'altra regola di discovery. Per un item dipendente, selezionare il tipo corrispondente (Item dipendente) e specificare l'item master nel campo "Item master". L'item master deve esistere. |
| Chiave | Inserire la chiave dell'item di discovery (fino a 2048 caratteri). Ad esempio, è possibile utilizzare la chiave dell'item integrato "vfs.fs.discovery" per restituire una stringa JSON con l'elenco dei file system presenti nel computer, i relativi tipi e le opzioni di mount. Si noti che un'altra opzione per la discovery dei file system consiste nell'utilizzare i risultati della discovery tramite la chiave agent "vfs.fs.get" (vedere l'esempio). |
| Intervallo di aggiornamento | Questo campo specifica la frequenza con cui Zabbix esegue la discovery. All'inizio, durante la configurazione della discovery dei file system, potrebbe essere utile impostare un intervallo breve; tuttavia, una volta verificato il corretto funzionamento, è possibile impostarlo su 30 minuti o più, poiché i file system generalmente non cambiano molto spesso. Sono supportati i suffissi temporali, ad esempio 30s, 1m, 2h, 1d. Sono supportate le macro utente. Nota: l'intervallo di aggiornamento può essere impostato su "0" solo se esistono intervalli personalizzati con un valore diverso da zero. Se impostato su "0" e se esiste un intervallo personalizzato (flessibile o pianificato) con un valore diverso da zero, l'item verrà interrogato per la durata dell'intervallo personalizzato. Le nuove regole di discovery verranno controllate entro 60 secondi dalla loro creazione, a meno che non abbiano un intervallo di aggiornamento pianificato o flessibile e Intervallo di aggiornamento sia impostato su 0. Nota: per una regola di discovery esistente, la discovery può essere eseguita immediatamente premendo il pulsante Esegui ora. |
| Intervalli personalizzati | È possibile creare regole personalizzate per il controllo dell'item: Flessibile - creare un'eccezione all'Intervallo di aggiornamento (intervallo con frequenza diversa) Pianificazione - creare una pianificazione personalizzata per le interrogazioni. Per informazioni dettagliate, vedere Intervalli personalizzati. |
| Timeout | Impostare il timeout del controllo di discovery. Selezionare l'opzione di timeout: Globale - viene utilizzato il timeout del proxy/globale (visualizzato nel campo Timeout disabilitato); Override - viene utilizzato un timeout personalizzato (impostato nel campo Timeout; intervallo consentito: 1 - 600s). Sono supportati i suffissi temporali, ad esempio 30s e 1m, e le macro utente. Facendo clic sul collegamento Timeout è possibile configurare i timeout del proxy o i timeout globali (se non viene utilizzato un proxy). Il collegamento Timeout è visibile solo agli utenti di tipo Super admin con autorizzazioni per le sezioni frontend Amministrazione > Generale o Amministrazione > Proxy. |
| Elimina risorse non più rilevate | Specificare dopo quanto tempo l'entità rilevata verrà eliminata quando il relativo stato di discovery diventa "Non più rilevata": Mai - non verrà eliminata; Immediatamente - verrà eliminata immediatamente; Dopo - verrà eliminata dopo il periodo di tempo specificato. Il valore deve essere maggiore del valore di Disabilita risorse non più rilevate. Sono supportati i suffissi temporali, ad esempio 2h e 1d. Sono supportate le macro utente. Nota: non è consigliato utilizzare "Immediatamente", poiché una modifica errata del filtro potrebbe causare l'eliminazione dell'entità e di tutti i relativi dati storici. Si noti che le risorse disabilitate manualmente non verranno eliminate dalla discovery di basso livello. |
| Disabilita risorse non più rilevate | Specificare dopo quanto tempo l'entità rilevata verrà disabilitata quando il relativo stato di discovery diventa "Non più rilevata": Mai - non verrà disabilitata; Immediatamente - verrà disabilitata immediatamente; Dopo - verrà disabilitata dopo il periodo di tempo specificato. Il valore deve essere maggiore dell'intervallo di aggiornamento della regola di discovery. Si noti che le risorse disabilitate automaticamente verranno nuovamente abilitate se rilevate di nuovo dalla discovery di basso livello. Le risorse disabilitate manualmente non verranno nuovamente abilitate se rilevate di nuovo. Questo campo non viene visualizzato se Elimina risorse non più rilevate è impostato su "Immediatamente". Sono supportati i suffissi temporali, ad esempio 2h e 1d. Sono supportate le macro utente. |
| Descrizione | Inserire una descrizione. |
| Abilitato | Se selezionato, la regola verrà elaborata. |
La cronologia della regola di discovery non viene conservata.
Preprocessing
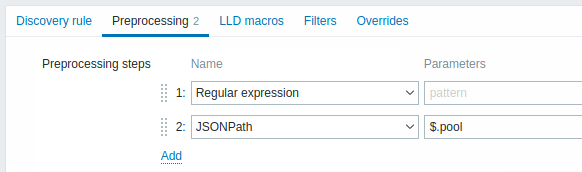
La scheda Preprocessing consente di definire le regole di trasformazione da applicare al risultato della discovery. In questo passaggio è possibile utilizzare una o più trasformazioni. Le trasformazioni vengono eseguite nell'ordine in cui sono definite. Tutto il preprocessing viene eseguito dal server Zabbix.
Vedere anche:
| Tipo | ||
|---|---|---|
| Trasformazione | Descrizione | |
| Testo | ||
| Espressione regolare | Confronta il valore ricevuto con l'espressione regolare <pattern> e sostituisce il valore con l'<output> estratto. L'espressione regolare supporta l'estrazione di un massimo di 10 gruppi acquisiti con la sequenza \N. Parametri: pattern - espressione regolare output - template di formattazione dell'output. Una sequenza di escape \N (dove N=1…9) viene sostituita con l'N-esimo gruppo corrispondente. Una sequenza di escape \0 viene sostituita con il testo corrispondente. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Sostituzione | Trova la stringa di ricerca e la sostituisce con un'altra stringa (oppure con nulla). Tutte le occorrenze della stringa di ricerca verranno sostituite. Parametri: search string - stringa da trovare e sostituire, con distinzione tra maiuscole e minuscole (obbligatorio) replacement - stringa con cui sostituire la stringa di ricerca. La stringa di sostituzione può anche essere vuota, consentendo di fatto di eliminare la stringa di ricerca quando viene trovata. È possibile utilizzare sequenze di escape per cercare o sostituire interruzioni di riga, ritorni a capo, tabulazioni e spazi "\n \r \t \s"; il carattere barra rovesciata può essere sottoposto a escape come "\\" e le sequenze di escape possono essere sottoposte a escape come "\\n". L'escape delle interruzioni di riga, dei ritorni a capo e delle tabulazioni viene eseguito automaticamente durante la discovery di basso livello. |
|
| Dati strutturati | ||
| JSONPath | Estrae un valore o un frammento dai dati JSON utilizzando la funzionalità JSONPath. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| XML XPath | Estrae un valore o un frammento dai dati XML utilizzando la funzionalità XPath. Per utilizzare questa opzione, il server Zabbix deve essere compilato con il supporto per libxml. Esempi: number(/document/item/value) estrarrà 10 da <document><item><value>10</value></item></document>number(/document/item/@attribute) estrarrà 10 da <document><item attribute="10"></item></document>/document/item estrarrà <item><value>10</value></item> da <document><item><value>10</value></item></document>Si noti che gli spazi dei nomi non sono supportati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| CSV in JSON | Converte i dati di un file CSV nel formato JSON. Per ulteriori informazioni, vedere: Preprocessing CSV in JSON. |
|
| XML in JSON | Converte i dati in formato XML in JSON. Per ulteriori informazioni, vedere: Regole di serializzazione. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| SNMP | ||
| Valore SNMP walk | Estrae il valore tramite il nome OID/MIB specificato e applica le opzioni di formattazione: Invariato - restituisce HEX-STRING come stringa esadecimale senza escape (nota: gli hint di visualizzazione vengono comunque applicati); UTF-8 da HEX-STRING - converte HEX-STRING in una stringa UTF-8; MAC da HEX-STRING - converte HEX-STRING in una stringa di indirizzo MAC (in cui ' ' verrà sostituito da ':');Intero da BITS - converte i primi 8 byte di una stringa di bit espressa come sequenza di caratteri esadecimali (ad esempio "1A 2B 3C 4D") in un intero senza segno a 64 bit. Nelle stringhe di bit più lunghe di 8 byte, i byte successivi verranno ignorati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| SNMP walk in JSON | Converte i valori SNMP in JSON. Specificare un nome di campo nel JSON e il percorso OID SNMP corrispondente. I valori dei campi verranno popolati con i valori presenti nel percorso OID SNMP specificato. È possibile utilizzare questo passaggio di preprocessing per la discovery di OID SNMP. Sono disponibili opzioni di formattazione dei valori simili a quelle del passaggio Valore SNMP walk. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Valore SNMP get | Applica le opzioni di formattazione al valore SNMP get: UTF-8 da HEX-STRING - converte HEX-STRING in una stringa UTF-8; MAC da HEX-STRING - converte HEX-STRING in una stringa di indirizzo MAC (in cui ' ' verrà sostituito da ':');Intero da BITS - converte i primi 8 byte di una stringa di bit espressa come sequenza di caratteri esadecimali (ad esempio "1A 2B 3C 4D") in un intero senza segno a 64 bit. Nelle stringhe di bit più lunghe di 8 byte, i byte successivi verranno ignorati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Script personalizzati | ||
| JavaScript | Inserire il codice JavaScript nell'editor modale che si apre facendo clic nel campo del parametro o sull'icona a forma di matita accanto ad esso. La lunghezza JavaScript disponibile dipende dal database utilizzato. Per ulteriori informazioni, vedere: Preprocessing JavaScript |
|
| Convalida | ||
| Non corrisponde all'espressione regolare | Specificare un'espressione regolare a cui il valore non deve corrispondere. Ad esempio: Error:(.*?)\.Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Verifica della presenza di errori in JSON | Verifica la presenza di un messaggio di errore a livello applicativo situato nel JSONPath. Interrompe l'elaborazione se la verifica ha esito positivo e il messaggio non è vuoto; in caso contrario, continua l'elaborazione con il valore presente prima di questo passaggio di preprocessing. Si noti che questi errori del servizio esterno vengono segnalati all'utente così come sono, senza aggiungere informazioni sul passaggio di preprocessing. Ad esempio: $.errors. Se viene ricevuto un JSON come {"errors":"e1"}, il passaggio di preprocessing successivo non verrà eseguito.Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Verifica della presenza di errori in XML | Verifica la presenza di un messaggio di errore a livello applicativo situato in XPath. Interrompe l'elaborazione se la verifica ha esito positivo e il messaggio non è vuoto; in caso contrario, continua l'elaborazione con il valore presente prima di questo passaggio di preprocessing. Si noti che questi errori del servizio esterno vengono segnalati all'utente così come sono, senza aggiungere informazioni sul passaggio di preprocessing. Non verrà segnalato alcun errore se non è possibile analizzare XML non valido. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Corrisponde all'espressione regolare | Specificare un'espressione regolare a cui il valore deve corrispondere. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Limitazione | ||
| Elimina i valori invariati con heartbeat | Elimina un valore se non è cambiato entro il periodo di tempo definito (in secondi). Sono supportati valori interi positivi per specificare i secondi (minimo: 1 secondo). In questo campo è possibile utilizzare i suffissi temporali (ad esempio 30s, 1m, 2h, 1d). In questo campo è possibile utilizzare macro utente e macro di discovery di basso livello.Per un discovery item è possibile specificare una sola opzione di limitazione. Ad esempio: 1m. Se un testo identico viene passato due volte a questa regola entro 60 secondi, verrà eliminato.Nota: la modifica dei prototipi degli item non reimposta la limitazione. La limitazione viene reimpostata solo quando vengono modificati i passaggi di preprocessing. |
|
| Prometheus | ||
| Prometheus in JSON | Converte le metriche Prometheus richieste in JSON. Per ulteriori informazioni, vedere Verifiche Prometheus. |
|
Si noti che, se la discovery rule è stata applicata all'host tramite un template, il contenuto di questa scheda è di sola lettura.
Macro personalizzate
La scheda Macro LLD consente di specificare macro personalizzate per il low-level discovery.
Le macro personalizzate sono utili nei casi in cui il JSON restituito non contenga già le macro necessarie. Ad esempio:
- La chiave nativa
vfs.fs.discoveryper il discovery dei filesystem restituisce un JSON con alcune macro LLD predefinite, come {#FSNAME}, {#FSTYPE}. Queste macro possono essere utilizzate direttamente nei prototipi di item e trigger (vedere le sezioni successive della pagina); non è necessario definire macro personalizzate; - Anche l'item agent
vfs.fs.getrestituisce un JSON con dati del filesystem, ma senza macro LLD predefinite. In questo caso è possibile definire autonomamente le macro e associarle ai valori nel JSON utilizzando JSONPath:
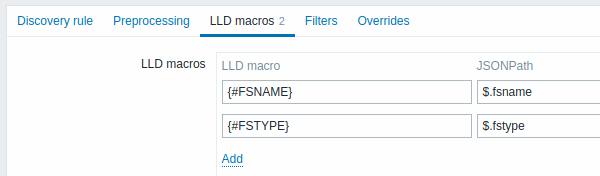
I valori estratti possono essere utilizzati negli item, nei trigger e così via rilevati. Si noti che i valori verranno estratti dal risultato del discovery e da tutti i passaggi di preprocessing eseguiti fino a quel momento.
| Parametro | Descrizione |
|---|---|
| Macro LLD | Nome della macro per il low-level discovery, utilizzando la sintassi seguente: {#MACRO}. |
| JSONPath | Percorso utilizzato per estrarre il valore della macro LLD da una riga LLD, utilizzando la sintassi JSONPath. I valori estratti dal JSON restituito vengono utilizzati per sostituire le macro LLD nei campi dei prototipi di item, trigger e così via. JSONPath può essere specificato utilizzando la notazione con punto o la notazione con parentesi quadre. La notazione con parentesi quadre deve essere utilizzata in presenza di caratteri speciali e Unicode, ad esempio $['unicode + special chars #1']['unicode + special chars #2'].Ad esempio, $.foo estrarrà "bar" e "baz" da questo JSON: [{"foo":"bar"}, {"foo":"baz"}]Si noti che $.foo estrarrà "bar" e "baz" anche da questo JSON: {"data":[{"foo":"bar"}, {"foo":"baz"}]}, perché un singolo oggetto "data" viene elaborato automaticamente (per la compatibilità con le versioni precedenti dell'implementazione del low-level discovery nelle versioni di Zabbix precedenti alla 4.2). |
Filtro
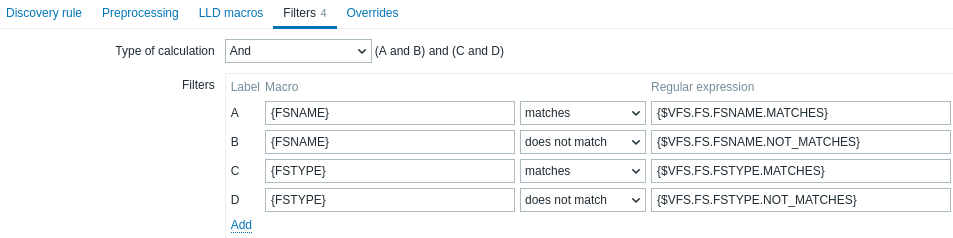
Un filtro può essere utilizzato per generare item, trigger e grafici reali solo per le entità che corrispondono ai criteri. La scheda Filtri contiene le definizioni dei filtri delle regole di discovery che consentono di filtrare i valori rilevati:
| Parametro | Descrizione |
|---|---|
| Tipo di calcolo | Sono disponibili le seguenti opzioni per il calcolo dei filtri: And - tutti i filtri devono essere superati; Or - è sufficiente superare un filtro; And/Or - utilizza And con nomi di macro diversi e Or con lo stesso nome di macro; Espressione personalizzata - consente di definire un calcolo personalizzato dei filtri. La formula deve includere tutti i filtri presenti nell'elenco. Limitata a 255 simboli. |
| Filtri | Sono disponibili i seguenti operatori per le condizioni dei filtri: corrisponde, non corrisponde, esiste, non esiste. Gli operatori corrisponde e non corrisponde richiedono una Perl Compatible Regular Expression (PCRE). È possibile inserire un'espressione regolare o fare riferimento a un'espressione regolare globale nel campo Espressione regolare. Gli operatori esiste e non esiste consentono di filtrare le entità in base alla presenza o all'assenza della macro LLD specificata nella risposta. Se nella risposta manca una macro del filtro, l'entità rilevata verrà ignorata, a meno che per questa macro non sia specificata una condizione "non esiste". Verrà visualizzato un avviso se l'assenza di una macro influisce sul risultato dell'espressione. Ad esempio, se {#B} manca in:{#A} corrisponde a 1 e {#B} corrisponde a 2 - verrà visualizzato un avviso{#A} corrisponde a 1 oppure {#B} corrisponde a 2 - nessun avviso. |
Ad esempio, se si è interessati solo ai file system C:, D: ed E:, è possibile inserire {#FSNAME} nel campo Macro e ^C|^D|^E nel campo Espressione regolare.
È inoltre possibile filtrare in base ai tipi di file system utilizzando la macro {#FSTYPE} (ad esempio, ^ext|^reiserfs) e in base ai tipi di unità (supportati solo dall'agent Windows) utilizzando la macro {#FSDRIVETYPE} (ad esempio, fixed).
Per testare un'espressione regolare è possibile utilizzare grep -E, ad esempio:
for f in ext2 nfs reiserfs smbfs;
do echo $f | grep -E '^ext|^reiserfs' || echo "SKIP: $f";
done
Un errore o un refuso nell'espressione regolare utilizzata nella regola LLD (ad esempio, un'espressione regolare errata per "File system da rilevare") può causare l'eliminazione di migliaia di elementi di configurazione, valori storici ed eventi per molti host.
Il database Zabbix in MySQL deve essere creato con distinzione tra maiuscole e minuscole affinché i nomi dei file system che differiscono solo per la combinazione di maiuscole e minuscole vengano rilevati correttamente.
Override
La scheda Override consente di impostare regole per modificare l'elenco di item, trigger, grafici, host e prototipi di discovery, oppure i relativi attributi, per gli oggetti rilevati che soddisfano determinati criteri.
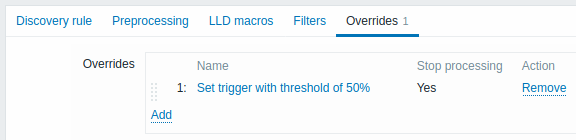
Gli Override, se presenti, vengono visualizzati in un elenco riordinabile tramite trascinamento e vengono eseguiti nell'ordine in cui sono definiti. Per configurare i dettagli di un nuovo override, fare clic su  nel blocco Override.
Per modificare un override esistente, fare clic sul nome dell'override.
Si aprirà una finestra popup che consente di modificare i dettagli della regola di override.
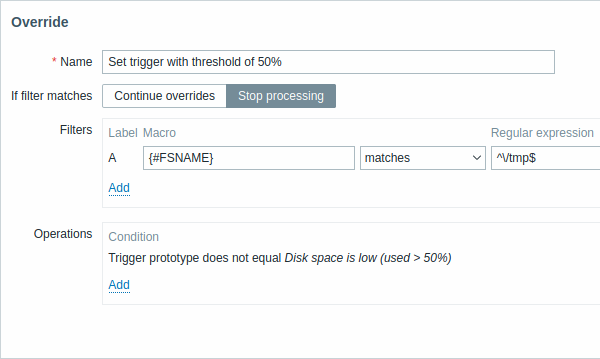
Tutti i parametri obbligatori sono contrassegnati da asterischi rossi.
| Parametro | Descrizione |
|---|---|
| Nome | Un nome univoco dell'override (per regola LLD). |
| Se il filtro corrisponde | Definisce se gli override successivi devono essere elaborati quando le condizioni del filtro sono soddisfatte: Continua override - gli override successivi verranno elaborati. Interrompi elaborazione - verranno eseguite le operazioni degli override precedenti (se presenti) e di questo override; gli override successivi verranno ignorati per le righe LLD corrispondenti. |
| Filtri | Determina a quali entità rilevate deve essere applicato l'override. I filtri degli override vengono elaborati dopo i filtri della regola di discovery e hanno la stessa funzionalità. |
| Operazioni | Le operazioni di override vengono visualizzate con i seguenti dettagli: Condizione - un tipo di oggetto e una condizione da soddisfare per il nome dell'oggetto; ad esempio: il prototipo di trigger non è uguale a Disk space is low (used > 50%). Azioni - vengono visualizzati i collegamenti per modificare e rimuovere un'operazione. |
Configurazione di un'operazione
Per configurare i dettagli di una nuova operazione, fare clic su nel blocco Operazioni.
Per modificare un'operazione esistente, fare clic su  accanto all'operazione.
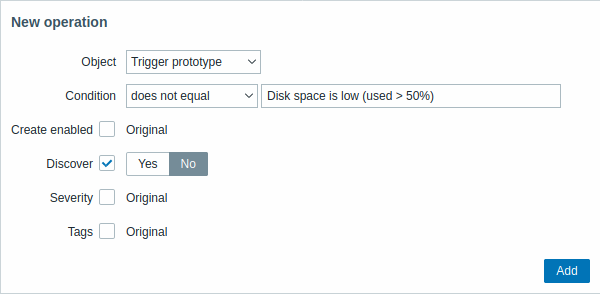
Si aprirà una finestra popup in cui è possibile modificare i dettagli dell'operazione.
| Parametro | Descrizione | ||
|---|---|---|---|
| Oggetto | Sono disponibili cinque tipi di oggetti: Prototipo di item Prototipo di trigger Prototipo di grafico Prototipo di host Prototipo di discovery |
||
| Condizione | Consente di filtrare le entità a cui deve essere applicata l'operazione. | ||
| Operatore | Operatori supportati: uguale - applica a questo prototipo diverso da - applica a tutti i prototipi tranne questo contiene - applica se il nome del prototipo contiene questa stringa non contiene - applica se il nome del prototipo non contiene questa stringa corrisponde - applica se il nome del prototipo corrisponde a un'espressione regolare non corrisponde - applica se il nome del prototipo non corrisponde a un'espressione regolare |
||
| Pattern | Un'espressione regolare o una stringa da cercare. | ||
| Oggetto: Prototipo di item | |||
| Creazione abilitata | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di item: Sì - l'item verrà aggiunto in stato abilitato. No - l'item verrà aggiunto a un'entità rilevata, ma in stato disabilitato. |
||
| Rileva | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di item: Sì - l'item verrà aggiunto. No - l'item non verrà aggiunto. |
||
| Intervallo di aggiornamento | Quando la casella di controllo è selezionata, vengono visualizzate due opzioni che consentono di impostare un intervallo diverso per l'item: Ritardo - intervallo di aggiornamento dell'item. Sono supportate le macro utente, le macro LLD e i suffissi temporali (ad esempio 30s, 1m, 2h, 1d) (il supporto per le macro LLD è stato ripristinato in Zabbix 7.4.11). Deve essere impostato su 0 se viene utilizzato Intervallo personalizzato. Intervallo personalizzato - fare clic su per specificare intervalli flessibili o pianificati. Per informazioni dettagliate, vedere Intervalli personalizzati. |
||
| Cronologia | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di impostare un periodo di conservazione diverso per la cronologia dell'item: Non memorizzare - se selezionato, la cronologia non verrà memorizzata. Memorizza fino a - se selezionato, a destra verrà visualizzato un campo di input per specificare il periodo di conservazione. Sono supportate le macro utente e le macro LLD (il supporto per le macro LLD è stato ripristinato in Zabbix 7.4.11). |
||
| Trend | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di impostare un periodo di conservazione diverso per i trend dell'item: Non memorizzare - se selezionato, i trend non verranno memorizzati. Memorizza fino a - se selezionato, a destra verrà visualizzato un campo di input per specificare il periodo di conservazione. Sono supportate le macro utente e le macro LLD (il supporto per le macro LLD è stato ripristinato in Zabbix 7.4.11). |
||
| Tag | Quando la casella di controllo è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di item, anche se i nomi dei tag coincidono. |
||
| Oggetto: Prototipo di trigger | |||
| Creazione abilitata | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di trigger: Sì - il trigger verrà aggiunto in stato abilitato. No - il trigger verrà aggiunto a un'entità rilevata, ma in stato disabilitato. |
||
| Rileva | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di trigger: Sì - il trigger verrà aggiunto. No - il trigger non verrà aggiunto. |
||
| Gravità | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti della gravità del trigger, che consentono di modificare la gravità del trigger. | ||
| Tag | Quando la casella di controllo è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di trigger, anche se i nomi dei tag coincidono. |
||
| Oggetto: Prototipo di grafico | |||
| Rileva | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di grafico: Sì - il grafico verrà aggiunto. No - il grafico non verrà aggiunto. |
||
| Oggetto: Prototipo di host | |||
| Creazione abilitata | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di host: Sì - l'host verrà creato in stato abilitato. No - l'host verrà creato in stato disabilitato. |
||
| Rileva | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di host: Sì - l'host verrà rilevato. No - l'host non verrà rilevato. |
||
| Collega template | Quando la casella di controllo è selezionata, viene visualizzato un campo di input per specificare i template. Iniziare a digitare il nome del template oppure fare clic su Seleziona accanto al campo e selezionare i template dall'elenco in una finestra popup. I template di questo override vengono aggiunti a tutti i template già collegati al prototipo di host. |
||
| Tag | Quando la casella di controllo è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di host, anche se i nomi dei tag coincidono. |
||
| Inventario dell'host | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di selezionare una modalità di inventario diversa per il prototipo di host: Disabilitato - non compilare l'inventario dell'host Manuale - fornire manualmente i dettagli Automatico - compilare automaticamente i dati dell'inventario dell'host in base alle metriche raccolte. |
||
| Oggetto: Prototipo di discovery | |||
| Creazione abilitata | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di discovery: Sì - la regola di discovery verrà aggiunta in stato abilitato. No - la regola di discovery verrà aggiunta in stato disabilitato. |
||
| Rileva | Quando la casella di controllo è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di discovery: Sì - la regola di discovery verrà aggiunta. No - la regola di discovery non verrà aggiunta. |
||
| Intervallo di aggiornamento | Quando la casella di controllo è selezionata, vengono visualizzate due opzioni che consentono di impostare un intervallo diverso per la regola di discovery: Ritardo - intervallo di aggiornamento della regola. Sono supportate le macro utente, le macro LLD e i suffissi temporali (ad esempio 30s, 1m, 2h, 1d). Deve essere impostato su 0 se viene utilizzato Intervallo personalizzato. Intervallo personalizzato - fare clic su per specificare intervalli flessibili o pianificati. Per informazioni dettagliate, vedere Intervalli personalizzati. |
||
Pulsanti del modulo
I pulsanti nella parte inferiore del modulo consentono di eseguire diverse operazioni.
 |
Aggiunge una regola di discovery. Questo pulsante è disponibile solo per le nuove regole di discovery. |
 |
Aggiorna le proprietà di una regola di discovery. Questo pulsante è disponibile solo per le regole di discovery esistenti. |
 |
Crea un'altra regola di discovery basata sulle proprietà della regola di discovery corrente. |
 |
Esegue immediatamente la discovery in base alla regola di discovery. La regola di discovery deve già esistere. Vedere ulteriori dettagli. Nota che, quando si esegue immediatamente la discovery, la cache di configurazione non viene aggiornata; pertanto, il risultato non rifletterà le modifiche più recenti alla configurazione della regola di discovery. |
 |
Verifica la configurazione della regola di discovery. Utilizzare questo pulsante per verificare le impostazioni di configurazione, come la connettività e la correttezza dei parametri, senza applicare definitivamente alcuna modifica. |
 |
Elimina la regola di discovery. |
 |
Annulla la modifica delle proprietà della regola di discovery. |
Entità rilevate
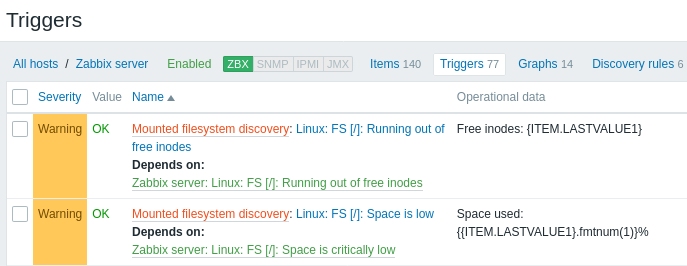
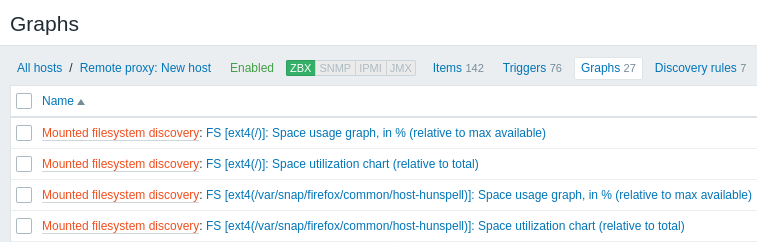
Le schermate seguenti illustrano come appaiono item, trigger e grafici rilevati nella configurazione dell'host. Le entità rilevate sono precedute da un collegamento arancione alla regola di discovery da cui provengono.
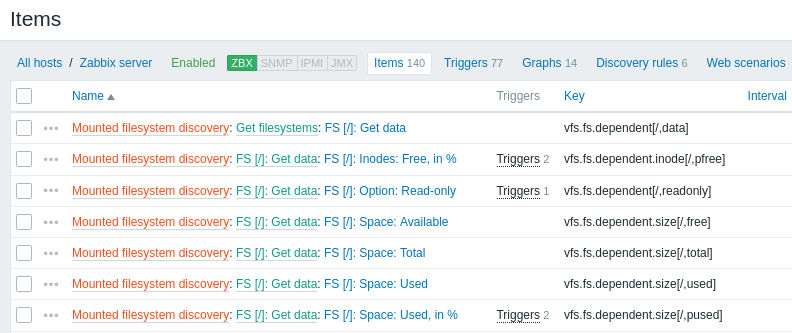
Si noti che le entità rilevate non verranno create nel caso in cui esistano già entità con gli stessi criteri di unicità, ad esempio un item con la stessa chiave o un grafico con lo stesso nome. In questo caso, nel frontend viene visualizzato un messaggio di errore che indica che la regola di low-level discovery non ha potuto creare determinate entità. La regola di discovery stessa, tuttavia, non diventerà unsupported perché alcune entità non hanno potuto essere create e hanno dovuto essere saltate. La regola di discovery continuerà a creare/aggiornare altre entità.
Se un'entità rilevata (host, file system, interfaccia, ecc.) smette di essere rilevata (o non supera più il filtro), le entità create sulla sua base possono essere automaticamente disabilitate ed eventualmente eliminate.
Le risorse perse possono essere automaticamente disabilitate in base al valore del parametro Disable lost resources. Questo riguarda host, item e trigger persi.
Le risorse perse possono essere automaticamente eliminate in base al valore del parametro Delete lost resources. Questo riguarda host, gruppi di host, item, trigger e grafici persi.
Quando le entità rilevate diventano 'Not discovered anymore', nell'elenco delle entità viene visualizzato un indicatore di durata. Spostando il puntatore del mouse su di esso, verrà visualizzato un messaggio che ne indica i dettagli di stato.
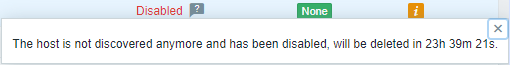
Se le entità sono state contrassegnate per l'eliminazione, ma non sono state eliminate nel momento previsto (regola di discovery o host dell'item disabilitati), verranno eliminate la volta successiva in cui la regola di discovery verrà elaborata.
Le entità che contengono altre entità contrassegnate per l'eliminazione non verranno aggiornate se modificate a livello di regola di discovery. Ad esempio, i trigger basati su LLD non verranno aggiornati se contengono item contrassegnati per l'eliminazione.
Altri tipi di discovery
Maggiori dettagli e istruzioni su altri tipi di discovery pronti all'uso sono disponibili nelle sezioni seguenti:
- discovery di interfacce di rete
- discovery di CPU e core della CPU
- discovery di OID SNMP
- discovery di oggetti JMX;
- discovery tramite query SQL ODBC
- discovery di servizi Windows
- discovery di interfacce host in Zabbix
Per maggiori dettagli sul formato JSON per gli item di discovery e un esempio su come implementare il proprio rilevatore di file system come script Perl, vedere creazione di regole LLD personalizzate.