
Scoperta a basso livello
Panoramica
La low-level discovery (LLD) rileva automaticamente le entità (ad esempio, file system, interfacce di rete) su un host e crea gli item, trigger e grafici corrispondenti senza configurazione manuale per ciascuna.
Per usare LLD, si crea una regola di discovery che raccoglie dati JSON che descrivono le entità e dei prototype (item, trigger e grafico) per ogni entità.
Il JSON restituito dalla regola deve essere un array di oggetti, in cui ogni oggetto rappresenta una singola entità scoperta tramite coppie chiave-valore. Ad esempio, una regola di discovery con net.if.discovery potrebbe restituire:
[
  {"{#IFNAME}": "lo"},
  {"{#IFNAME}": "eth0"}
]
Un insieme corrispondente di item, trigger e grafici viene quindi creato dai prototype: uno per ogni interfaccia (lo e eth0).
Se gli oggetti contengono chiavi nel formato {#MACRO}, tali macro vengono usate direttamente nei prototype. In caso contrario, oppure se sono necessarie macro aggiuntive/personalizzate, le macro possono essere definite manualmente e mappate ai campi JSON tramite JSONPath.
LLD può anche creare host (ad esempio, per macchine virtuali rilevate su un hypervisor) e supporta regole di discovery nidificate per il rilevamento multilivello.
Le entità che non vengono più rilevate possono essere automaticamente disabilitate o eliminate.
Configurazione della discovery a basso livello
Illustreremo la discovery a basso livello con un esempio di discovery del file system.
Per configurare la discovery, procedere come segue:
- Andare su Data collection > Templates o Hosts.
- Fare clic su Discovery nella riga del template/host appropriato.
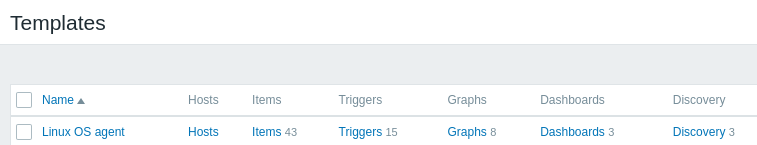
- Fare clic su Create discovery rule nell'angolo in alto a destra della schermata.
- Compilare il modulo della regola di discovery con i dettagli richiesti.
Regola di discovery
Il modulo della regola di discovery contiene cinque schede che rappresentano, da sinistra a destra, il flusso dei dati durante la discovery:
- Regola di discovery - specificare, soprattutto, l'item integrato o lo script personalizzato per recuperare i dati di discovery.
- Preprocessing - applicare il preprocessing ai dati rilevati.
- Macro LLD - consentire l'estrazione dei valori delle macro da utilizzare negli item rilevati, nei trigger e così via.
- Filtri - consentire il filtraggio dei valori rilevati.
- Override - consentire la modifica di item, trigger, grafici o prototipi di host quando vengono applicati a oggetti rilevati specifici.
La scheda Regola di discovery contiene la chiave dell'item da utilizzare per la discovery (oltre ad alcuni attributi generali della regola di discovery):
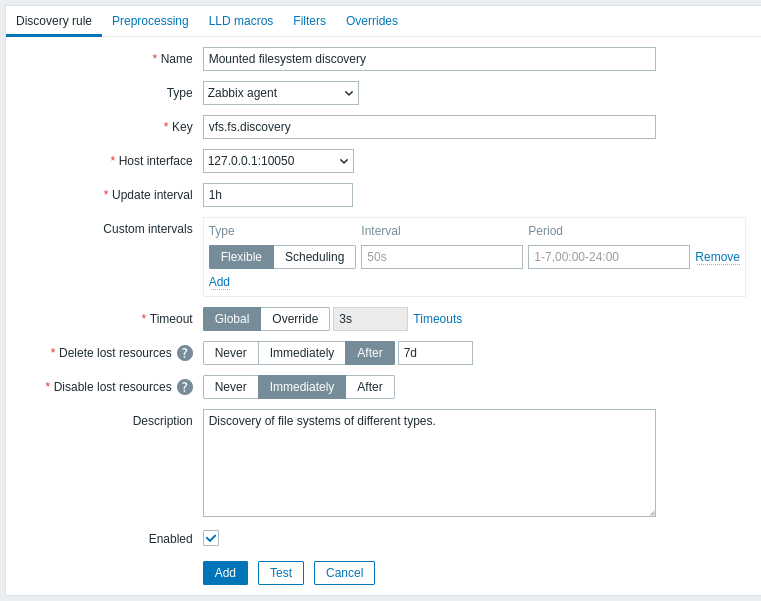
Tutti i campi di input obbligatori sono contrassegnati da un asterisco rosso.
| Parametro | Descrizione |
|---|---|
| Nome | Nome della regola di discovery. |
| Tipo | Tipo di controllo da eseguire per la discovery. In questo esempio utilizziamo un tipo di item Zabbix agent. La regola di discovery può anche essere un item dipendente, che dipende da un item normale. Non può dipendere da un'altra regola di discovery. Per un item dipendente, selezionare il tipo corrispondente (Item dipendente) e specificare l'item master nel campo 'Item master'. L'item master deve esistere. |
| Chiave | Inserire la chiave dell'item di discovery (fino a 2048 caratteri). Ad esempio, è possibile utilizzare la chiave dell'item integrato "vfs.fs.discovery" per restituire una stringa JSON con l'elenco dei file system presenti nel computer, i relativi tipi e le opzioni di mount. Si noti che un'altra opzione per la discovery dei file system consiste nell'utilizzare i risultati della discovery tramite la chiave agent "vfs.fs.get" (vedere l'esempio). |
| Intervallo di aggiornamento | Questo campo specifica la frequenza con cui Zabbix esegue la discovery. All'inizio, quando si sta configurando la discovery dei file system, potrebbe essere utile impostare un intervallo breve; tuttavia, una volta verificato il corretto funzionamento, è possibile impostarlo su 30 minuti o più, poiché i file system generalmente non cambiano molto spesso. Sono supportati i suffissi temporali, ad esempio 30s, 1m, 2h, 1d. Sono supportate le macro utente. Nota: l'intervallo di aggiornamento può essere impostato su '0' solo se esistono intervalli personalizzati con un valore diverso da zero. Se impostato su '0' e se esiste un intervallo personalizzato (flessibile o pianificato) con un valore diverso da zero, l'item verrà interrogato per la durata dell'intervallo personalizzato. Le nuove regole di discovery verranno controllate entro 60 secondi dalla loro creazione, a meno che non abbiano un intervallo di aggiornamento Pianificazione o Flessibile e Intervallo di aggiornamento sia impostato su 0. Nota: per una regola di discovery esistente, la discovery può essere eseguita immediatamente premendo il pulsante Esegui ora. |
| Intervalli personalizzati | È possibile creare regole personalizzate per il controllo dell'item: Flessibile - creare un'eccezione all'Intervallo di aggiornamento (intervallo con frequenza diversa) Pianificazione - creare una pianificazione personalizzata per le interrogazioni. Per informazioni dettagliate, vedere Intervalli personalizzati. |
| Timeout | Impostare il timeout del controllo di discovery. Selezionare l'opzione di timeout: Globale - viene utilizzato il timeout del proxy/globale (visualizzato nel campo Timeout disabilitato); Override - viene utilizzato un timeout personalizzato (impostato nel campo Timeout; intervallo consentito: 1 - 600s). Sono supportati i suffissi temporali, ad esempio 30s e 1m, e le macro utente. Facendo clic sul link Timeout è possibile configurare i timeout del proxy o i timeout globali (se non viene utilizzato un proxy). Il link Timeout è visibile solo agli utenti di tipo Super admin con autorizzazioni per le sezioni frontend Amministrazione > Generale o Amministrazione > Proxy. |
| Elimina risorse non più rilevate | Specificare dopo quanto tempo l'entità rilevata verrà eliminata quando il suo stato di discovery diventa "Non più rilevata": Mai - non verrà eliminata; Immediatamente - verrà eliminata immediatamente; Dopo - verrà eliminata dopo il periodo di tempo specificato. Il valore deve essere maggiore del valore di Disabilita risorse non più rilevate. Sono supportati i suffissi temporali, ad esempio 2h e 1d. Sono supportate le macro utente. Nota: non è consigliato utilizzare "Immediatamente", poiché una semplice modifica errata del filtro potrebbe causare l'eliminazione dell'entità insieme a tutti i dati storici. Si noti che le risorse disabilitate manualmente non verranno eliminate dalla discovery di basso livello. |
| Disabilita risorse non più rilevate | Specificare dopo quanto tempo l'entità rilevata verrà disabilitata quando il suo stato di discovery diventa "Non più rilevata": Mai - non verrà disabilitata; Immediatamente - verrà disabilitata immediatamente; Dopo - verrà disabilitata dopo il periodo di tempo specificato. Il valore deve essere maggiore dell'intervallo di aggiornamento della regola di discovery. Si noti che le risorse disabilitate automaticamente verranno nuovamente abilitate se vengono rilevate di nuovo dalla discovery di basso livello. Le risorse disabilitate manualmente non verranno nuovamente abilitate se vengono rilevate di nuovo. Questo campo non viene visualizzato se Elimina risorse non più rilevate è impostato su "Immediatamente". Sono supportati i suffissi temporali, ad esempio 2h e 1d. Sono supportate le macro utente. |
| Descrizione | Inserire una descrizione. |
| Abilitato | Se selezionato, la regola verrà elaborata. |
La cronologia della regola di discovery non viene conservata.
Preprocessing
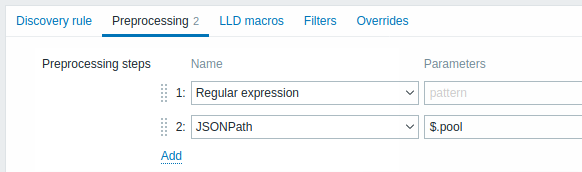
La scheda Preprocessing consente di definire le regole di trasformazione da applicare al risultato della discovery. In questo passaggio è possibile utilizzare una o più trasformazioni. Le trasformazioni vengono eseguite nell'ordine in cui sono definite. Tutto il preprocessing viene eseguito dal server Zabbix.
Vedere anche:
| Tipo | ||
|---|---|---|
| Trasformazione | Descrizione | |
| Testo | ||
| Espressione regolare | Confronta il valore ricevuto con l'espressione regolare <pattern> e sostituisce il valore con l'<output> estratto. L'espressione regolare supporta l'estrazione di un massimo di 10 gruppi acquisiti con la sequenza \N. Parametri: pattern - espressione regolare output - template di formattazione dell'output. Una sequenza di escape \N (dove N=1…9) viene sostituita con l'N-esimo gruppo corrispondente. Una sequenza di escape \0 viene sostituita con il testo corrispondente. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Sostituisci | Trova la stringa di ricerca e la sostituisce con un'altra stringa (oppure con niente). Tutte le occorrenze della stringa di ricerca verranno sostituite. Parametri: search string - stringa da trovare e sostituire, con distinzione tra maiuscole e minuscole (obbligatorio) replacement - stringa con cui sostituire la stringa di ricerca. La stringa di sostituzione può anche essere vuota, consentendo di fatto di eliminare la stringa di ricerca quando viene trovata. È possibile utilizzare sequenze di escape per cercare o sostituire interruzioni di riga, ritorni a capo, tabulazioni e spazi "\n \r \t \s"; la barra rovesciata può essere sottoposta a escape come "\\" e le sequenze di escape possono essere sottoposte a escape come "\\n". L'escape delle interruzioni di riga, dei ritorni a capo e delle tabulazioni viene eseguito automaticamente durante la low-level discovery. |
|
| Dati strutturati | ||
| JSONPath | Estrae un valore o un frammento dai dati JSON utilizzando la funzionalità JSONPath. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| XML XPath | Estrae un valore o un frammento dai dati XML utilizzando la funzionalità XPath. Per utilizzare questa opzione, il server Zabbix deve essere compilato con il supporto per libxml. Esempi: number(/document/item/value) estrarrà 10 da <document><item><value>10</value></item></document>number(/document/item/@attribute) estrarrà 10 da <document><item attribute="10"></item></document>/document/item estrarrà <item><value>10</value></item> da <document><item><value>10</value></item></document>Si noti che gli spazi dei nomi non sono supportati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| CSV in JSON | Converte i dati di un file CSV nel formato JSON. Per ulteriori informazioni, vedere: Preprocessing da CSV a JSON. |
|
| XML in JSON | Converte i dati in formato XML in JSON. Per ulteriori informazioni, vedere: Regole di serializzazione. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| SNMP | ||
| Valore SNMP walk | Estrae il valore tramite il nome OID/MIB specificato e applica le opzioni di formattazione: Invariato - restituisce HEX-STRING come stringa esadecimale senza escape (nota: i suggerimenti di visualizzazione vengono comunque applicati); UTF-8 da HEX-STRING - converte HEX-STRING in una stringa UTF-8; MAC da HEX-STRING - converte HEX-STRING in una stringa di indirizzo MAC (in cui ' ' verrà sostituito da ':');Intero da BITS - converte i primi 8 byte di una stringa di bit espressa come sequenza di caratteri esadecimali (ad esempio, "1A 2B 3C 4D") in un intero senza segno a 64 bit. Nelle stringhe di bit più lunghe di 8 byte, i byte successivi verranno ignorati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| SNMP walk in JSON | Converte i valori SNMP in JSON. Specificare un nome di campo nel JSON e il percorso OID SNMP corrispondente. I valori dei campi verranno popolati con i valori del percorso OID SNMP specificato. È possibile utilizzare questo passaggio di preprocessing per la discovery degli OID SNMP. Sono disponibili opzioni di formattazione dei valori simili a quelle del passaggio Valore SNMP walk. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Valore SNMP get | Applica le opzioni di formattazione al valore SNMP get: UTF-8 da HEX-STRING - converte HEX-STRING in una stringa UTF-8; MAC da HEX-STRING - converte HEX-STRING in una stringa di indirizzo MAC (in cui ' ' verrà sostituito da ':');Intero da BITS - converte i primi 8 byte di una stringa di bit espressa come sequenza di caratteri esadecimali (ad esempio, "1A 2B 3C 4D") in un intero senza segno a 64 bit. Nelle stringhe di bit più lunghe di 8 byte, i byte successivi verranno ignorati. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Script personalizzati | ||
| JavaScript | Inserire il codice JavaScript nell'editor modale che si apre facendo clic nel campo del parametro o sull'icona a forma di matita accanto ad esso. La lunghezza JavaScript disponibile dipende dal database utilizzato. Per ulteriori informazioni, vedere: Preprocessing JavaScript |
|
| Convalida | ||
| Non corrisponde all'espressione regolare | Specificare un'espressione regolare a cui il valore non deve corrispondere. Ad esempio, Error:(.*?)\.Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Verifica della presenza di errori in JSON | Verifica la presenza di un messaggio di errore a livello applicativo situato in JSONPath. Interrompe l'elaborazione se la verifica ha esito positivo e il messaggio non è vuoto; in caso contrario, continua l'elaborazione con il valore precedente a questo passaggio di preprocessing. Si noti che questi errori del servizio esterno vengono segnalati all'utente così come sono, senza aggiungere informazioni sul passaggio di preprocessing. Ad esempio, $.errors. Se viene ricevuto un JSON come {"errors":"e1"}, il passaggio di preprocessing successivo non verrà eseguito.Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Verifica della presenza di errori in XML | Verifica la presenza di un messaggio di errore a livello applicativo situato in Xpath. Interrompe l'elaborazione se la verifica ha esito positivo e il messaggio non è vuoto; in caso contrario, continua l'elaborazione con il valore precedente a questo passaggio di preprocessing. Si noti che questi errori del servizio esterno vengono segnalati all'utente così come sono, senza aggiungere informazioni sul passaggio di preprocessing. Non verrà segnalato alcun errore se non è possibile analizzare XML non valido. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Corrisponde all'espressione regolare | Specificare un'espressione regolare a cui il valore deve corrispondere. Se si seleziona la casella Personalizzato in caso di errore, è possibile specificare opzioni personalizzate per la gestione degli errori: eliminare il valore, impostare un valore specificato oppure impostare un messaggio di errore specificato. |
|
| Limitazione | ||
| Elimina i valori invariati con heartbeat | Elimina un valore se non è cambiato entro il periodo di tempo definito (in secondi). Sono supportati valori interi positivi per specificare i secondi (minimo: 1 secondo). In questo campo è possibile utilizzare i suffissi temporali (ad esempio, 30s, 1m, 2h, 1d). In questo campo è possibile utilizzare macro utente e macro di low-level discovery.Per un discovery item è possibile specificare una sola opzione di limitazione. Ad esempio, 1m. Se un testo identico viene passato due volte a questa regola entro 60 secondi, verrà eliminato.Nota: la modifica dei prototipi degli item non reimposta la limitazione. La limitazione viene reimpostata solo quando vengono modificati i passaggi di preprocessing. |
|
| Prometheus | ||
| Prometheus in JSON | Converte le metriche Prometheus richieste in JSON. Per ulteriori informazioni, vedere Controlli Prometheus. |
|
Si noti che, se la discovery rule è stata applicata al host tramite un template, il contenuto di questa scheda è di sola lettura.
Macro personalizzate
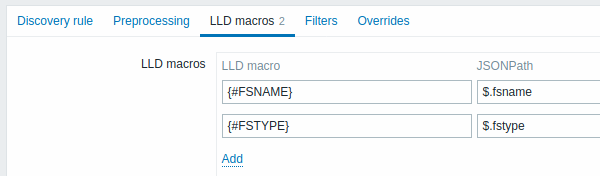
La scheda LLD macros consente di specificare LLD macros personalizzate quando il JSON restituito non contiene già chiavi nel formato {#MACRO}.
Ad esempio, la chiave dell'item agent vfs.fs.get restituisce dati JSON filesystem senza alcuna LLD macro predefinita.
Qui, si definiscono manualmente le macro e le si mappano ai valori nel JSON usando espressioni JSONPath:
| Parameter | Description |
|---|---|
| LLD macro | Nome della LLD macro nel formato {#MACRO}. |
| JSONPath | Espressione che definisce quale valore estrarre da ciascuna entità rilevata nell'array JSON. Ad esempio, $.foo estrae "bar" e "baz" da[{"foo":"bar"}, {"foo":"baz"}].JSONPath supporta sia la notazione con punto sia quella con parentesi quadre. La notazione con parentesi quadre deve essere usata per chiavi contenenti caratteri speciali o Unicode, ad esempio, $['unicode + special chars #1']['unicode + special chars #2']. |
La regola di discovery deve restituire un array JSON alla radice ($.).
Per compatibilità con le versioni precedenti, è accettato anche un oggetto JSON contenente un singolo array "data". In questo caso, l'array "data" viene automaticamente estratto:
{"data":[{"foo":"bar"}, {"foo":"baz"}]}Filtro
Un filtro può essere utilizzato per generare item, trigger e grafici reali solo per le entità che corrispondono ai criteri. La scheda Filtri contiene le definizioni dei filtri delle regole di discovery che consentono di filtrare i valori rilevati:
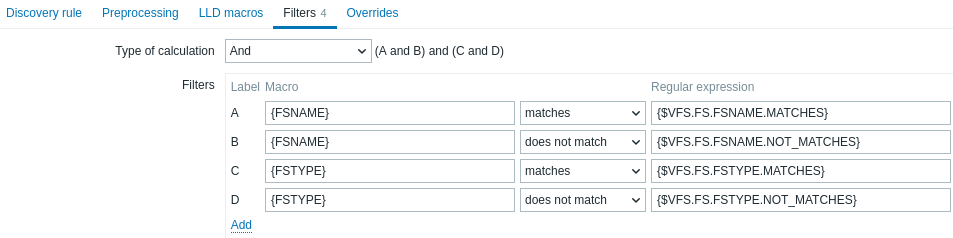
| Parametro | Descrizione |
|---|---|
| Tipo di calcolo | Sono disponibili le seguenti opzioni per il calcolo dei filtri: And - tutti i filtri devono essere superati; Or - è sufficiente superare un filtro; And/Or - utilizza And con nomi di macro diversi e Or con lo stesso nome di macro; Espressione personalizzata - consente di definire un calcolo personalizzato dei filtri. La formula deve includere tutti i filtri presenti nell'elenco. Limitata a 255 simboli. |
| Filtri | Sono disponibili i seguenti operatori per le condizioni dei filtri: corrisponde, non corrisponde, esiste, non esiste. Gli operatori corrisponde e non corrisponde richiedono una Perl Compatible Regular Expression (PCRE). È possibile inserire un'espressione regolare o fare riferimento a un'espressione regolare globale nel campo Espressione regolare. Gli operatori esiste e non esiste consentono di filtrare le entità in base alla presenza o all'assenza della macro LLD specificata nella risposta. Se nella risposta manca una macro del filtro, l'entità rilevata verrà ignorata, a meno che per questa macro non sia specificata una condizione "non esiste". Verrà visualizzato un avviso se l'assenza di una macro influisce sul risultato dell'espressione. Ad esempio, se {#B} manca in:{#A} corrisponde a 1 e {#B} corrisponde a 2 - verrà visualizzato un avviso{#A} corrisponde a 1 oppure {#B} corrisponde a 2 - nessun avviso. |
Ad esempio, se si è interessati solo ai file system C:, D: ed E:, è possibile inserire {#FSNAME} nel campo Macro e ^C|^D|^E nel campo Espressione regolare.
È inoltre possibile filtrare in base ai tipi di file system utilizzando la macro {#FSTYPE} (ad esempio, ^ext|^reiserfs) e in base ai tipi di unità (supportati solo dall'agent Windows) utilizzando la macro {#FSDRIVETYPE} (ad esempio, fixed).
Per testare un'espressione regolare è possibile utilizzare grep -E, ad esempio:
for f in ext2 nfs reiserfs smbfs;
do echo $f | grep -E '^ext|^reiserfs' || echo "SKIP: $f";
done
Un errore o un refuso nell'espressione regolare utilizzata nella regola LLD (ad esempio, un'espressione regolare errata per "File system da rilevare") può causare l'eliminazione di migliaia di elementi di configurazione, valori storici ed eventi per numerosi host.
Il database Zabbix in MySQL deve essere creato con distinzione tra maiuscole e minuscole affinché i nomi dei file system che differiscono solo per la combinazione di maiuscole e minuscole vengano rilevati correttamente.
Sovrascritture
La scheda Sovrascritture consente di impostare regole per modificare l'elenco dei prototipi di item, trigger, grafici, host e discovery, oppure i relativi attributi, per gli oggetti rilevati che soddisfano determinati criteri.
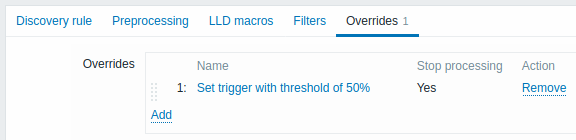
Le sovrascritture, se presenti, vengono visualizzate in un elenco riordinabile tramite trascinamento e vengono eseguite nell'ordine in cui sono definite. Per configurare i dettagli di una nuova sovrascrittura, fare clic su  nel blocco Sovrascritture.
Per modificare una sovrascrittura esistente, fare clic sul nome della sovrascrittura.
Si aprirà una finestra popup che consente di modificare i dettagli della regola di sovrascrittura.
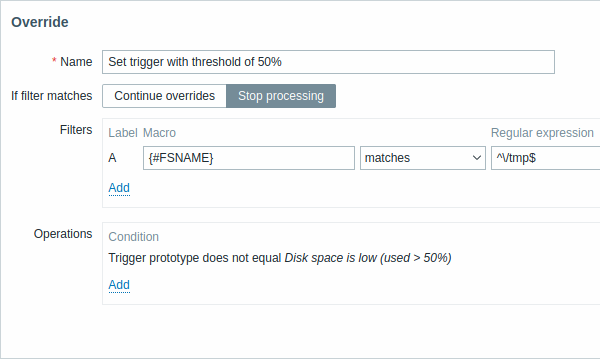
Tutti i parametri obbligatori sono contrassegnati da asterischi rossi.
| Parametro | Descrizione |
|---|---|
| Nome | Un nome univoco della sovrascrittura (per regola LLD). |
| Se il filtro corrisponde | Definisce se le sovrascritture successive devono essere elaborate quando le condizioni del filtro sono soddisfatte: Continua con le sovrascritture - le sovrascritture successive verranno elaborate. Interrompi elaborazione - verranno eseguite le operazioni precedenti, se presenti, e quelle di questa sovrascrittura; le sovrascritture successive verranno ignorate per le righe LLD corrispondenti. |
| Filtri | Determina a quali entità rilevate deve essere applicata la sovrascrittura. I filtri delle sovrascritture vengono elaborati dopo i filtri della regola di discovery e hanno la stessa funzionalità. |
| Operazioni | Le operazioni di sovrascrittura vengono visualizzate con i seguenti dettagli: Condizione - un tipo di oggetto e una condizione da soddisfare per il nome dell'oggetto; ad esempio: il prototipo di trigger non è uguale a Spazio su disco insufficiente (utilizzato > 50%). Azioni - vengono visualizzati i collegamenti per modificare e rimuovere un'operazione. |
Configurazione di un'operazione
Per configurare i dettagli di una nuova operazione, fare clic su nel blocco Operazioni.
Per modificare un'operazione esistente, fare clic su  accanto all'operazione.
Si aprirà una finestra popup in cui è possibile modificare i dettagli dell'operazione.
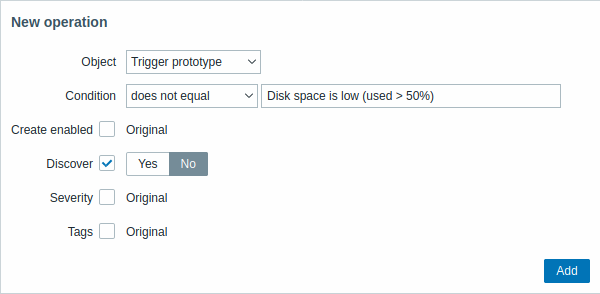
| Parametro | Descrizione | ||
|---|---|---|---|
| Oggetto | Sono disponibili cinque tipi di oggetti: Prototipo di item Prototipo di trigger Prototipo di grafico Prototipo di host Prototipo di discovery |
||
| Condizione | Consente di filtrare le entità a cui deve essere applicata l'operazione. | ||
| Operatore | Operatori supportati: è uguale a - applica a questo prototipo non è uguale a - applica a tutti i prototipi tranne questo contiene - applica se il nome del prototipo contiene questa stringa non contiene - applica se il nome del prototipo non contiene questa stringa corrisponde - applica se il nome del prototipo corrisponde a un'espressione regolare non corrisponde - applica se il nome del prototipo non corrisponde a un'espressione regolare |
||
| Pattern | Un'espressione regolare o una stringa da cercare. | ||
| Oggetto: Prototipo di item | |||
| Crea abilitato | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di item: Sì - l'item verrà aggiunto in stato abilitato. No - l'item verrà aggiunto a un'entità rilevata, ma in stato disabilitato. |
||
| Rileva | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di item: Sì - l'item verrà aggiunto. No - l'item non verrà aggiunto. |
||
| Intervallo di aggiornamento | Quando la casella è selezionata, vengono visualizzate due opzioni che consentono di impostare un intervallo diverso per l'item: Ritardo - intervallo di aggiornamento dell'item. Sono supportate le macro utente, le macro LLD e i suffissi temporali (ad es. 30s, 1m, 2h, 1d). Deve essere impostato su 0 se viene utilizzato Intervallo personalizzato. Intervallo personalizzato - fare clic su per specificare intervalli flessibili o pianificati. Per informazioni dettagliate, vedere Intervalli personalizzati. |
||
| Cronologia | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di impostare periodi diversi di conservazione della cronologia per l'item: Non memorizzare - se selezionato, la cronologia non verrà memorizzata. Memorizza fino a - se selezionato, a destra verrà visualizzato un campo di input per specificare il periodo di conservazione. Sono supportate le macro utente e le macro LLD. |
||
| Trend | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di impostare periodi diversi di conservazione dei trend per l'item: Non memorizzare - se selezionato, i trend non verranno memorizzati. Memorizza fino a - se selezionato, a destra verrà visualizzato un campo di input per specificare il periodo di conservazione. Sono supportate le macro utente e le macro LLD. |
||
| Tag | Quando la casella è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di item, anche se i nomi dei tag coincidono. |
||
| Oggetto: Prototipo di trigger | |||
| Crea abilitato | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di trigger: Sì - il trigger verrà aggiunto in stato abilitato. No - il trigger verrà aggiunto a un'entità rilevata, ma in stato disabilitato. |
||
| Rileva | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di trigger: Sì - il trigger verrà aggiunto. No - il trigger non verrà aggiunto. |
||
| Gravità | Quando la casella è selezionata, vengono visualizzati i pulsanti della gravità del trigger, che consentono di modificarne la gravità. | ||
| Tag | Quando la casella è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di trigger, anche se i nomi dei tag coincidono. |
||
| Oggetto: Prototipo di grafico | |||
| Rileva | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di grafico: Sì - il grafico verrà aggiunto. No - il grafico non verrà aggiunto. |
||
| Oggetto: Prototipo di host | |||
| Crea abilitato | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di host: Sì - l'host verrà creato in stato abilitato. No - l'host verrà creato in stato disabilitato. |
||
| Rileva | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di host: Sì - l'host verrà rilevato. No - l'host non verrà rilevato. |
||
| Collega template | Quando la casella è selezionata, viene visualizzato un campo di input per specificare i template. Iniziare a digitare il nome del template oppure fare clic su Seleziona accanto al campo e selezionare i template dall'elenco in una finestra popup. I template di questa sovrascrittura vengono aggiunti a tutti i template già collegati al prototipo di host. |
||
| Tag | Quando la casella è selezionata, viene visualizzato un nuovo blocco che consente di specificare coppie tag-valore. Sono supportate le macro utente e le macro LLD. Questi tag verranno aggiunti ai tag specificati nel prototipo di host, anche se i nomi dei tag coincidono. |
||
| Inventario dell'host | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di selezionare una diversa modalità di inventario per il prototipo di host: Disabilitato - non compilare l'inventario dell'host Manuale - fornire manualmente i dettagli Automatico - compilare automaticamente i dati dell'inventario dell'host in base alle metriche raccolte. |
||
| Oggetto: Prototipo di discovery | |||
| Crea abilitato | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di discovery: Sì - la regola di discovery verrà aggiunta in stato abilitato. No - la regola di discovery verrà aggiunta in stato disabilitato. |
||
| Rileva | Quando la casella è selezionata, vengono visualizzati i pulsanti che consentono di sovrascrivere le impostazioni originali del prototipo di discovery: Sì - la regola di discovery verrà aggiunta. No - la regola di discovery non verrà aggiunta. |
||
| Intervallo di aggiornamento | Quando la casella è selezionata, vengono visualizzate due opzioni che consentono di impostare un intervallo diverso per la regola di discovery: Ritardo - intervallo di aggiornamento della regola. Sono supportate le macro utente, le macro LLD e i suffissi temporali (ad es. 30s, 1m, 2h, 1d). Deve essere impostato su 0 se viene utilizzato Intervallo personalizzato. Intervallo personalizzato - fare clic su per specificare intervalli flessibili o pianificati. Per informazioni dettagliate, vedere Intervalli personalizzati. |
||
Pulsanti del modulo
I pulsanti nella parte inferiore del modulo consentono di eseguire diverse operazioni.
 |
Aggiunge una regola di discovery. Questo pulsante è disponibile solo per le nuove regole di discovery. |
 |
Aggiorna le proprietà di una regola di discovery. Questo pulsante è disponibile solo per le regole di discovery esistenti. |
 |
Crea un'altra regola di discovery basata sulle proprietà della regola di discovery corrente. |
 |
Esegue immediatamente la discovery in base alla regola di discovery. La regola di discovery deve già esistere. Vedere ulteriori dettagli. Nota che, quando si esegue immediatamente la discovery, la cache di configurazione non viene aggiornata; pertanto, il risultato non rifletterà le modifiche più recenti alla configurazione della regola di discovery. |
 |
Verifica la configurazione della regola di discovery. Utilizzare questo pulsante per verificare le impostazioni di configurazione, come la connettività e la correttezza dei parametri, senza applicare definitivamente alcuna modifica. |
 |
Elimina la regola di discovery. |
 |
Annulla la modifica delle proprietà della regola di discovery. |
Entità rilevate
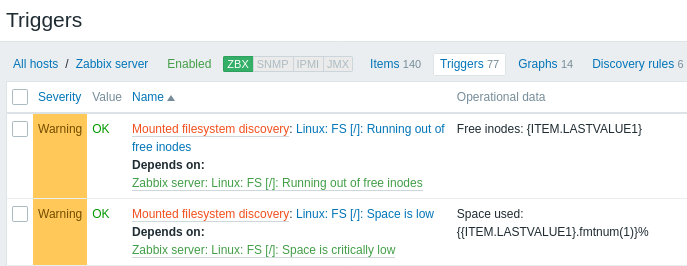
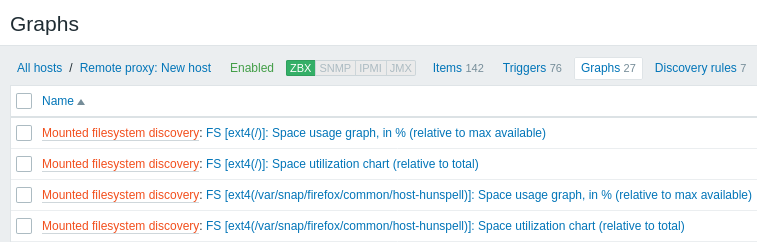
Le schermate seguenti illustrano come appaiono item, trigger e grafici rilevati nella configurazione dell'host. Le entità rilevate sono precedute da un collegamento arancione alla regola di discovery da cui provengono.
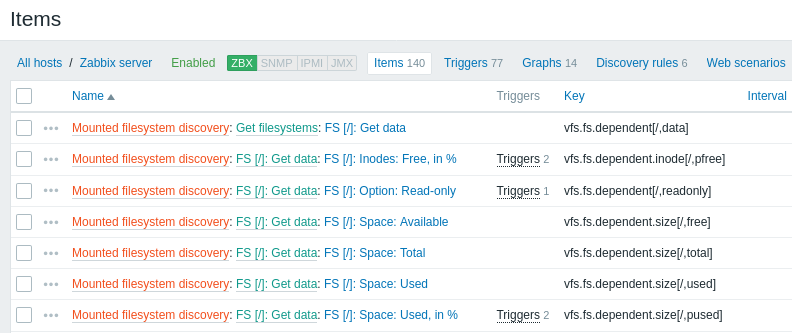
Si noti che le entità rilevate non verranno create nel caso in cui esistano già entità con gli stessi criteri di unicità, ad esempio un item con la stessa chiave o un grafico con lo stesso nome. In questo caso, nel frontend viene visualizzato un messaggio di errore che indica che la regola di low-level discovery non ha potuto creare determinate entità. La regola di discovery stessa, tuttavia, non diventerà unsupported perché alcune entità non hanno potuto essere create e hanno dovuto essere saltate. La regola di discovery continuerà a creare/aggiornare altre entità.
Se un'entità rilevata (host, file system, interfaccia, ecc.) smette di essere rilevata (o non supera più il filtro), le entità create sulla sua base possono essere automaticamente disabilitate ed eventualmente eliminate.
Le risorse perse possono essere automaticamente disabilitate in base al valore del parametro Disable lost resources. Questo riguarda host, item e trigger persi.
Le risorse perse possono essere automaticamente eliminate in base al valore del parametro Delete lost resources. Questo riguarda host, gruppi di host, item, trigger e grafici persi.
Quando le entità rilevate diventano 'Not discovered anymore', nell'elenco delle entità viene visualizzato un indicatore di durata. Spostando il puntatore del mouse su di esso, verrà visualizzato un messaggio che ne indica i dettagli di stato.
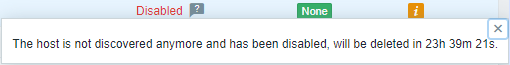
Se le entità sono state contrassegnate per l'eliminazione, ma non sono state eliminate nel momento previsto (regola di discovery o host dell'item disabilitati), verranno eliminate la volta successiva in cui la regola di discovery verrà elaborata.
Le entità che contengono altre entità contrassegnate per l'eliminazione non verranno aggiornate se modificate a livello di regola di discovery. Ad esempio, i trigger basati su LLD non verranno aggiornati se contengono item contrassegnati per l'eliminazione.
Altri tipi di discovery
Maggiori dettagli e istruzioni su altri tipi di discovery pronti all'uso sono disponibili nelle sezioni seguenti:
- discovery di interfacce di rete
- discovery di CPU e core della CPU
- discovery di OID SNMP
- discovery di oggetti JMX;
- discovery tramite query SQL ODBC
- discovery di servizi Windows
- discovery di interfacce host in Zabbix
Per maggiori dettagli sul formato JSON per gli item di discovery e un esempio su come implementare il proprio rilevatore di file system come script Perl, vedere creazione di regole LLD personalizzate.