
2. Дополнительные сведения о предобработке
Обзор
В этом разделе приведены сведения о предварительной обработке значений элементов данных. Предварительная обработка значений элементов данных позволяет определить и выполнить правила преобразования для полученных значений элементов данных.
Предварительная обработка управляется процессом диспетчера предварительной обработки и рабочими процессами предварительной обработки, которые выполняют этапы предварительной обработки. Все значения, для которых выполняется предварительная обработка (до Zabbix 7.4.1 — все значения), полученные от различных сборщиков данных, проходят через диспетчер предварительной обработки перед добавлением в кэш истории. Для взаимодействия между сборщиками данных (опросчиками, трапперами и т. д.) и процессом предварительной обработки используется межпроцессное взаимодействие на основе сокетов. Этапы предварительной обработки выполняет либо сервер Zabbix, либо прокси (для элементов данных, которые отслеживаются прокси).
Обработка значений элементов данных
Чтобы визуализировать поток данных от источника данных к базе данных Zabbix, можно использовать следующую упрощенную диаграмму:
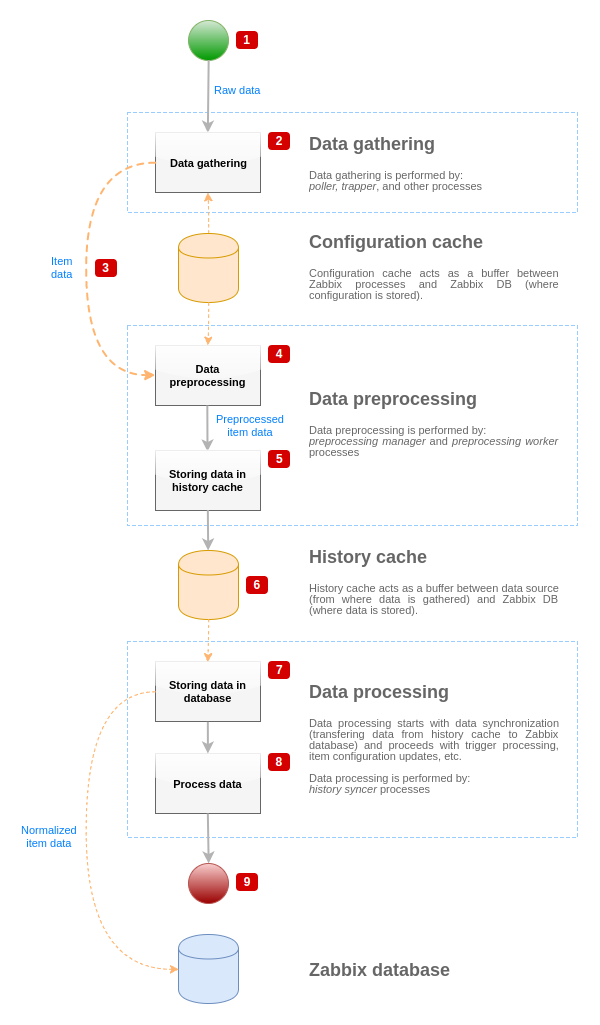
На приведенной выше диаграмме в упрощенном виде показаны только процессы, объекты и действия, связанные с обработкой значений элементов данных. На диаграмме не показаны изменения направления потока в зависимости от условий, обработка ошибок и циклы. Локальный кэш данных менеджера предварительной обработки также не показан, поскольку он не влияет непосредственно на поток данных. Цель этой диаграммы - показать процессы, участвующие в обработке значений элементов данных, и способы их взаимодействия.
- Сбор данных начинается с необработанных данных из источника данных. На этом этапе данные содержат только идентификатор, временную метку и значение (значений может быть несколько).
- Независимо от типа используемого сборщика данных принцип остается одинаковым для активных и пассивных проверок, элементов данных типа trapper и т. д., поскольку изменяются только формат данных и инициатор обмена данными (сборщик данных либо ожидает подключения и данных, либо инициирует обмен данными и запрашивает данные). Необработанные данные проверяются, а конфигурация элемента данных извлекается из кэша конфигурации (данные дополняются данными конфигурации).
- Для передачи данных от сборщиков данных менеджеру предварительной обработки используется механизм IPC на основе сокетов. На этом этапе сборщик данных продолжает собирать данные, не дожидаясь ответа от менеджера предварительной обработки.
- Выполняется предварительная обработка данных. Она включает выполнение шагов предварительной обработки и обработку зависимых элементов данных.
Элемент данных может изменить свое состояние на NOT SUPPORTED во время предварительной обработки, если какой-либо шаг предварительной обработки завершится ошибкой.
- Данные истории из локального кэша данных менеджера предварительной обработки выгружаются в кэш истории.
- На этом этапе поток данных останавливается до следующей синхронизации кэша истории (когда процесс синхронизации истории выполняет синхронизацию данных).
- Процесс синхронизации начинается с нормализации данных перед их сохранением в базе данных Zabbix.
Нормализация данных выполняет преобразование в требуемый тип элемента данных (тип, определенный в конфигурации элемента данных), включая усечение текстовых данных в соответствии с предопределенными размерами, разрешенными для этих типов (
HISTORY_STR_VALUE_LENдля строк,HISTORY_TEXT_VALUE_LENдля текста иHISTORY_LOG_VALUE_LENдля значений журнала). После завершения нормализации данные отправляются в базу данных Zabbix.
Элемент данных может изменить свое состояние на NOT SUPPORTED, если нормализация данных завершится ошибкой (например, если текстовое значение невозможно преобразовать в число).
- Собранные данные обрабатываются: проверяются триггеры, обновляется конфигурация элемента данных, если элемент данных переходит в состояние NOT SUPPORTED, и т. д.
- С точки зрения обработки значений элементов данных это считается завершением потока данных.
Предобработка значения элемента данных
Предобработка данных выполняется в следующие этапы:
- Если у элемента данных отсутствуют как предобработка, так и зависимые элементы данных, его значение либо добавляется в кэш истории, либо отправляется менеджеру LLD. В противном случае значение элемента данных передаётся менеджеру предобработки с использованием механизма IPC на основе UNIX-сокетов (до версии Zabbix 7.4.1 все значения перед добавлением в кэш истории или отправкой менеджеру LLD передаются через менеджер предобработки).
- Создаётся задача предобработки, которая добавляется в очередь, после чего рабочие процессы предобработки уведомляются о новой задаче.
- На этом этапе поток данных останавливается до тех пор, пока не появится хотя бы один свободный рабочий процесс предобработки (то есть рабочий процесс, не выполняющий никаких задач).
- Когда рабочий процесс предобработки становится доступен, он извлекает из очереди следующую задачу.
- После завершения предобработки (как при неудачном, так и при успешном выполнении этапов предобработки) обработанное значение добавляется в очередь завершённых задач, а менеджер уведомляется о новой завершённой задаче.
- Менеджер предобработки преобразует результат в требуемый формат (определяемый типом значения элемента данных), а затем либо добавляет его в кэш истории, либо отправляет менеджеру LLD.
- Если у обработанного элемента данных есть зависимые элементы данных, они добавляются в очередь предобработки вместе с обработанным значением главного элемента данных. Зависимые элементы данных помещаются в очередь в обход обычных запросов на предобработку значений, но только для главных элементов данных, у которых задано значение и которые не находятся в состоянии NOT SUPPORTED.
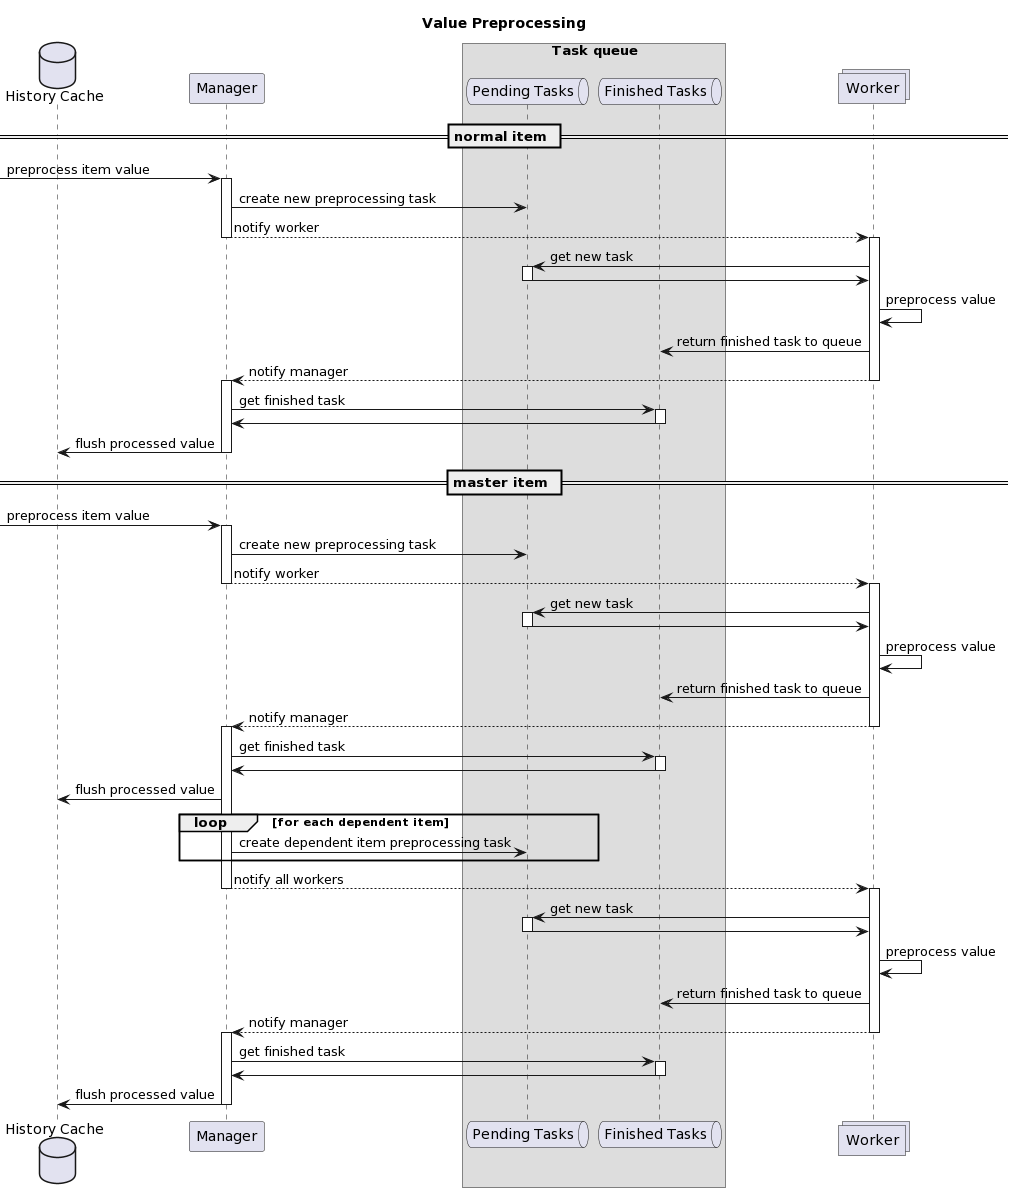
Обратите внимание, что на диаграмме предобработка главного элемента данных показана в упрощённом виде: кэширование результатов предобработки пропущено.
Очередь предварительной обработки
Очередь предварительной обработки организована следующим образом:
- список ожидающих задач:
- задачи, созданные непосредственно из запросов на предварительную обработку значений, в порядке их получения
- список немедленных задач (обрабатываются перед ожидающими задачами):
- задачи тестирования (создаются в ответ на запросы веб-интерфейса на тестирование элементов данных/предварительной обработки)
- задачи зависимых элементов данных
- последовательные задачи (задачи, которые должны выполняться в строгом порядке):
- использующие шаги предварительной обработки с последним значением:
- изменение
- ограничение частоты
- JavaScript (кэширование байт-кода)
- кэширование предварительной обработки зависимых элементов данных
- использующие шаги предварительной обработки с последним значением:
- список завершенных задач
Кэширование предварительной обработки
Кэширование предварительной обработки было введено для повышения производительности предварительной обработки нескольких зависимых элементов данных с похожими шагами предварительной обработки (что часто является результатом LLD).
Кэширование выполняется путем предварительной обработки одного зависимого элемента данных и повторного использования некоторых внутренних данных предварительной обработки для остальных зависимых элементов данных. Кэш предварительной обработки поддерживается только для первого шага предварительной обработки следующих типов:
- Шаблон Prometheus (индексирует входные данные по метрикам)
- JSONPath (анализирует данные в дерево объектов и индексирует первое выражение
[?(@.path == "value")])
Рабочие процессы предварительной обработки
Файл конфигурации сервера Zabbix позволяет задать количество потоков рабочих процессов предварительной обработки. Для задания количества предварительно запущенных экземпляров рабочих процессов предварительной обработки следует использовать параметр конфигурации StartPreprocessors. Это количество должно как минимум соответствовать числу доступных ядер ЦП.
Если задачи предварительной обработки не требуют значительных ресурсов ЦП и включают частые сетевые запросы, рекомендуется настроить дополнительные рабочие процессы. Оптимальное количество рабочих процессов предварительной обработки можно определить с учетом множества факторов, включая количество «обрабатываемых» элементов данных (элементов данных, для которых требуется выполнить какие-либо шаги предварительной обработки), количество процессов сбора данных, среднее количество шагов предварительной обработки для элемента данных и т. д. Недостаточное количество рабочих процессов может привести к высокому потреблению памяти. Для устранения неполадок, связанных с чрезмерным потреблением памяти в вашей установке Zabbix, см. раздел Профилирование чрезмерного потребления памяти с помощью tcmalloc.
Однако при условии отсутствия ресурсоемких операций предварительной обработки, таких как разбор больших фрагментов XML/JSON, количество рабочих процессов предварительной обработки может соответствовать общему количеству процессов сбора данных. В этом случае для собранных данных в основном (за исключением случаев, когда данные от процесса сбора поступают пакетами) будет доступен как минимум один незанятый рабочий процесс предварительной обработки.
Слишком большое количество процессов сбора данных (процессов опроса, процессов опроса недоступных узлов сети, процессов опроса ODBC, процессов опроса HTTP, процессов опроса Java, процессов проверки доступности, процессов-трапперов, процессов опроса прокси), а также менеджер IPMI, SNMP-траппер и рабочие процессы предварительной обработки могут исчерпать ограничение на количество файловых дескрипторов для одного процесса менеджера предварительной обработки.
Исчерпание ограничения на количество файловых дескрипторов для одного процесса приведет к остановке сервера Zabbix, обычно вскоре после запуска, но иногда это может занять больше времени.
Чтобы избежать подобных проблем, проверьте файл конфигурации сервера Zabbix, чтобы оптимизировать количество одновременных проверок и процессов.
Кроме того, при необходимости убедитесь, что ограничение на количество файловых дескрипторов установлено на достаточно высоком уровне, проверив и скорректировав системные ограничения.
Конвейер обработки значений
Обработка значений элементов данных выполняется в несколько шагов (или фаз) несколькими процессами. Это может привести к следующему:
- Зависимый элемент данных может получить значения, в то время как значение ГЛАВНОГО элемента данных не может быть сохранено.
Этого можно добиться в следующем случае:
- Главный элемент данных имеет тип значения
UINT(можно использовать элемент данных типа trapper), а зависимый элемент данных — тип значенияTEXT. - Для главного и зависимого элементов данных не требуются шаги предварительной обработки.
- Главному элементу данных следует передать текстовое значение (например, "abc").
- Поскольку шаги предварительной обработки отсутствуют, менеджер предварительной обработки проверяет, не находится ли главный элемент данных в состоянии NOT SUPPORTED и задано ли значение (оба условия выполняются), после чего ставит зависимый элемент данных в очередь с тем же значением, что и у главного элемента данных (поскольку шаги предварительной обработки отсутствуют).
- Когда главный и зависимый элементы данных достигают фазы синхронизации истории, главный элемент данных переходит в состояние NOT SUPPORTED из-за ошибки преобразования значения (текстовые данные нельзя преобразовать в беззнаковое целое число).
- Главный элемент данных имеет тип значения
В результате зависимый элемент данных получает значение, а главный элемент данных изменяет свое состояние на NOT SUPPORTED.
- Зависимый элемент данных получает значение, отсутствующее в истории главного элемента данных.
Этот случай очень похож на предыдущий, за исключением типа главного элемента данных.
Например, если для главного элемента данных используется тип
CHAR, его значение будет усечено на этапе синхронизации истории, тогда как зависимые элементы данных получат свои значения из исходного (неусеченного) значения главного элемента данных.