
2 Détails du prétraitement
Vue d’ensemble
Cette section fournit des informations détaillées sur le prétraitement des valeurs des éléments. Le prétraitement des éléments vous permet de définir et d’exécuter des règles de transformation pour les valeurs reçues des éléments.
Le prétraitement est géré par le processus de gestionnaire du prétraitement ainsi que par les processus workers de prétraitement qui exécutent les étapes de prétraitement. Toutes les valeurs soumises au prétraitement (avant Zabbix 7.4.1, toutes les valeurs), reçues de différents collecteurs de données, passent par le gestionnaire du prétraitement avant d’être ajoutées au cache de l’historique. Une communication IPC basée sur des sockets est utilisée entre les collecteurs de données (pollers, trappers, etc.) et le processus de prétraitement. Le serveur Zabbix ou le proxy Zabbix (pour les éléments surveillés par le proxy) exécute les étapes de prétraitement.
Traitement de la valeur d’un élément
Pour visualiser le flux de données depuis la source de données jusqu’à la base de données Zabbix, nous pouvons utiliser le diagramme simplifié suivant :
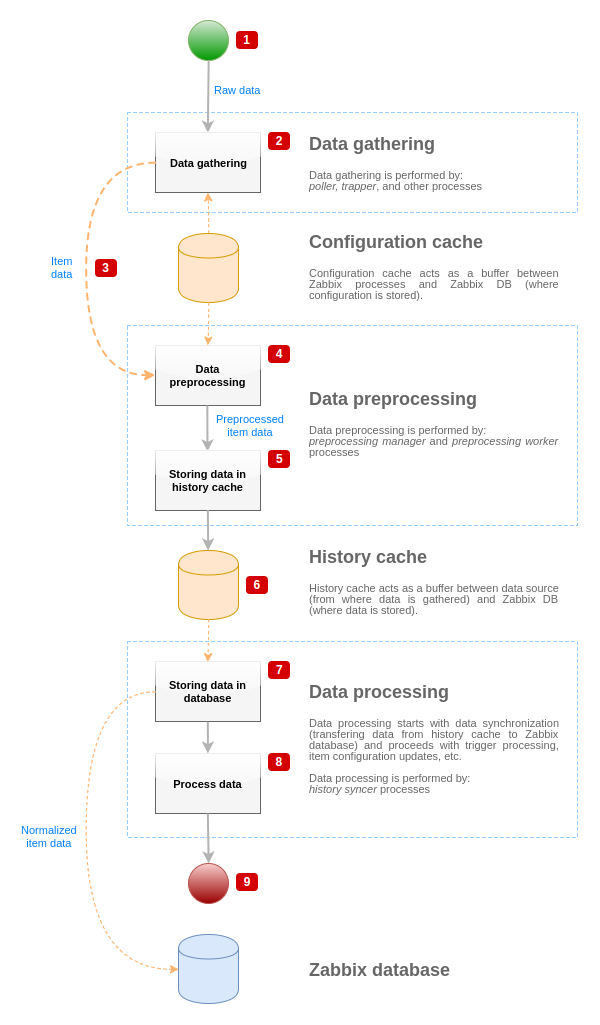
Le diagramme ci-dessus présente uniquement, sous une forme simplifiée, les processus, objets et actions liés au traitement de la valeur d’un élément. Le diagramme ne montre pas les changements conditionnels de direction, la gestion des erreurs ni les boucles. Le cache local de données du gestionnaire du prétraitement n’est pas représenté non plus, car il n’affecte pas directement le flux de données. L’objectif de ce diagramme est de présenter les processus impliqués dans le traitement de la valeur d’un élément et la manière dont ils interagissent.
- La collecte des données commence par les données brutes provenant d’une source de données. À ce stade, les données contiennent uniquement l’ID, l’horodatage et la valeur (plusieurs valeurs peuvent également être présentes).
- Quel que soit le type de collecteur de données utilisé, le principe est le même pour les vérifications actives ou passives, les éléments de type trapper, etc., car seul le format des données et l’initiateur de la communication changent (soit le collecteur de données attend une connexion et des données, soit il initie la communication et demande les données). Les données brutes sont validées et la configuration de l’élément est récupérée depuis le cache de configuration (les données sont enrichies avec les données de configuration).
- Un mécanisme IPC basé sur des sockets est utilisé pour transmettre les données des collecteurs de données au gestionnaire du prétraitement. À ce stade, le collecteur de données continue de collecter les données sans attendre la réponse du gestionnaire du prétraitement.
- Le prétraitement des données est effectué. Cela inclut l’exécution des étapes de prétraitement et le traitement des éléments dépendants.
Un élément peut passer à l’état NOT SUPPORTED pendant le prétraitement si l’une des étapes de prétraitement échoue.
- Les données d’historique du cache local de données du gestionnaire du prétraitement sont transférées vers le cache d’historique.
- À ce stade, le flux de données s’arrête jusqu’à la prochaine synchronisation du cache d’historique (lorsque le processus de synchronisation de l’historique effectue la synchronisation des données).
- Le processus de synchronisation commence par la normalisation des données avant leur stockage dans la base de données Zabbix.
La normalisation des données effectue les conversions vers le type d’élément souhaité (type défini dans la configuration de l’élément), y compris la troncature des données textuelles selon les tailles prédéfinies autorisées pour ces types (
HISTORY_STR_VALUE_LENpour les chaînes,HISTORY_TEXT_VALUE_LENpour le texte etHISTORY_LOG_VALUE_LENpour les valeurs de journal). Les données sont envoyées à la base de données Zabbix une fois la normalisation terminée.
Un élément peut passer à l’état NOT SUPPORTED si la normalisation des données échoue (par exemple, lorsqu’une valeur textuelle ne peut pas être convertie en nombre).
- Les données collectées sont traitées : les déclencheurs sont vérifiés, la configuration de l’élément est mise à jour si l’élément passe à l’état NOT SUPPORTED, etc.
- Cela est considéré comme la fin du flux de données du point de vue du traitement de la valeur d’un élément.
Prétraitement de la valeur d’un élément
Le prétraitement des données s’effectue selon les étapes suivantes :
- Si l’élément n’a ni prétraitement ni éléments dépendants, sa valeur est soit ajoutée au cache de l’historique, soit envoyée au gestionnaire LLD. Sinon, la valeur de l’élément est transmise au gestionnaire de prétraitement à l’aide d’un mécanisme IPC basé sur un socket UNIX (avant Zabbix 7.4.1, toutes les valeurs étaient transmises au gestionnaire de prétraitement avant d’être ajoutées au cache de l’historique ou envoyées au gestionnaire LLD).
- Une tâche de prétraitement est créée et ajoutée à la file d’attente, puis les workers de prétraitement sont informés de la nouvelle tâche.
- À ce stade, le flux de données s’arrête jusqu’à ce qu’au moins un worker de prétraitement soit disponible (c’est-à-dire qu’il n’exécute aucune tâche).
- Lorsqu’un worker de prétraitement est disponible, il récupère la tâche suivante dans la file d’attente.
- Une fois le prétraitement terminé (que l’exécution des étapes de prétraitement ait réussi ou échoué), la valeur prétraitée est ajoutée à la file d’attente des tâches terminées et le gestionnaire est informé de la nouvelle tâche terminée.
- Le gestionnaire de prétraitement convertit le résultat au format souhaité (défini par le type de valeur de l’élément), puis l’ajoute au cache de l’historique ou l’envoie au gestionnaire LLD.
- Si l’élément traité possède des éléments dépendants, ceux-ci sont ajoutés à la file d’attente de prétraitement avec la valeur prétraitée de l’élément maître. Les éléments dépendants sont placés dans la file d’attente sans passer par les demandes normales de prétraitement des valeurs, mais uniquement pour les éléments maîtres dont la valeur est définie et qui ne sont pas dans l’état NOT SUPPORTED.

Notez que, dans le diagramme, le prétraitement de l’élément maître est légèrement simplifié, car la mise en cache du prétraitement n’est pas représentée.
File d’attente du prétraitement
La file d’attente du prétraitement est organisée comme suit :
- la liste des tâches en attente :
- les tâches créées directement à partir des demandes de prétraitement des valeurs, dans l’ordre où elles ont été reçues
- la liste des tâches immédiates (traitées avant les tâches en attente) :
- les tâches de test (créées en réponse aux demandes de test des éléments/du prétraitement par l’interface)
- les tâches des éléments dépendants
- les tâches séquentielles (tâches qui doivent être exécutées dans un ordre strict) :
- comportant des étapes de prétraitement utilisant la dernière valeur :
- changement
- limitation
- JavaScript (mise en cache du bytecode)
- mise en cache du prétraitement des éléments dépendants
- comportant des étapes de prétraitement utilisant la dernière valeur :
- la liste des tâches terminées
Mise en cache du prétraitement
La mise en cache du prétraitement a été introduite pour améliorer les performances du prétraitement de plusieurs éléments dépendants ayant des étapes de prétraitement similaires (ce qui est un résultat courant de la découverte de bas niveau).
La mise en cache est effectuée en prétraitant un élément dépendant et en réutilisant certaines données internes de prétraitement pour les autres éléments dépendants. Le cache de prétraitement est pris en charge uniquement pour la première étape de prétraitement des types suivants :
- Motif Prometheus (indexe l’entrée par métriques)
- JSONPath (analyse les données dans une arborescence d’objets et indexe la première expression
[?(@.path == "value")])
Workers de prétraitement
Le fichier de configuration du serveur Zabbix permet de définir le nombre de threads de workers de prétraitement. Le paramètre de configuration StartPreprocessors doit être utilisé pour définir le nombre d'instances de workers de prétraitement démarrées au préalable, qui doit au minimum correspondre au nombre de cœurs CPU disponibles.
Si les tâches de prétraitement ne sont pas limitées par le CPU et impliquent des requêtes réseau fréquentes, il est recommandé de configurer des workers supplémentaires. Le nombre optimal de workers de prétraitement peut être déterminé par de nombreux facteurs, notamment le nombre d'éléments « prétraitables » (éléments nécessitant l'exécution d'étapes de prétraitement), le nombre de processus de collecte des données, le nombre moyen d'étapes de prétraitement par élément, etc. Un nombre insuffisant de workers peut entraîner une utilisation élevée de la mémoire. Pour résoudre les problèmes d'utilisation excessive de la mémoire dans votre installation Zabbix, consultez Profilage de l'utilisation excessive de la mémoire avec tcmalloc.
Cependant, en supposant qu'il n'y ait pas d'opérations de prétraitement lourdes, telles que l'analyse de grandes portions XML/JSON, le nombre de workers de prétraitement peut correspondre au nombre total de collecteurs de données. Ainsi, il y aura généralement (sauf lorsque les données du collecteur arrivent en bloc) au moins un worker de prétraitement disponible pour les données collectées.
Un trop grand nombre de processus de collecte des données (pollers, pollers inaccessibles, pollers ODBC, pollers HTTP, pollers Java, pingers, trappers, proxypollers), associé au gestionnaire IPMI, au trapper SNMP et aux workers de prétraitement, peut épuiser la limite de descripteurs de fichiers par processus du gestionnaire de prétraitement.
L'épuisement de la limite de descripteurs de fichiers par processus entraînera l'arrêt du serveur Zabbix, généralement peu après son démarrage, mais parfois après un délai plus long.
Pour éviter ces problèmes, consultez le fichier de configuration du serveur Zabbix afin d'optimiser le nombre de vérifications et de processus simultanés.
En outre, si nécessaire, assurez-vous que la limite de descripteurs de fichiers est suffisamment élevée en vérifiant et en ajustant les limites du système.
Pipeline de traitement des valeurs
Le traitement de la valeur d’un élément est exécuté en plusieurs étapes (ou phases) par plusieurs processus. Cela peut entraîner les situations suivantes :
- Un élément dépendant peut recevoir des valeurs, alors que LA valeur maître ne le peut pas.
Ce résultat peut être obtenu avec le cas d’utilisation suivant :
- L’élément maître est de type
UINT(un élément trapper peut être utilisé), tandis que l’élément dépendant est de typeTEXT. - Aucune étape de prétraitement n’est requise pour l’élément maître ni pour l’élément dépendant.
- Une valeur textuelle (par exemple, « abc ») doit être transmise à l’élément maître.
- Comme aucune étape de prétraitement ne doit être exécutée, le gestionnaire de prétraitement vérifie que l’élément maître n’est pas dans l’état NOT SUPPORTED et qu’une valeur est définie (ces deux conditions sont remplies), puis met en file d’attente l’élément dépendant avec la même valeur que l’élément maître (puisqu’aucune étape de prétraitement n’est requise).
- Lorsque les éléments maître et dépendant atteignent tous deux la phase de synchronisation de l’historique, l’élément maître passe à l’état NOT SUPPORTED en raison de l’erreur de conversion de la valeur (les données textuelles ne peuvent pas être converties en entier non signé).
- L’élément maître est de type
En conséquence, l’élément dépendant reçoit une valeur, tandis que l’élément maître passe à l’état NOT SUPPORTED.
- Un élément dépendant reçoit une valeur qui n’est pas présente dans l’historique de l’élément maître.
Le cas d’utilisation est très similaire au précédent, à l’exception du type de l’élément maître.
Par exemple, si le type
CHARest utilisé pour l’élément maître, sa valeur sera tronquée lors de la phase de synchronisation de l’historique, tandis que les éléments dépendants recevront leurs valeurs à partir de la valeur initiale (non tronquée) de l’élément maître.