
2 Szczegóły przetwarzania wstępnego
Przegląd
W tej sekcji przedstawiono szczegółowe informacje dotyczące wstępnego przetwarzania wartości pozycji. Wstępne przetwarzanie wartości pozycji umożliwia definiowanie i wykonywanie reguł transformacji dla odebranych wartości pozycji.
Wstępne przetwarzanie jest zarządzane przez proces menedżera wstępnego przetwarzania oraz procesy robocze wstępnego przetwarzania, które wykonują poszczególne kroki. Wszystkie wartości podlegające wstępnemu przetwarzaniu (przed wersją Zabbix 7.4.1 — wszystkie wartości), odebrane z różnych modułów gromadzących dane, przechodzą przez menedżera wstępnego przetwarzania przed dodaniem do pamięci podręcznej historii. Do komunikacji IPC między modułami gromadzącymi dane (pollerami, trapperami itd.) a procesem wstępnego przetwarzania używana jest komunikacja oparta na gniazdach. Kroki wstępnego przetwarzania wykonuje serwer Zabbix albo proxy Zabbix (w przypadku pozycji monitorowanych przez proxy).
Przetwarzanie wartości pozycji
Aby zobrazować przepływ danych od źródła danych do bazy danych Zabbix, możemy użyć następującego uproszczonego diagramu:
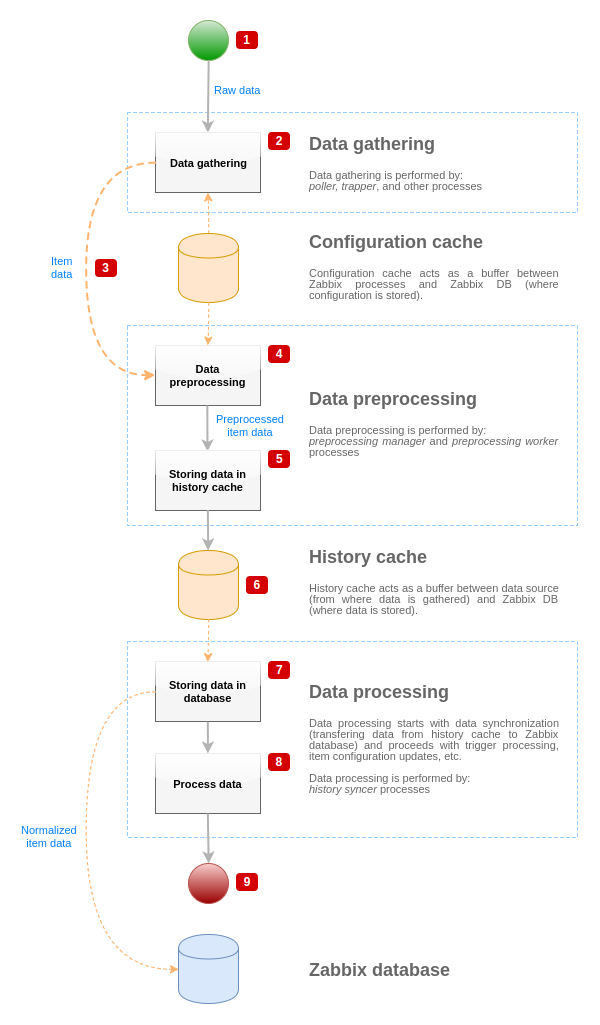
Powyższy diagram przedstawia w uproszczonej formie wyłącznie procesy, obiekty i działania związane z przetwarzaniem wartości pozycji. Diagram nie przedstawia warunkowych zmian kierunku, obsługi błędów ani pętli. Nie pokazano również lokalnej pamięci podręcznej danych menedżera przetwarzania wstępnego, ponieważ nie wpływa ona bezpośrednio na przepływ danych. Celem tego diagramu jest przedstawienie procesów związanych z przetwarzaniem wartości pozycji oraz sposobu ich wzajemnego oddziaływania.
- Gromadzenie danych rozpoczyna się od surowych danych ze źródła danych. W tym momencie dane zawierają wyłącznie identyfikator, znacznik czasu i wartość (może ich być również wiele).
- Niezależnie od używanego typu modułu gromadzącego dane, zasada jest taka sama dla aktywnych i pasywnych kontroli, pozycji typu trapper itd.; zmienia się jedynie format danych i inicjator komunikacji (moduł gromadzący dane oczekuje na połączenie i dane albo inicjuje komunikację i żąda danych). Surowe dane są weryfikowane, a konfiguracja pozycji jest pobierana z pamięci podręcznej konfiguracji (dane są wzbogacane o dane konfiguracyjne).
- Do przekazywania danych z modułów gromadzących dane do menedżera przetwarzania wstępnego używany jest mechanizm IPC oparty na gniazdach. W tym momencie moduł gromadzący dane kontynuuje ich gromadzenie bez oczekiwania na odpowiedź od menedżera przetwarzania wstępnego.
- Wykonywane jest przetwarzanie wstępne danych. Obejmuje ono wykonywanie kroków przetwarzania wstępnego oraz przetwarzanie pozycji zależnych.
Pozycja może zmienić swój stan na NOT SUPPORTED podczas przetwarzania wstępnego, jeśli którykolwiek z kroków przetwarzania wstępnego zakończy się niepowodzeniem.
- Dane historyczne z lokalnej pamięci podręcznej danych menedżera przetwarzania wstępnego są opróżniane do pamięci podręcznej historii.
- W tym momencie przepływ danych zostaje wstrzymany do czasu następnej synchronizacji pamięci podręcznej historii (gdy proces synchronizatora historii wykonuje synchronizację danych).
- Proces synchronizacji rozpoczyna się od normalizacji danych przed zapisaniem ich w bazie danych Zabbix.
Normalizacja danych obejmuje konwersję do żądanego typu pozycji (typu zdefiniowanego w konfiguracji pozycji), w tym obcinanie danych tekstowych na podstawie predefiniowanych rozmiarów dozwolonych dla tych typów (
HISTORY_STR_VALUE_LENdla ciągu znaków,HISTORY_TEXT_VALUE_LENdla tekstu iHISTORY_LOG_VALUE_LENdla wartości dziennika). Po zakończeniu normalizacji dane są wysyłane do bazy danych Zabbix.
Pozycja może zmienić swój stan na NOT SUPPORTED, jeśli normalizacja danych zakończy się niepowodzeniem (na przykład gdy wartości tekstowej nie można przekonwertować na liczbę).
- Zebrane dane są przetwarzane — sprawdzane są wyzwalacze, konfiguracja pozycji jest aktualizowana, jeśli pozycja zmieni stan na NOT SUPPORTED itd.
- Z punktu widzenia przetwarzania wartości pozycji jest to koniec przepływu danych.
Wstępne przetwarzanie wartości pozycji
Wstępne przetwarzanie danych odbywa się w następujących krokach:
- Jeśli pozycja nie ma ani wstępnego przetwarzania, ani pozycji zależnych, jej wartość jest dodawana do pamięci podręcznej historii albo wysyłana do menedżera LLD. W przeciwnym razie wartość pozycji jest przekazywana do menedżera wstępnego przetwarzania za pomocą mechanizmu IPC opartego na gnieździe UNIX (przed Zabbix 7.4.1 wszystkie wartości są przekazywane przez menedżera wstępnego przetwarzania przed dodaniem do pamięci podręcznej historii albo wysłaniem do menedżera LLD).
- Tworzone jest zadanie wstępnego przetwarzania, które jest dodawane do kolejki, a pracownicy wstępnego przetwarzania są powiadamiani o nowym zadaniu.
- W tym momencie przepływ danych zostaje zatrzymany do czasu, aż będzie dostępny co najmniej jeden nieobciążony pracownik wstępnego przetwarzania (czyli taki, który nie wykonuje żadnych zadań).
- Gdy pracownik wstępnego przetwarzania jest dostępny, pobiera następne zadanie z kolejki.
- Po zakończeniu wstępnego przetwarzania (zarówno po nieudanym, jak i pomyślnym wykonaniu kroków wstępnego przetwarzania) wstępnie przetworzona wartość jest dodawana do kolejki ukończonych zadań, a menedżer jest powiadamiany o nowym ukończonym zadaniu.
- Menedżer wstępnego przetwarzania konwertuje wynik do żądanego formatu (zdefiniowanego przez typ wartości pozycji), a następnie dodaje go do pamięci podręcznej historii albo wysyła do menedżera LLD.
- Jeśli dla przetwarzanej pozycji istnieją pozycje zależne, są one dodawane do kolejki wstępnego przetwarzania wraz ze wstępnie przetworzoną wartością pozycji nadrzędnej. Pozycje zależne są umieszczane w kolejce z pominięciem standardowych żądań wstępnego przetwarzania wartości, ale tylko w przypadku pozycji nadrzędnych, dla których ustawiono wartość i które nie znajdują się w stanie NOT SUPPORTED.

Należy pamiętać, że na diagramie wstępne przetwarzanie pozycji nadrzędnej zostało nieco uproszczone przez pominięcie buforowania wstępnego przetwarzania.
Kolejka przetwarzania wstępnego
Kolejka przetwarzania wstępnego jest zorganizowana w następujący sposób:
- lista oczekujących zadań:
- zadania utworzone bezpośrednio na podstawie żądań przetwarzania wstępnego wartości, w kolejności ich otrzymania
- lista zadań natychmiastowych (przetwarzanych przed oczekującymi zadaniami):
- zadania testowe (utworzone w odpowiedzi na żądania frontend dotyczące testowania pozycji/przetwarzania wstępnego)
- zadania zależnych pozycji
- zadania sekwencyjne (zadania, które muszą być wykonywane w ścisłej kolejności):
- zawierające kroki przetwarzania wstępnego wykorzystujące ostatnią wartość:
- zmiana
- ograniczanie
- JavaScript (buforowanie kodu bajtowego)
- buforowanie przetwarzania wstępnego zależnych pozycji
- zawierające kroki przetwarzania wstępnego wykorzystujące ostatnią wartość:
- lista ukończonych zadań
Buforowanie wstępnego przetwarzania
Buforowanie wstępnego przetwarzania wprowadzono w celu zwiększenia wydajności wstępnego przetwarzania dla wielu zależnych pozycji mających podobne kroki wstępnego przetwarzania (co jest częstym wynikiem LLD).
Buforowanie polega na wstępnym przetworzeniu jednej zależnej pozycji i ponownym wykorzystaniu części wewnętrznych danych wstępnego przetwarzania dla pozostałych zależnych pozycji. Pamięć podręczna wstępnego przetwarzania jest obsługiwana tylko dla pierwszego kroku wstępnego przetwarzania następujących typów:
- Wzorzec Prometheus (indeksuje dane wejściowe według metryk)
- JSONPath (analizuje dane do drzewa obiektów i indeksuje pierwsze wyrażenie
[?(@.path == "value")])
Procesy robocze wstępnego przetwarzania
Plik konfiguracyjny serwera Zabbix umożliwia ustawienie liczby wątków procesów roboczych wstępnego przetwarzania. Parametr konfiguracyjny StartPreprocessors służy do ustawienia liczby wstępnie uruchomionych instancji procesów roboczych wstępnego przetwarzania, która powinna co najmniej odpowiadać liczbie dostępnych rdzeni procesora.
Jeśli zadania wstępnego przetwarzania nie są ograniczone przez procesor i obejmują częste żądania sieciowe, zaleca się skonfigurowanie dodatkowych procesów roboczych. Optymalna liczba procesów roboczych wstępnego przetwarzania zależy od wielu czynników, w tym od liczby „pozycji wymagających wstępnego przetwarzania” (pozycji, dla których należy wykonać dowolne kroki wstępnego przetwarzania), liczby procesów gromadzących dane, średniej liczby kroków wstępnego przetwarzania pozycji itd. Niewystarczająca liczba procesów roboczych może prowadzić do wysokiego użycia pamięci. Informacje dotyczące rozwiązywania problemów z nadmiernym użyciem pamięci w instalacji Zabbix można znaleźć w sekcji Profilowanie nadmiernego użycia pamięci za pomocą tcmalloc.
Zakładając jednak, że nie są wykonywane ciężkie operacje wstępnego przetwarzania, takie jak analizowanie dużych fragmentów XML/JSON, liczba procesów roboczych wstępnego przetwarzania może odpowiadać łącznej liczbie procesów gromadzących dane. W ten sposób dla zebranych danych będzie zazwyczaj (z wyjątkiem sytuacji, gdy dane z procesu gromadzącego są dostarczane zbiorczo) dostępny co najmniej jeden nieużywany proces roboczy wstępnego przetwarzania.
Zbyt duża liczba procesów gromadzących dane (pollerów, pollerów niedostępności, pollerów ODBC, pollerów HTTP, pollerów Java, pingerów, trapperów, proxypollerów), wraz z menedżerem IPMI, trapperem SNMP i procesami roboczymi wstępnego przetwarzania, może wyczerpać limit deskryptorów plików na proces dla menedżera wstępnego przetwarzania.
Wyczerpanie limitu deskryptorów plików na proces spowoduje zatrzymanie serwera Zabbix, zazwyczaj krótko po uruchomieniu, choć czasami może to potrwać dłużej.
Aby uniknąć takich problemów, przejrzyj plik konfiguracyjny serwera Zabbix, aby zoptymalizować liczbę jednoczesnych kontroli i procesów.
Ponadto, jeśli jest to konieczne, upewnij się, że limit deskryptorów plików jest wystarczająco wysoki, sprawdzając i dostosowując limity systemowe.
Potok przetwarzania wartości
Przetwarzanie wartości pozycji jest wykonywane w wielu krokach (lub fazach) przez wiele procesów. Może to powodować:
- Pozycja zależna może otrzymywać wartości, podczas gdy wartość pozycji nadrzędnej nie może zostać przyjęta.
Można to osiągnąć, korzystając z następującego przypadku użycia:
- Pozycja nadrzędna ma typ wartości
UINT(można użyć pozycji trapper), a pozycja zależna ma typ wartościTEXT. - Dla pozycji nadrzędnej ani zależnej nie są wymagane żadne kroki wstępnego przetwarzania.
- Wartość tekstowa (na przykład „abc”) powinna zostać przekazana do pozycji nadrzędnej.
- Ponieważ nie ma żadnych kroków wstępnego przetwarzania do wykonania, menedżer wstępnego przetwarzania sprawdza, czy pozycja nadrzędna nie jest w stanie NOT SUPPORTED oraz czy ustawiono wartość (oba warunki są spełnione), a następnie umieszcza pozycję zależną w kolejce z tą samą wartością co pozycja nadrzędna (ponieważ nie ma żadnych kroków wstępnego przetwarzania).
- Gdy zarówno pozycja nadrzędna, jak i zależna osiągną fazę synchronizacji historii, pozycja nadrzędna przechodzi w stan NOT SUPPORTED z powodu błędu konwersji wartości (danych tekstowych nie można przekonwertować na nieoznaczoną liczbę całkowitą).
- Pozycja nadrzędna ma typ wartości
W rezultacie pozycja zależna otrzymuje wartość, podczas gdy pozycja nadrzędna zmienia swój stan na NOT SUPPORTED.
- Pozycja zależna otrzymuje wartość, której nie ma w historii pozycji nadrzędnej.
Ten przypadek użycia jest bardzo podobny do poprzedniego, z wyjątkiem typu pozycji nadrzędnej.
Na przykład jeśli dla pozycji nadrzędnej zostanie użyty typ
CHAR, wartość pozycji nadrzędnej zostanie obcięta w fazie synchronizacji historii, podczas gdy pozycje zależne otrzymają swoje wartości z początkowej (nieobciętej) wartości pozycji nadrzędnej.