
2 Detalhes do pré-processamento
Visão geral
Esta seção fornece detalhes sobre o pré-processamento de valores de item. O pré-processamento de valores de item permite definir e executar regras de transformação para os valores de item recebidos.
O pré-processamento é gerenciado pelo processo gerenciador de pré-processamento, juntamente com os workers de pré-processamento que executam as etapas de pré-processamento. Todos os valores com pré-processamento (antes do Zabbix 7.4.1, todos os valores), recebidos de diferentes coletores de dados, passam pelo gerenciador de pré-processamento antes de serem adicionados ao cache de histórico. A comunicação IPC baseada em socket é usada entre os coletores de dados (pollers, trappers etc.) e o processo de pré-processamento. O Zabbix server ou o Zabbix proxy (para os itens monitorados pelo proxy) executa as etapas de pré-processamento.
Processamento do valor do item
Para visualizar o fluxo de dados desde a fonte de dados até o banco de dados do Zabbix, podemos usar o diagrama simplificado a seguir:
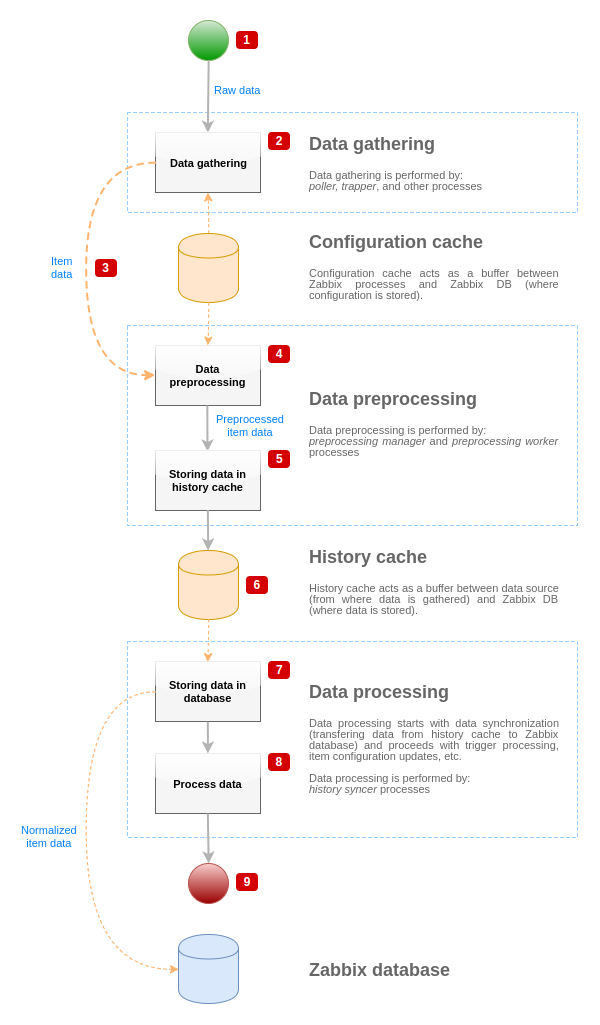
O diagrama acima mostra apenas os processos, objetos e ações relacionados ao processamento do valor do item de forma simplificada. O diagrama não mostra alterações condicionais de direção, tratamento de erros ou loops. O cache de dados local do gerenciador de pré-processamento também não é mostrado, pois não afeta diretamente o fluxo de dados. O objetivo deste diagrama é mostrar os processos envolvidos no processamento do valor do item e a forma como eles interagem.
- A coleta de dados começa com dados brutos provenientes de uma fonte de dados. Neste ponto, os dados contêm apenas o ID, o timestamp e o valor (também podem conter vários valores).
- Independentemente do tipo de coletor de dados usado, a ideia é a mesma para verificações ativas ou passivas, para itens trapper etc., pois isso altera apenas o formato dos dados e o iniciador da comunicação (o coletor de dados pode estar aguardando uma conexão e dados ou iniciar a comunicação e solicitar os dados). Os dados brutos são validados e a configuração do item é recuperada do cache de configuração (os dados são enriquecidos com os dados de configuração).
- Um mecanismo de IPC baseado em socket é usado para passar os dados dos coletores de dados para o gerenciador de pré-processamento. Neste ponto, o coletor de dados continua coletando dados sem aguardar a resposta do gerenciador de pré-processamento.
- O pré-processamento dos dados é realizado. Isso inclui a execução das etapas de pré-processamento e o processamento de itens dependentes.
Um item pode alterar seu estado para NOT SUPPORTED durante o pré-processamento se alguma das etapas de pré-processamento falhar.
- Os dados de histórico do cache de dados local do gerenciador de pré-processamento são descarregados no cache de histórico.
- Neste ponto, o fluxo de dados é interrompido até a próxima sincronização do cache de histórico (quando o processo de sincronização do histórico realiza a sincronização dos dados).
- O processo de sincronização começa com a normalização dos dados antes de armazená-los no banco de dados do Zabbix.
A normalização dos dados realiza conversões para o tipo de item desejado (tipo definido na configuração do item), incluindo o truncamento de dados textuais com base nos tamanhos predefinidos permitidos para esses tipos (
HISTORY_STR_VALUE_LENpara string,HISTORY_TEXT_VALUE_LENpara texto eHISTORY_LOG_VALUE_LENpara valores de log). Os dados são enviados ao banco de dados do Zabbix após a conclusão da normalização.
Um item pode alterar seu estado para NOT SUPPORTED se a normalização dos dados falhar (por exemplo, quando um valor textual não puder ser convertido em número).
- Os dados coletados são processados: os triggers são verificados, a configuração do item é atualizada se o item se tornar NOT SUPPORTED etc.
- Esse é considerado o fim do fluxo de dados do ponto de vista do processamento do valor do item.
Pré-processamento do valor do item
O pré-processamento dos dados é realizado nas seguintes etapas:
- Se o item não tiver nem pré-processamento nem itens dependentes, seu valor será adicionado ao cache de histórico ou enviado ao gerenciador de LLD. Caso contrário, o valor do item será passado ao gerenciador de pré-processamento usando um mecanismo de IPC baseado em socket UNIX (antes do Zabbix 7.4.1, todos os valores eram passados pelo gerenciador de pré-processamento antes de serem adicionados ao cache de histórico ou enviados ao gerenciador de LLD).
- Uma tarefa de pré-processamento é criada e adicionada à fila, e os workers de pré-processamento são notificados sobre a nova tarefa.
- Nesse ponto, o fluxo de dados é interrompido até que haja pelo menos um worker de pré-processamento desocupado (ou seja, que não esteja executando nenhuma tarefa).
- Quando um worker de pré-processamento está disponível, ele obtém a próxima tarefa da fila.
- Após a conclusão do pré-processamento (tanto em execuções bem-sucedidas quanto malsucedidas das etapas de pré-processamento), o valor pré-processado é adicionado à fila de tarefas concluídas, e o gerenciador é notificado sobre uma nova tarefa concluída.
- O gerenciador de pré-processamento converte o resultado para o formato desejado (definido pelo tipo de valor do item) e o adiciona ao cache de histórico ou o envia ao gerenciador de LLD.
- Se houver itens dependentes para o item processado, os itens dependentes serão adicionados à fila de pré-processamento com o valor pré-processado do item master. Os itens dependentes são enfileirados ignorando as solicitações normais de pré-processamento de valores, mas somente para itens master cujo valor esteja definido e que não estejam no estado NOT SUPPORTED.

Observe que, no diagrama, o pré-processamento do item master é ligeiramente simplificado, pois o cache de pré-processamento é ignorado.
Fila de pré-processamento
A fila de pré-processamento é organizada da seguinte forma:
- a lista de tarefas pendentes:
- tarefas criadas diretamente a partir de solicitações de pré-processamento de valores, na ordem em que foram recebidas
- a lista de tarefas imediatas (processadas antes das tarefas pendentes):
- tarefas de teste (criadas em resposta a solicitações de teste de item/pré-processamento pelo frontend)
- tarefas de item dependente
- tarefas sequenciais (tarefas que devem ser executadas em uma ordem estrita):
- que têm etapas de pré-processamento usando o último valor:
- alteração
- limitação
- JavaScript (cache de bytecode)
- cache de pré-processamento de item dependente
- que têm etapas de pré-processamento usando o último valor:
- a lista de tarefas concluídas
Cache de pré-processamento
O cache de pré-processamento foi introduzido para melhorar o desempenho do pré-processamento de vários itens dependentes com etapas de pré-processamento semelhantes (um resultado comum de LLD).
O cache é realizado pré-processando um item dependente e reutilizando alguns dos dados internos de pré-processamento para os demais itens dependentes. O cache de pré-processamento é compatível somente com a primeira etapa de pré-processamento dos seguintes tipos:
- Padrão do Prometheus (indexa a entrada por métricas)
- JSONPath (analisa os dados em uma árvore de objetos e indexa a primeira expressão
[?(@.path == "value")])
Workers de pré-processamento
O arquivo de configuração do Zabbix server permite definir a quantidade de threads de workers de pré-processamento. O parâmetro de configuração StartPreprocessors deve ser usado para definir o número de instâncias de workers de pré-processamento iniciadas previamente, que deve ser, no mínimo, igual ao número de núcleos de CPU disponíveis.
Se as tarefas de pré-processamento não forem limitadas pela CPU e envolverem solicitações de rede frequentes, é recomendável configurar workers adicionais. O número ideal de workers de pré-processamento pode ser determinado por vários fatores, incluindo a quantidade de itens "pré-processáveis" (itens que exigem a execução de qualquer etapa de pré-processamento), a quantidade de processos de coleta de dados, o número médio de etapas do pré-processamento dos itens, entre outros. Uma quantidade insuficiente de workers pode causar alto uso de memória. Para solucionar problemas de uso excessivo de memória na sua instalação do Zabbix, consulte Profiling excessive memory usage with tcmalloc.
No entanto, supondo que não existam operações pesadas de pré-processamento, como a análise de grandes blocos XML/JSON, o número de workers de pré-processamento pode ser igual ao número total de coletores de dados. Dessa forma, haverá, na maioria dos casos (exceto quando os dados do coletor chegarem em lote), pelo menos um worker de pré-processamento desocupado para os dados coletados.
Uma quantidade excessiva de processos de coleta de dados (pollers, pollers de itens inacessíveis, pollers ODBC, pollers HTTP, pollers Java, pingers, trappers, proxypollers), juntamente com o gerenciador IPMI, o trapper SNMP e os workers de pré-processamento, pode esgotar o limite de descritores de arquivo por processo do gerenciador de pré-processamento.
O esgotamento do limite de descritores de arquivo por processo fará com que o Zabbix server seja interrompido, normalmente pouco depois da inicialização, mas às vezes somente após um período mais longo.
Para evitar esses problemas, revise o Zabbix server configuration file para otimizar o número de verificações e processos simultâneos.
Além disso, se necessário, verifique e ajuste os limites do sistema para garantir que o limite de descritores de arquivo esteja definido com um valor suficientemente alto.
Pipeline de processamento de valores
O processamento do valor de um item é executado em várias etapas (ou fases) por vários processos. Isso pode causar:
- Um item dependente pode receber valores, enquanto o valor do item mestre não pode ser recebido.
Isso pode ser obtido usando o seguinte caso de uso:
- O item mestre tem o tipo de valor
UINT(um item trapper pode ser usado), e o item dependente tem o tipo de valorTEXT. - Nenhuma etapa de pré-processamento é necessária para os itens mestre e dependente.
- Um valor textual (por exemplo, "abc") deve ser enviado ao item mestre.
- Como não há etapas de pré-processamento a serem executadas, o gerenciador de pré-processamento verifica se o item mestre não está no estado NOT SUPPORTED e se o valor está definido (ambas as condições são verdadeiras), e enfileira o item dependente com o mesmo valor do item mestre (como não há etapas de pré-processamento).
- Quando os itens mestre e dependente chegam à fase de sincronização do histórico, o item mestre passa para o estado NOT SUPPORTED devido ao erro de conversão do valor (dados textuais não podem ser convertidos em um inteiro sem sinal).
- O item mestre tem o tipo de valor
Como resultado, o item dependente recebe um valor, enquanto o item mestre altera seu estado para NOT SUPPORTED.
- Um item dependente recebe um valor que não está presente no histórico do item mestre.
O caso de uso é muito semelhante ao anterior, exceto pelo tipo do item mestre.
Por exemplo, se o tipo
CHARfor usado para o item mestre, o valor do item mestre será truncado na fase de sincronização do histórico, enquanto os itens dependentes receberão seus valores a partir do valor inicial (não truncado) do item mestre.