
3 Low-level-Discovery
Übersicht
Low-Level-Discovery (LLD) erkennt automatisch Entitäten (z. B. Dateisysteme, Netzwerkschnittstellen) auf einem Host und erstellt die entsprechenden Datenpunkte, Auslöser und Diagramme ohne manuelle Einrichtung für jede einzelne Entität.
Um LLD zu verwenden, erstellen Sie eine Discovery-Regel, die JSON-Daten mit einer Beschreibung der Entitäten sammelt, sowie Prototypen (Datenpunkt, Auslöser und Diagramm) für jede Entität.
Das von der Regel zurückgegebene JSON muss ein Array von Objekten sein, wobei jedes Objekt eine erkannte Entität mithilfe von Schlüssel-Wert-Paaren darstellt. Eine Discovery-Regel mit net.if.discovery könnte beispielsweise Folgendes zurückgeben:
[
  {"{#IFNAME}": "lo"},
  {"{#IFNAME}": "eth0"}
]
Ein entsprechender Satz von Datenpunkten, Auslösern und Diagrammen wird dann aus den Prototypen erstellt - jeweils einer pro Schnittstelle (lo und eth0).
Wenn Objekte Schlüssel im Format {#MACRO} enthalten, werden diese Makros direkt in Prototypen verwendet. Wenn nicht oder wenn zusätzliche/benutzerdefinierte Makros erforderlich sind, können Makros manuell definiert und mithilfe von JSONPath JSON-Feldern zugeordnet werden.
LLD kann auch Hosts erstellen (z. B. für auf einem Hypervisor erkannte virtuelle Maschinen) und unterstützt verschachtelte Discovery-Regeln für mehrstufiges Discovery.
Entitäten, die nicht mehr erkannt werden, können automatisch deaktiviert oder gelöscht werden.
Konfigurieren der Low-Level-Discovery
Wir veranschaulichen die Low-Level-Discovery anhand eines Beispiels für die Erkennung von Dateisystemen.
Gehen Sie zur Konfiguration der Discovery wie folgt vor:
- Gehen Sie zu Datenerfassung > Vorlagen oder Hosts.
- Klicken Sie in der Zeile der entsprechenden Vorlage/des entsprechenden Hosts auf Discovery.
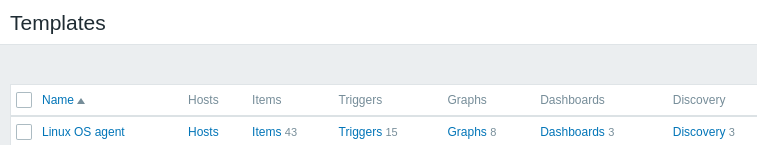
- Klicken Sie oben rechts auf dem Bildschirm auf Discovery-Regel erstellen.
- Füllen Sie das Formular für die Discovery-Regel mit den erforderlichen Details aus.
Discovery-Regel
Das Formular der Discovery-Regel enthält fünf Registerkarten, die von links nach rechts den Datenfluss während der Discovery darstellen:
- Discovery-Regel – Geben Sie an, welchen integrierten Datenpunkt oder welches benutzerdefinierte Skript Sie zum Abrufen der Discovery-Daten verwenden möchten.
- Vorverarbeitung – Wenden Sie eine Vorverarbeitung auf die ermittelten Daten an.
- LLD-Makros – Ermöglichen Sie das Extrahieren von Makrowerten zur Verwendung in ermittelten Datenpunkten, Auslösern usw.
- Filter – Ermöglichen Sie das Filtern ermittelter Werte.
- Überschreibungen – Ermöglichen Sie die Änderung von Datenpunkten, Auslösern, Diagrammen oder Host-Prototypen, wenn diese auf bestimmte ermittelte Objekte angewendet werden.
Die Registerkarte Discovery-Regel enthält den für die Discovery zu verwendenden Datenpunktschlüssel sowie einige allgemeine Attribute der Discovery-Regel:
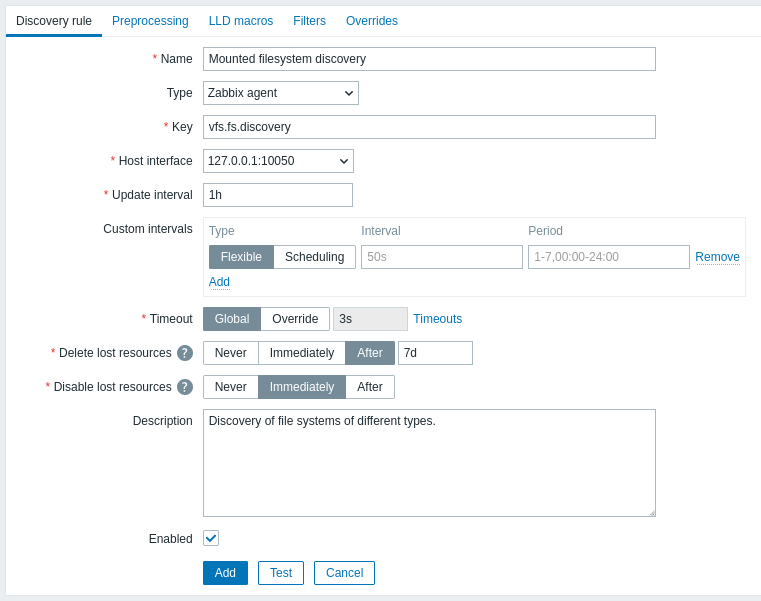
Alle Pflichtfelder sind mit einem roten Sternchen gekennzeichnet.
| Parameter | Beschreibung |
|---|---|
| Name | Name der Discovery-Regel. |
| Typ | Der Typ der Prüfung, mit der die Discovery durchgeführt wird. In diesem Beispiel verwenden wir einen Datenpunkttyp Zabbix agent. Die Discovery-Regel kann auch ein abhängiger Datenpunkt sein, der von einem regulären Datenpunkt abhängt. Sie kann nicht von einer anderen Discovery-Regel abhängen. Wählen Sie für einen abhängigen Datenpunkt den entsprechenden Typ (Abhängiger Datenpunkt) aus und geben Sie den Master-Datenpunkt im Feld „Master-Datenpunkt“ an. Der Master-Datenpunkt muss vorhanden sein. |
| Schlüssel | Geben Sie den Schlüssel des Discovery-Datenpunkts ein (bis zu 2048 Zeichen). Sie können beispielsweise den integrierten Datenpunktschlüssel „vfs.fs.discovery“ verwenden, um eine JSON-Zeichenfolge mit der Liste der auf dem Computer vorhandenen Dateisysteme, deren Typen und Einhängeoptionen zurückzugeben. Beachten Sie, dass eine weitere Möglichkeit zur Dateisystem-Discovery darin besteht, Discovery-Ergebnisse über den Agent-Schlüssel „vfs.fs.get“ zu verwenden (siehe Beispiel). |
| Aktualisierungsintervall | Dieses Feld gibt an, wie oft Zabbix die Discovery durchführt. Zu Beginn, wenn Sie die Dateisystem-Discovery gerade einrichten, möchten Sie möglicherweise ein kurzes Intervall festlegen. Sobald Sie jedoch wissen, dass sie funktioniert, können Sie 30 Minuten oder mehr einstellen, da sich Dateisysteme normalerweise nicht sehr häufig ändern. Zeit-Suffixe werden unterstützt, z. B. 30s, 1m, 2h, 1d. Benutzermakros werden unterstützt. Hinweis: Das Aktualisierungsintervall kann nur auf „0“ gesetzt werden, wenn benutzerdefinierte Intervalle mit einem Wert ungleich null vorhanden sind. Wenn es auf „0“ gesetzt ist und ein benutzerdefiniertes Intervall (flexibel oder geplant) mit einem Wert ungleich null vorhanden ist, wird der Datenpunkt während der Dauer des benutzerdefinierten Intervalls abgefragt. Neue Discovery-Regeln werden innerhalb von 60 Sekunden nach ihrer Erstellung geprüft, sofern sie nicht über ein geplantes oder flexibles Aktualisierungsintervall verfügen und das Aktualisierungsintervall auf 0 gesetzt ist. Beachten Sie, dass die Discovery für eine vorhandene Discovery-Regel sofort durchgeführt werden kann, indem Sie auf die Schaltfläche Jetzt ausführen Schaltfläche klicken. |
| Benutzerdefinierte Intervalle | Sie können benutzerdefinierte Regeln für die Prüfung des Datenpunkts erstellen: Flexibel – Erstellen Sie eine Ausnahme für das Aktualisierungsintervall (Intervall mit einer anderen Häufigkeit). Planung – Erstellen Sie einen benutzerdefinierten Abfragezeitplan. Detaillierte Informationen finden Sie unter Benutzerdefinierte Intervalle. |
| Zeitüberschreitung | Legen Sie die Zeitüberschreitung für die Discovery-Prüfung fest. Wählen Sie die Option für die Zeitüberschreitung aus: Global – Die Proxy-/globale Zeitüberschreitung wird verwendet (im ausgegrauten Feld Zeitüberschreitung angezeigt). Überschreiben – Eine benutzerdefinierte Zeitüberschreitung wird verwendet (im Feld Zeitüberschreitung festgelegt; zulässiger Bereich: 1–600 s). Zeit-Suffixe, z. B. 30s und 1m, sowie Benutzermakros werden unterstützt. Über den Link Zeitüberschreitungen können Sie Proxy-Zeitüberschreitungen oder globale Zeitüberschreitungen konfigurieren (wenn kein Proxy verwendet wird). Beachten Sie, dass der Link Zeitüberschreitungen nur Benutzern vom Typ Super-Admin angezeigt wird, die über Berechtigungen für die Frontend-Bereiche Administration > Allgemein oder Administration > Proxies verfügen. |
| Verlorene Ressourcen löschen | Geben Sie an, wie schnell die ermittelte Entität gelöscht wird, sobald ihr Discovery-Status „Nicht mehr ermittelt“ lautet: Nie – Sie wird nicht gelöscht. Sofort – Sie wird sofort gelöscht. Nach – Sie wird nach dem angegebenen Zeitraum gelöscht. Der Wert muss größer sein als der Wert für Verlorene Ressourcen deaktivieren. Zeit-Suffixe werden unterstützt, z. B. 2h und 1d. Benutzermakros werden unterstützt. Hinweis: Die Verwendung von „Sofort“ wird nicht empfohlen, da bereits eine fehlerhafte Bearbeitung des Filters dazu führen kann, dass die Entität zusammen mit allen historischen Daten gelöscht wird. Beachten Sie, dass manuell deaktivierte Ressourcen nicht durch die Low-Level-Discovery gelöscht werden. |
| Verlorene Ressourcen deaktivieren | Geben Sie an, wie schnell die ermittelte Entität deaktiviert wird, sobald ihr Discovery-Status „Nicht mehr ermittelt“ lautet: Nie – Sie wird nicht deaktiviert. Sofort – Sie wird sofort deaktiviert. Nach – Sie wird nach dem angegebenen Zeitraum deaktiviert. Der Wert sollte größer sein als das Aktualisierungsintervall der Discovery-Regel. Beachten Sie, dass automatisch deaktivierte Ressourcen wieder aktiviert werden, wenn sie durch die Low-Level-Discovery erneut ermittelt werden. Manuell deaktivierte Ressourcen werden bei einer erneuten Ermittlung nicht wieder aktiviert. Dieses Feld wird nicht angezeigt, wenn Verlorene Ressourcen löschen auf „Sofort“ gesetzt ist. Zeit-Suffixe werden unterstützt, z. B. 2h und 1d. Benutzermakros werden unterstützt. |
| Beschreibung | Geben Sie eine Beschreibung ein. |
| Aktiviert | Wenn diese Option aktiviert ist, wird die Regel verarbeitet. |
Der Verlauf der Discovery-Regel wird nicht gespeichert.
Vorverarbeitung
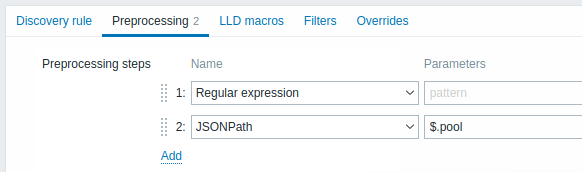
Auf der Registerkarte Vorverarbeitung können Sie Transformationsregeln definieren, die auf das Ergebnis der Erkennung angewendet werden sollen. In diesem Schritt sind eine oder mehrere Transformationen möglich. Transformationen werden in der Reihenfolge ausgeführt, in der sie definiert wurden. Die gesamte Vorverarbeitung wird vom Zabbix-Server durchgeführt.
Siehe auch:
| Typ | ||
|---|---|---|
| Transformation | Beschreibung | |
| Text | ||
| Regulärer Ausdruck | Gleicht den empfangenen Wert mit dem regulären Ausdruck <pattern> ab und ersetzt den Wert durch die extrahierte Ausgabe <output>. Der reguläre Ausdruck unterstützt die Extraktion von maximal 10 erfassten Gruppen mit der Sequenz \N. Parameter: pattern - regulärer Ausdruck output - Vorlage für die Ausgabeformatierung. Eine Escape-Sequenz \N (wobei N=1…9) wird durch die N-te übereinstimmende Gruppe ersetzt. Eine Escape-Sequenz \0 wird durch den übereinstimmenden Text ersetzt. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Ersetzen | Sucht die Suchzeichenfolge und ersetzt sie durch eine andere Zeichenfolge (oder durch nichts). Alle Vorkommen der Suchzeichenfolge werden ersetzt. Parameter: search string - die zu suchende und zu ersetzende Zeichenfolge, unter Beachtung der Groß-/Kleinschreibung (erforderlich) replacement - die Zeichenfolge, durch die die Suchzeichenfolge ersetzt wird. Die Ersetzungszeichenfolge kann auch leer sein, wodurch die Suchzeichenfolge beim Auffinden gelöscht werden kann. Es ist möglich, Escape-Sequenzen zu verwenden, um nach Zeilenumbrüchen, Wagenrückläufen, Tabulatoren und Leerzeichen zu suchen oder diese zu ersetzen: "\n \r \t \s"; der umgekehrte Schrägstrich kann als "\\" maskiert werden und Escape-Sequenzen können als "\\n" maskiert werden. Das Maskieren von Zeilenumbrüchen, Wagenrückläufen und Tabulatoren wird während der Low-Level-Erkennung automatisch durchgeführt. |
|
| Strukturierte Daten | ||
| JSONPath | Extrahiert einen Wert oder ein Fragment aus JSON-Daten mithilfe der JSONPath-Funktionalität. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| XML XPath | Extrahiert einen Wert oder ein Fragment aus XML-Daten mithilfe der XPath-Funktionalität. Damit diese Option funktioniert, muss der Zabbix-Server mit libxml-Unterstützung kompiliert worden sein. Beispiele: number(/document/item/value) extrahiert 10 aus <document><item><value>10</value></item></document>number(/document/item/@attribute) extrahiert 10 aus <document><item attribute="10"></item></document>/document/item extrahiert <item><value>10</value></item> aus <document><item><value>10</value></item></document>Beachten Sie, dass Namespaces nicht unterstützt werden. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| CSV in JSON | Konvertiert CSV-Dateidaten in das JSON-Format. Weitere Informationen finden Sie unter: CSV-zu-JSON-Vorverarbeitung. |
|
| XML in JSON | Konvertiert Daten im XML-Format in JSON. Weitere Informationen finden Sie unter: Serialisierungsregeln. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| SNMP | ||
| SNMP-Walk-Wert | Extrahiert den Wert anhand des angegebenen OID-/MIB-Namens und wendet Formatierungsoptionen an: Unverändert - gibt HEX-STRING als nicht maskierte Hexadezimalzeichenfolge zurück (Hinweis: Anzeigehinweise werden weiterhin angewendet); UTF-8 aus HEX-STRING - konvertiert HEX-STRING in eine UTF-8-Zeichenfolge; MAC aus HEX-STRING - konvertiert HEX-STRING in eine MAC-Adresszeichenfolge (wobei ' ' durch ':' ersetzt wird);Ganzzahl aus BITS - konvertiert die ersten 8 Bytes einer Bitzeichenfolge, die als Folge von Hexadezimalzeichen ausgedrückt wird (z. B. "1A 2B 3C 4D"), in eine vorzeichenlose 64-Bit-Ganzzahl. Bei Bitzeichenfolgen mit mehr als 8 Bytes werden die nachfolgenden Bytes ignoriert. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| SNMP-Walk in JSON | Konvertiert SNMP-Werte in JSON. Geben Sie einen Feldnamen im JSON und den entsprechenden SNMP-OID-Pfad an. Feldwerte werden mit den Werten aus dem angegebenen SNMP-OID-Pfad befüllt. Sie können diesen Vorverarbeitungsschritt für die SNMP-OID-Erkennung verwenden. Es stehen ähnliche Wertformatierungsoptionen wie im Schritt SNMP-Walk-Wert zur Verfügung. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| SNMP-Get-Wert | Wendet Formatierungsoptionen auf den SNMP-Get-Wert an: UTF-8 aus HEX-STRING - konvertiert HEX-STRING in eine UTF-8-Zeichenfolge; MAC aus HEX-STRING - konvertiert HEX-STRING in eine MAC-Adresszeichenfolge (wobei ' ' durch ':' ersetzt wird);Ganzzahl aus BITS - konvertiert die ersten 8 Bytes einer Bitzeichenfolge, die als Folge von Hexadezimalzeichen ausgedrückt wird (z. B. "1A 2B 3C 4D"), in eine vorzeichenlose 64-Bit-Ganzzahl. Bei Bitzeichenfolgen mit mehr als 8 Bytes werden die nachfolgenden Bytes ignoriert. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Benutzerdefinierte Skripte | ||
| JavaScript | Geben Sie JavaScript-Code im modalen Editor ein, der geöffnet wird, wenn Sie in das Parameterfeld oder auf das Stiftsymbol daneben klicken. Beachten Sie, dass die verfügbare JavaScript-Länge von der verwendeten Datenbank abhängt. Weitere Informationen finden Sie unter: JavaScript-Vorverarbeitung |
|
| Validierung | ||
| Entspricht nicht dem regulären Ausdruck | Geben Sie einen regulären Ausdruck an, mit dem ein Wert nicht übereinstimmen darf. Beispiel: Error:(.*?)\.Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Auf Fehler in JSON prüfen | Prüft auf eine Meldung auf Anwendungsebene, die sich am JSONPath befindet. Beendet die Verarbeitung, wenn die Prüfung erfolgreich ist und die Meldung nicht leer ist; andernfalls wird die Verarbeitung mit dem Wert fortgesetzt, der vor diesem Vorverarbeitungsschritt vorhanden war. Beachten Sie, dass diese Fehler externer Dienste dem Benutzer unverändert gemeldet werden, ohne Informationen zum Vorverarbeitungsschritt hinzuzufügen. Beispiel: $.errors. Wenn ein JSON wie {"errors":"e1"} empfangen wird, wird der nächste Vorverarbeitungsschritt nicht ausgeführt.Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Auf Fehler in XML prüfen | Prüft auf eine Meldung auf Anwendungsebene, die sich am XPath befindet. Beendet die Verarbeitung, wenn die Prüfung erfolgreich ist und die Meldung nicht leer ist; andernfalls wird die Verarbeitung mit dem Wert fortgesetzt, der vor diesem Vorverarbeitungsschritt vorhanden war. Beachten Sie, dass diese Fehler externer Dienste dem Benutzer unverändert gemeldet werden, ohne Informationen zum Vorverarbeitungsschritt hinzuzufügen. Bei einem Fehler beim Parsen ungültiger XML-Daten wird kein Fehler gemeldet. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Entspricht dem regulären Ausdruck | Geben Sie einen regulären Ausdruck an, mit dem ein Wert übereinstimmen muss. Wenn Sie das Kontrollkästchen Benutzerdefiniert bei Fehler aktivieren, können Sie benutzerdefinierte Optionen zur Fehlerbehandlung festlegen: den Wert verwerfen, einen bestimmten Wert festlegen oder eine bestimmte Fehlermeldung festlegen. |
|
| Drosselung | ||
| Unveränderte Werte mit Heartbeat verwerfen | Verwirft einen Wert, wenn er sich innerhalb des festgelegten Zeitraums (in Sekunden) nicht geändert hat. Zur Angabe der Sekunden werden positive Ganzzahlen unterstützt (Minimum - 1 Sekunde). In diesem Feld können Zeitsuffixe verwendet werden (z. B. 30s, 1m, 2h, 1d). Benutzer-Makros und Low-Level-Discovery-Makros können in diesem Feld verwendet werden.Für einen Discovery-Datenpunkt kann nur eine Drosselungsoption angegeben werden. Beispiel: 1m. Wenn innerhalb von 60 Sekunden zweimal identischer Text an diese Regel übergeben wird, wird er verworfen.Hinweis: Das Ändern von Datenpunkt-Prototypen setzt die Drosselung nicht zurück. Die Drosselung wird nur zurückgesetzt, wenn Vorverarbeitungsschritte geändert werden. |
|
| Prometheus | ||
| Prometheus in JSON | Konvertiert die erforderlichen Prometheus-Metriken in JSON. Weitere Informationen finden Sie unter Prometheus-Prüfungen. |
|
Beachten Sie, dass der Inhalt dieser Registerkarte schreibgeschützt ist, wenn die Discovery-Regel über eine Vorlage auf den Host angewendet wurde.
Benutzerdefinierte Makros
Auf der Registerkarte LLD-Makros können Sie benutzerdefinierte Makros für die Low-Level-Discovery angeben.
Benutzerdefinierte Makros sind nützlich, wenn das zurückgegebene JSON nicht bereits die erforderlichen Makros enthält. Zum Beispiel:
- Der native Schlüssel
vfs.fs.discoveryfür die Dateisystemerkennung gibt ein JSON mit einigen vordefinierten LLD-Makros wie {#FSNAME} und {#FSTYPE} zurück. Diese Makros können direkt in Datenpunkt- und Auslöser-Prototypen verwendet werden (siehe die folgenden Abschnitte dieser Seite); die Definition benutzerdefinierter Makros ist nicht erforderlich; - Der Agent-Datenpunkt
vfs.fs.getgibt ebenfalls ein JSON mit Dateisystemdaten zurück, jedoch ohne vordefinierte LLD-Makros. In diesem Fall können Sie die Makros selbst definieren und sie mithilfe von JSONPath den Werten im JSON zuordnen:
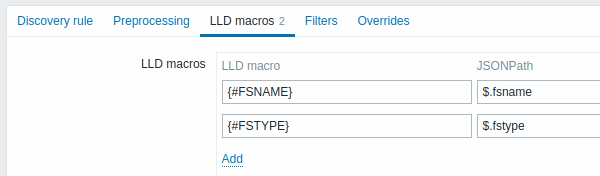
Die extrahierten Werte können in erkannten Datenpunkten, Auslösern usw. verwendet werden. Beachten Sie, dass Werte aus dem Ergebnis der Discovery und allen bisher durchgeführten Vorverarbeitungsschritten extrahiert werden.
| Parameter | Beschreibung |
|---|---|
| LLD-Makro | Name des Low-Level-Discovery-Makros in der folgenden Syntax: {#MACRO}. |
| JSONPath | Pfad, der zum Extrahieren des LLD-Makrowerts aus einer LLD-Zeile verwendet wird, unter Verwendung der JSONPath-Syntax. Die aus dem zurückgegebenen JSON extrahierten Werte werden verwendet, um die LLD-Makros in den Feldern von Datenpunkt-, Auslöser- und anderen Prototypen zu ersetzen. JSONPath kann in Punktnotation oder Klammernotation angegeben werden. Bei Sonderzeichen und Unicode sollte die Klammernotation verwendet werden, z. B. $['unicode + special chars #1']['unicode + special chars #2'].Beispielsweise extrahiert $.foo aus diesem JSON die Werte „bar“ und „baz“: [{"foo":"bar"}, {"foo":"baz"}]Beachten Sie, dass $.foo auch aus diesem JSON die Werte „bar“ und „baz“ extrahiert: {"data":[{"foo":"bar"}, {"foo":"baz"}]}, da ein einzelnes „data“-Objekt automatisch verarbeitet wird (aus Gründen der Abwärtskompatibilität mit der Low-Level-Discovery-Implementierung in Zabbix-Versionen vor 4.2). |
Filter
Ein Filter kann verwendet werden, um reale Datenpunkte, Auslöser und Graphen nur für Entitäten zu generieren, die den Kriterien entsprechen.
Die Registerkarte Filter enthält Filterdefinitionen für Erkennungsregeln, mit denen Sie Erkennungswerte filtern können:
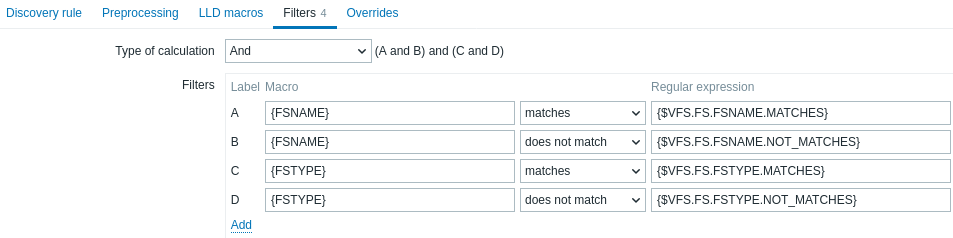
| Parameter | Beschreibung |
|---|---|
| Berechnungstyp | Für die Berechnung von Filtern stehen folgende Optionen zur Verfügung: Und – alle Filter müssen erfüllt sein; Oder – es reicht aus, wenn ein Filter erfüllt ist; Und/Oder – verwendet Und bei unterschiedlichen Makronamen und Oder beim gleichen Makronamen; Benutzerdefinierter Ausdruck – ermöglicht die Definition einer benutzerdefinierten Filterberechnung. Die Formel muss alle Filter in der Liste enthalten. Begrenzt auf 255 Zeichen. |
| Filter | Für Filterbedingungen stehen folgende Operatoren zur Verfügung: stimmt überein, stimmt nicht überein, existiert, existiert nicht. Die Operatoren stimmt überein und stimmt nicht überein erwarten einen Perl-kompatiblen regulären Ausdruck (PCRE). Sie können im Feld Regulärer Ausdruck einen regulären Ausdruck eingeben oder auf einen globalen regulären Ausdruck verweisen. Mit den Operatoren existiert und existiert nicht können Sie Entitäten anhand des Vorhandenseins oder Fehlens des angegebenen LLD-Makros in der Antwort filtern. Beachten Sie, dass eine gefundene Entität ignoriert wird, wenn ein Makro aus dem Filter in der Antwort fehlt, es sei denn, für dieses Makro ist die Bedingung „existiert nicht“ angegeben. Eine Warnung wird angezeigt, wenn das Fehlen eines Makros das Ergebnis des Ausdrucks beeinflusst. Wenn beispielsweise {#B} in folgenden Ausdrücken fehlt:{#A} stimmt mit 1 überein und {#B} stimmt mit 2 überein – es wird eine Warnung angezeigt{#A} stimmt mit 1 überein oder {#B} stimmt mit 2 überein – keine Warnung. |
Wenn Sie beispielsweise nur an den Dateisystemen C:, D: und E: interessiert sind, können Sie {#FSNAME} in das Feld Makro und ^C|^D|^E in das Feld Regulärer Ausdruck eingeben.
Eine Filterung ist auch nach Dateisystemtypen mit dem Makro {#FSTYPE} (z. B. ^ext|^reiserfs) und nach Laufwerkstypen (nur vom Windows Agent unterstützt) mit dem Makro {#FSDRIVETYPE} (z. B. fixed) möglich.
Um einen regulären Ausdruck zu testen, können Sie beispielsweise grep -E verwenden:
for f in ext2 nfs reiserfs smbfs;
do echo $f | grep -E '^ext|^reiserfs' || echo "SKIP: $f";
done
Ein Fehler oder Tippfehler im regulären Ausdruck, der in der LLD-Regel verwendet wird (beispielsweise ein falscher regulärer Ausdruck für „Dateisysteme für die Erkennung“), kann zur Löschung von Tausenden Konfigurationselementen, historischen Werten und Ereignissen für viele Hosts führen.
Die Zabbix-Datenbank in MySQL muss mit Beachtung der Groß-/Kleinschreibung erstellt werden, damit Dateisystemnamen, die sich nur durch die Groß-/Kleinschreibung unterscheiden, korrekt erkannt werden.
Überschreibungen
Auf der Registerkarte Überschreibungen können Regeln festgelegt werden, um die Liste der Datenpunkt-, Auslöser-, Graph-, Host- und Discovery-Prototypen oder deren Attribute für erkannte Objekte zu ändern, die bestimmte Kriterien erfüllen.
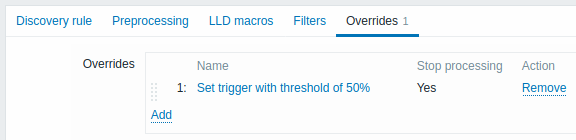
Überschreibungen (falls vorhanden) werden in einer per Drag-and-drop neu anordenbaren Liste angezeigt und in der Reihenfolge ausgeführt, in der sie definiert sind. Um die Details einer neuen Überschreibung zu konfigurieren, klicken Sie im Block Überschreibungen auf  .
Um eine vorhandene Überschreibung zu bearbeiten, klicken Sie auf den Namen der Überschreibung.
Daraufhin wird ein Popup-Fenster geöffnet, in dem Sie die Details der Überschreibungsregel bearbeiten können.
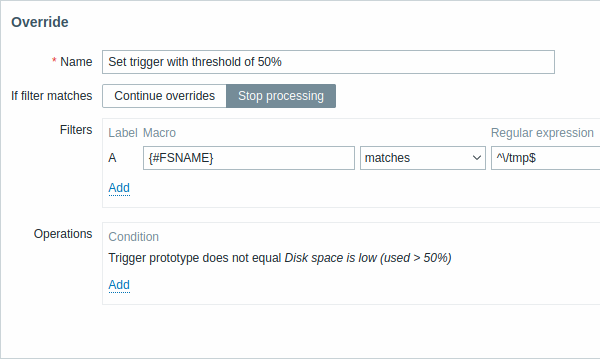
Alle Pflichtparameter sind mit roten Sternchen gekennzeichnet.
| Parameter | Beschreibung |
|---|---|
| Name | Ein eindeutiger Name der Überschreibung (pro LLD-Regel). |
| If filter matches | Legt fest, ob die nächsten Überschreibungen verarbeitet werden sollen, wenn die Filterbedingungen erfüllt sind: Continue overrides – Nachfolgende Überschreibungen werden verarbeitet. Stop processing – Die Vorgänge der vorherigen Überschreibungen (falls vorhanden) und dieser Überschreibung werden ausgeführt; nachfolgende Überschreibungen werden für übereinstimmende LLD-Zeilen ignoriert. |
| Filters | Legt fest, auf welche erkannten Entitäten die Überschreibung angewendet werden soll. Überschreibungsfilter werden nach den Filtern der Discovery-Regel verarbeitet und haben dieselbe Funktionalität. |
| Operations | Überschreibungsvorgänge werden mit folgenden Details angezeigt: Condition – ein Objekttyp und eine Bedingung, die für den Objektnamen erfüllt sein muss; zum Beispiel: Der Auslöser-Prototyp entspricht nicht Disk space is low (used > 50%). Actions – Links zum Bearbeiten und Entfernen eines Vorgangs werden angezeigt. |
Konfigurieren eines Vorgangs
Um die Details eines neuen Vorgangs zu konfigurieren, klicken Sie im Block „Vorgänge“ auf .
Um einen vorhandenen Vorgang zu bearbeiten, klicken Sie neben dem Vorgang auf  .
Daraufhin wird ein Popup-Fenster geöffnet, in dem Sie die Details des Vorgangs bearbeiten können.
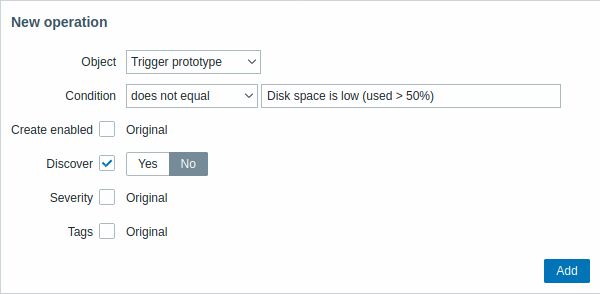
| Parameter | Beschreibung | ||
|---|---|---|---|
| Object | Es stehen fünf Objekttypen zur Verfügung: Datenpunkt-Prototyp Auslöser-Prototyp Graph-Prototyp Host-Prototyp Discovery-Prototyp |
||
| Condition | Ermöglicht das Filtern der Entitäten, auf die der Vorgang angewendet werden soll. | ||
| Operator | Unterstützte Operatoren: equals – auf diesen Prototyp anwenden does not equal – auf alle Prototypen außer diesen anwenden contains – anwenden, wenn der Prototypname diese Zeichenfolge enthält does not contain – anwenden, wenn der Prototypname diese Zeichenfolge nicht enthält matches – anwenden, wenn der Prototypname dem regulären Ausdruck entspricht does not match – anwenden, wenn der Prototypname nicht dem regulären Ausdruck entspricht |
||
| Pattern | Ein regulärer Ausdruck oder eine zu suchende Zeichenfolge. | ||
| Object: Item prototype | |||
| Create enabled | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Datenpunkt-Prototyps überschreiben können: Yes – Der Datenpunkt wird in aktiviertem Zustand hinzugefügt. No – Der Datenpunkt wird der erkannten Entität hinzugefügt, jedoch in deaktiviertem Zustand. |
||
| Discover | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Datenpunkt-Prototyps überschreiben können: Yes – Der Datenpunkt wird hinzugefügt. No – Der Datenpunkt wird nicht hinzugefügt. |
||
| Update interval | Wenn das Kontrollkästchen aktiviert ist, werden zwei Optionen angezeigt, mit denen Sie ein anderes Intervall für den Datenpunkt festlegen können: Delay – Aktualisierungsintervall des Datenpunkts. Benutzermakros, LLD-Makros und Zeitsuffixe (z. B. 30s, 1m, 2h, 1d) werden unterstützt (Unterstützung für LLD-Makros in Zabbix 7.4.11 wiederhergestellt). Muss auf 0 gesetzt werden, wenn Custom interval verwendet wird. Custom interval – Klicken Sie auf , um flexible/geplante Intervalle festzulegen. Weitere Informationen finden Sie unter Benutzerdefinierte Intervalle. |
||
| History | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie eine andere Aufbewahrungsdauer für den Datenpunkt festlegen können: Do not store – Wenn ausgewählt, wird der Verlauf nicht gespeichert. Store up to – Wenn ausgewählt, wird rechts ein Eingabefeld zur Angabe der Aufbewahrungsdauer angezeigt. Benutzermakros und LLD-Makros werden unterstützt (Unterstützung für LLD-Makros in Zabbix 7.4.11 wiederhergestellt). |
||
| Trends | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie eine andere Aufbewahrungsdauer für Trends festlegen können: Do not store – Wenn ausgewählt, werden Trends nicht gespeichert. Store up to – Wenn ausgewählt, wird rechts ein Eingabefeld zur Angabe der Aufbewahrungsdauer angezeigt. Benutzermakros und LLD-Makros werden unterstützt (Unterstützung für LLD-Makros in Zabbix 7.4.11 wiederhergestellt). |
||
| Tags | Wenn das Kontrollkästchen aktiviert ist, wird ein neuer Block angezeigt, in dem Sie Tag-Wert-Paare angeben können. Benutzermakros und LLD-Makros werden unterstützt. Diese Tags werden an die im Datenpunkt-Prototyp angegebenen Tags angehängt, auch wenn die Tagnamen übereinstimmen. |
||
| Object: Trigger prototype | |||
| Create enabled | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Auslöser-Prototyps überschreiben können: Yes – Der Auslöser wird in aktiviertem Zustand hinzugefügt. No – Der Auslöser wird der erkannten Entität hinzugefügt, jedoch in deaktiviertem Zustand. |
||
| Discover | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Auslöser-Prototyps überschreiben können: Yes – Der Auslöser wird hinzugefügt. No – Der Auslöser wird nicht hinzugefügt. |
||
| Severity | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen für den Schweregrad des Auslösers angezeigt, mit denen Sie den Schweregrad ändern können. | ||
| Tags | Wenn das Kontrollkästchen aktiviert ist, wird ein neuer Block angezeigt, in dem Sie Tag-Wert-Paare angeben können. Benutzermakros und LLD-Makros werden unterstützt. Diese Tags werden an die im Auslöser-Prototyp angegebenen Tags angehängt, auch wenn die Tagnamen übereinstimmen. |
||
| Object: Graph prototype | |||
| Discover | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Graph-Prototyps überschreiben können: Yes – Der Graph wird hinzugefügt. No – Der Graph wird nicht hinzugefügt. |
||
| Object: Host prototype | |||
| Create enabled | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Host-Prototyps überschreiben können: Yes – Der Host wird in aktiviertem Zustand erstellt. No – Der Host wird in deaktiviertem Zustand erstellt. |
||
| Discover | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Host-Prototyps überschreiben können: Yes – Der Host wird erkannt. No – Der Host wird nicht erkannt. |
||
| Link templates | Wenn das Kontrollkästchen aktiviert ist, wird ein Eingabefeld zur Angabe von Vorlagen angezeigt. Beginnen Sie mit der Eingabe des Vorlagennamens oder klicken Sie neben dem Feld auf Select und wählen Sie Vorlagen aus der Liste im Popup-Fenster aus. Vorlagen aus dieser Überschreibung werden zu allen Vorlagen hinzugefügt, die bereits mit dem Host-Prototyp verknüpft sind. |
||
| Tags | Wenn das Kontrollkästchen aktiviert ist, wird ein neuer Block angezeigt, in dem Sie Tag-Wert-Paare angeben können. Benutzermakros und LLD-Makros werden unterstützt. Diese Tags werden an die im Host-Prototyp angegebenen Tags angehängt, auch wenn die Tagnamen übereinstimmen. |
||
| Host inventory | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie einen anderen Inventar-Modus für den Host-Prototyp auswählen können: Disabled – Hostinventar nicht ausfüllen Manual – Details manuell angeben Automated – Hostinventardaten automatisch anhand der erfassten Metriken ausfüllen. |
||
| Object: Discovery prototype | |||
| Create enabled | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Discovery-Prototyps überschreiben können: Yes – Die Discovery-Regel wird in aktiviertem Zustand hinzugefügt. No – Die Discovery-Regel wird in deaktiviertem Zustand hinzugefügt. |
||
| Discover | Wenn das Kontrollkästchen aktiviert ist, werden Schaltflächen angezeigt, mit denen Sie die ursprünglichen Einstellungen des Discovery-Prototyps überschreiben können: Yes – Die Discovery-Regel wird hinzugefügt. No – Die Discovery-Regel wird nicht hinzugefügt. |
||
| Update interval | Wenn das Kontrollkästchen aktiviert ist, werden zwei Optionen angezeigt, mit denen Sie ein anderes Intervall für die Discovery-Regel festlegen können: Delay – Aktualisierungsintervall der Regel. Benutzermakros, LLD-Makros und Zeitsuffixe (z. B. 30s, 1m, 2h, 1d) werden unterstützt. Muss auf 0 gesetzt werden, wenn Custom interval verwendet wird. Custom interval – Klicken Sie auf , um flexible/geplante Intervalle festzulegen. Weitere Informationen finden Sie unter Benutzerdefinierte Intervalle. |
||
Schaltflächen des Formulars
Mit den Schaltflächen am unteren Rand des Formulars können Sie mehrere Vorgänge ausführen.
 |
Eine Erkennungsregel hinzufügen. Diese Schaltfläche ist nur für neue Erkennungsregeln verfügbar. |
 |
Die Eigenschaften einer Erkennungsregel aktualisieren. Diese Schaltfläche ist nur für vorhandene Erkennungsregeln verfügbar. |
 |
Eine weitere Erkennungsregel auf Grundlage der Eigenschaften der aktuellen Erkennungsregel erstellen. |
 |
Die Erkennung sofort auf Grundlage der Erkennungsregel durchführen. Die Erkennungsregel muss bereits vorhanden sein. Weitere Informationen finden Sie hier. Hinweis: Bei einer sofortigen Erkennung wird der Konfigurations-Cache nicht aktualisiert. Daher berücksichtigt das Ergebnis möglicherweise sehr aktuelle Änderungen an der Konfiguration der Erkennungsregel nicht. |
 |
Die Konfiguration der Erkennungsregel testen. Verwenden Sie diese Schaltfläche, um die Konfigurationseinstellungen (z. B. Konnektivität und die Korrektheit der Parameter) zu überprüfen, ohne Änderungen dauerhaft anzuwenden. |
 |
Die Erkennungsregel löschen. |
 |
Die Bearbeitung der Eigenschaften der Erkennungsregel abbrechen. |
Erkannte Entitäten
Die folgenden Screenshots veranschaulichen, wie erkannte Datenpunkte, Auslöser und Diagramme in der Konfiguration des Hosts aussehen. Erkannte Entitäten sind mit einem orangefarbenen Link zu der Discovery-Regel versehen, aus der sie stammen.
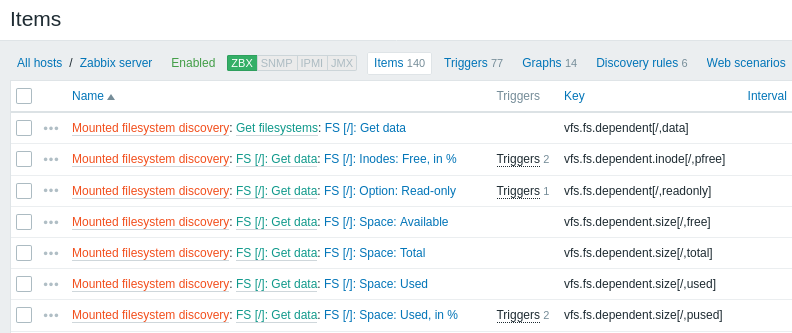
Beachten Sie, dass erkannte Entitäten nicht erstellt werden, wenn bereits vorhandene Entitäten mit denselben Eindeutigkeitskriterien existieren, zum Beispiel ein Datenpunkt mit demselben Schlüssel oder ein Diagramm mit demselben Namen. In diesem Fall wird im Frontend eine Fehlermeldung angezeigt, dass die Low-Level-Discovery-Regel bestimmte Entitäten nicht erstellen konnte. Die Discovery-Regel selbst wird jedoch nicht auf „nicht unterstützt“ gesetzt, nur weil eine Entität nicht erstellt werden konnte und übersprungen werden musste. Die Discovery-Regel fährt mit dem Erstellen/Aktualisieren anderer Entitäten fort.
Wenn eine erkannte Entität (Host, Dateisystem, Schnittstelle usw.) nicht mehr erkannt wird (oder den Filter nicht mehr erfüllt), können die auf ihrer Grundlage erstellten Entitäten automatisch deaktiviert und schließlich gelöscht werden.
Verlorene Ressourcen können basierend auf dem Wert des Parameters Disable lost resources automatisch deaktiviert werden. Dies betrifft verlorene Hosts, Datenpunkte und Auslöser.
Verlorene Ressourcen können basierend auf dem Wert des Parameters Delete lost resources automatisch gelöscht werden. Dies betrifft verlorene Hosts, Hostgruppen, Datenpunkte, Auslöser und Diagramme.
Wenn erkannte Entitäten den Status „Nicht mehr erkannt“ erhalten, wird in der Entitätenliste ein Lebensdauerindikator angezeigt. Bewegen Sie den Mauszeiger darüber, und es wird eine Meldung mit Details zu ihrem Status angezeigt.
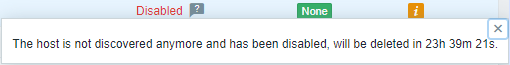
Wenn Entitäten zum Löschen markiert wurden, aber nicht zum erwarteten Zeitpunkt gelöscht wurden (deaktivierte Discovery-Regel oder Datenpunkt-Host), werden sie beim nächsten Verarbeiten der Discovery-Regel gelöscht.
Entitäten, die andere Entitäten enthalten und zum Löschen markiert sind, werden nicht aktualisiert, wenn sie auf Ebene der Discovery-Regel geändert werden. Zum Beispiel werden LLD-basierte Auslöser nicht aktualisiert, wenn sie Datenpunkte enthalten, die zum Löschen markiert sind.
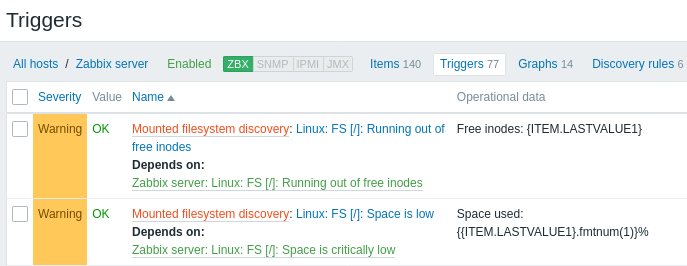
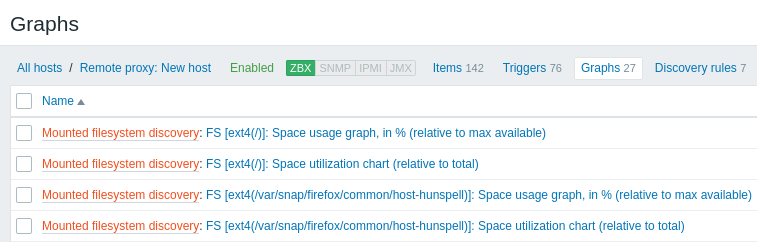
Andere Arten der Discovery
Weitere Details und Anleitungen zu anderen Arten der sofort einsatzbereiten Discovery finden Sie in den folgenden Abschnitten:
- Discovery von Netzwerkschnittstellen
- Discovery von CPUs und CPU-Kernen
- Discovery von SNMP-OIDs
- Discovery von JMX-Objekten;
- Discovery mit ODBC-SQL-Abfragen
- Discovery von Windows-Diensten
- Discovery von Host-Schnittstellen in Zabbix
Weitere Details zum JSON-Format für Discovery-Datenpunkte sowie ein Beispiel dafür, wie Sie Ihren eigenen Dateisystem-Discoverer als Perl-Skript implementieren, finden Sie unter Erstellen benutzerdefinierter LLD-Regeln.