

正規表現
概要
Perl Compatible Regular Expressions (PCRE, PCRE2) は Zabbix でサポートされています。
Zabbix で正規表現を使用する方法は 2 つあります。
- 正規表現を手動で入力する
- Zabbix で作成したグローバル正規表現を使用する
正規表現
supported places では、正規表現を手動で入力できます。
式は @ で始めてはいけません。この記号は Zabbix でグローバル正規表現を参照するために使用されるためです。
正規表現を使用すると、スタックメモリが不足する可能性があります。 詳細については、PCRE PERFORMANCE を参照してください。
複数行マッチングでは、^ と $ のアンカーは、それぞれ文字列全体の先頭と末尾ではなく、各行の先頭と末尾に一致することに注意してください。
さまざまなコンテキストでの正しいエスケープの例も参照してください。
グローバル正規表現
Zabbixでは、複雑な正規表現を作成およびテストするための高度なエディターがWebインターフェースに用意されています。
アクセスするには、Administration > General > Regular expressions に移動します。
Zabbixには、デフォルトデータセットとして多数の事前定義されたグローバル正規表現が含まれています。
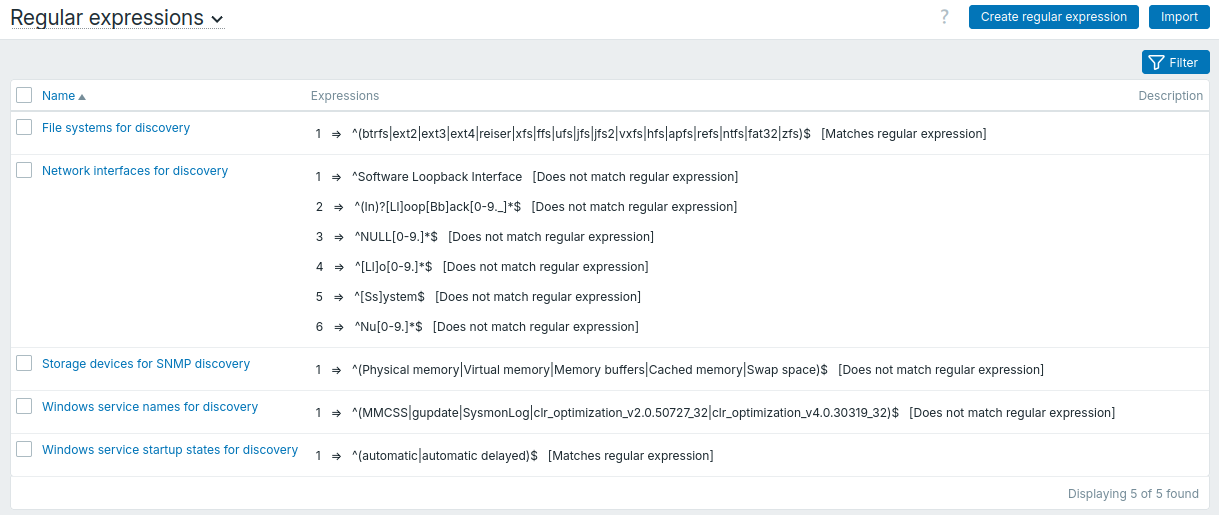
正規表現の一覧は、名前と説明でフィルタリングして、必要な式を見つけることができます。
設定
グローバル正規表現を作成するには、次の手順に従います。
- 正規表現を作成をクリックします。
- フォームに正規表現のパラメータを入力します。
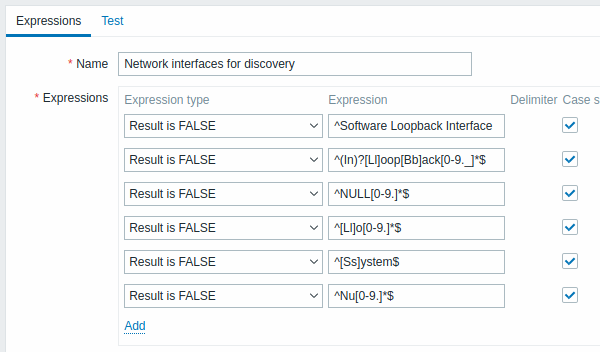
すべての必須入力フィールドには、赤いアスタリスクが付いています。
| パラメータ | 説明 | |
|---|---|---|
| 名前 | 正規表現の名前を設定します。Unicode文字を使用できます。 | |
| 式 | 式セクションの追加をクリックして、新しいサブ式を追加します。 | |
| 式のタイプ | 式のタイプを選択します。 文字列を含む - 部分文字列に一致します。 リスト内のいずれかの部分文字列を含む - 区切り文字で区切られたリスト内のいずれかの部分文字列に一致します。区切り文字には、コンマ ,、ドット .、スラッシュ / を使用できます。文字列を含まない - 部分文字列以外のすべての文字列に一致します。 正規表現に一致する - 正規表現に一致します。 正規表現に一致しない - 正規表現に一致しません。 |
|
| 式 | 部分文字列または正規表現を入力します。 最大長: 2048文字。 |
|
| 区切り文字 | 正規表現内のテキスト文字列を区切るためのコンマ ,、ドット .、またはスラッシュ /。このパラメータは、リスト内のいずれかの部分文字列を含む式のタイプが選択されている場合にのみ有効です。 |
|
| 大文字と小文字を区別 | 正規表現で英字の大文字と小文字を区別するかどうかを指定するチェックボックスです。 | |
| 説明 | 正規表現の説明を入力します。 | |
| 式のテスト | 正規表現のテストに使用する値です。 | |
式内のスラッシュ / は、区切り文字ではなく文字どおりに扱われます。
これにより、スラッシュを含む式をエラーなしで保存できます。
Zabbixのカスタム正規表現名には、コンマ、スペースなどを含めることができます。
参照時に誤って解釈される可能性がある場合(たとえば、アイテムキーのパラメータにコンマが含まれる場合)は、次のように参照全体を引用符で囲むことができます: "\@My custom regexp for purpose1, purpose2"。
その他の場所(たとえば、LLDルールのプロパティ)では、正規表現名を引用符で囲まないでください。
正規表現を作成すると、名前の前に @ を付けて参照することで、Webインターフェースの複数の場所で使用できます。たとえば、@mycustomregexp のように指定します。
フォームのボタン
フォーム下部のボタンを使用して、さまざまな操作を実行できます。
| ボタン | 説明 |
|---|---|
 |
正規表現を追加します。このボタンは、新しい正規表現に対してのみ使用できます。 |
 |
正規表現のプロパティを更新します。 |
 |
現在の正規表現のプロパティを基に、別の正規表現を作成します。 |
 |
指定した値に対して、正規表現とそのサブ表現をテストします。 |
 |
正規表現を削除します。 |
 |
正規表現のプロパティの編集をキャンセルします。 |
正規表現のテスト
Test expression フィールドに値を入力し、Test ボタンをクリックすると、正規表現とその部分式をテストできます。
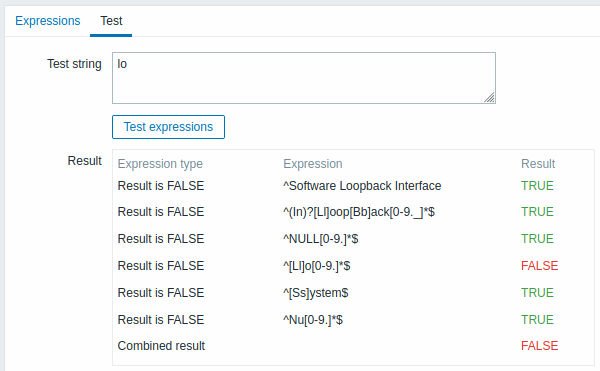
Test result 列には、各部分式のステータスが表示されます。
Combined result フィールドには、正規表現全体のステータスが表示されます。
複数の部分式が定義されている場合、Zabbix は論理 AND 演算子を使用して Combined result を計算します。つまり、少なくとも 1 つの結果が False の場合、Combined result も False になります。
デフォルトのグローバル正規表現
デフォルトのデータセットには、次の事前定義されたグローバル正規表現が含まれます。
| Name | Expression | Matches |
|---|---|---|
| File systems for discovery | ^(btrfs|ext2|ext3|ext4|reiser|xfs|ffs|ufs|jfs|jfs2|vxfs|hfs|apfs|refs|ntfs|fat32|zfs)$ |
"btrfs" または "ext2" または "ext3" または "ext4" または "reiser" または "xfs" または "ffs" または "ufs" または "jfs" または "jfs2" または "vxfs" または "hfs" または "apfs" または "refs" または "ntfs" または "fat32" または "zfs"。 |
| Network interfaces for discovery | ^Software Loopback Interface |
"Software Loopback Interface" で始まる文字列。 |
^lo$ |
"lo"。 | |
^(In)?[Ll]oop[Bb]ack[0-9._]*$ |
"In" で始まる場合があり、その後に "L" または "l"、続いて "oop"、続いて "B" または "b"、続いて "ack"、さらに任意個の数字、ドット、またはアンダースコアが続く文字列。 | |
^NULL[0-9.]*$ |
"NULL" で始まり、その後に任意個の数字またはドットが続く文字列。 | |
^[Ll]o[0-9.]*$ |
"Lo" または "lo" で始まり、その後に任意個の数字またはドットが続く文字列。 | |
^[Ss]ystem$ |
"System" または "system"。 | |
^Nu[0-9.]*$ |
"Nu" で始まり、その後に任意個の数字またはドットが続く文字列。 | |
| Storage devices for SNMP discovery | ^(Physical memory|Virtual memory|Memory buffers|Cached memory|Swap space)$ |
"Physical memory" または "Virtual memory" または "Memory buffers" または "Cached memory" または "Swap space"。 |
| Windows service names for discovery | ^(MMCSS|gupdate|SysmonLog|clr_optimization_v2.0.50727_32|clr_optimization_v4.0.30319_32)$ |
"MMCSS" または "gupdate" または "SysmonLog" または "clr_optimization_v2.0.50727_32" または "clr_optimization_v4.0.30319_32" に一致する文字列。各ドットは改行以外の任意の文字に置き換えることができます。 |
| Windows service startup states for discovery | ^(automatic|automatic delayed)$ |
"automatic" または "automatic delayed"。 |
正規表現のインポート/エクスポート
正規表現 のエクスポート/インポート設定ページで説明されているように、グローバル正規表現をインポートまたはエクスポートできます。
例
完全一致する文字列を除外する例
特定の名前を持つデータベースを除き、低レベルディスカバリでデータベースを検出するには、次の式を使用します。
^TESTDATABASE$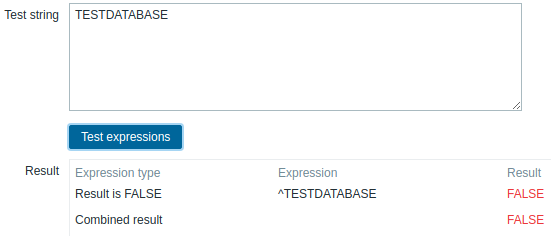
Test result と Combined result の両方に FALSE が表示されます。名前が "TESTDATABASE" に一致するため、Does not match regular expression 条件は満たされません。
インライン正規表現修飾子を使用した大文字小文字を区別しない一致の例
次の正規表現を使用します。これは、文字列 "error" に対して大文字小文字を区別しない一致を行うためのインライン修飾子 (?i) を含んでいます。
(?i)error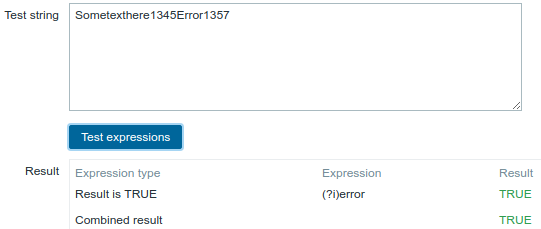
Test result と Combined result の両方に TRUE が表示されます。これは、Case sensitive が選択されていても、インライン修飾子 (?i) により一致が大文字小文字を区別しなくなるため、文字列 "error" が一致するからです。
複数のインライン正規表現修飾子を使用する例
複数のインライン修飾子を含む次の正規表現を使用して、特定の行の後ろにある文字を一致させます。
(?<=match (?i)eveRything(?-i) after this line\r\n)(?sx).*# commentここで、各修飾子は次の意味を持ちます。
(?i)- 大文字小文字を区別しない一致を有効にする;(?-i)- 大文字小文字を区別しない一致を無効にする;(?s)- dotall モードを有効にし、.が改行文字にも一致するようにする;(?x)- 拡張モードを有効にし、正規表現内の空白とコメントを無視できるようにする。
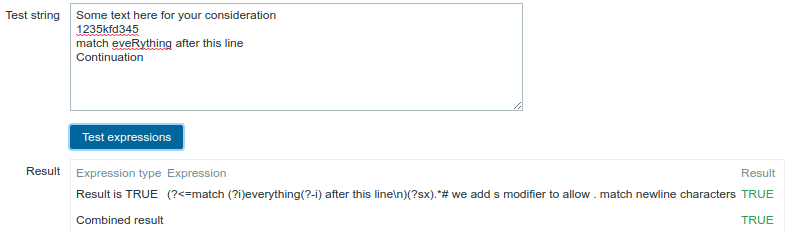
Test result と Combined result の両方で TRUE が表示されます。つまり、特定の行の後ろにある文字が一致しています。
g 修飾子はインラインで指定できません。
使用可能な修飾子の一覧は pcresyntax man page で確認できます。
PCRE 構文の詳細については、PCRE HTML documentation を参照してください。
場所別の正規表現サポート
| Location | Regular expression | Global regular expression | Multiline matching | Comments | |
|---|---|---|---|---|---|
| エージェントアイテム | |||||
| eventlog[] | Yes | Yes | Yes | regexp, severity, source, eventid parameters |
|
| eventlog.count[] | regexp, severity, source, eventid parameters |
||||
| log[] | regexp parameter |
||||
| log.count[] | |||||
| logrt[] | Yes/No | regexp parameter supports both, file_regexp parameter supports non-global expressions only |
|||
| logrt.count[] | |||||
| proc.cpu.util[] | No | No | cmdline parameter |
||
| proc.get[] | |||||
| proc.mem[] | |||||
| proc.num[] | |||||
| sensor[] | Linux 2.4 の device および sensor パラメータ |
||||
| system.hw.macaddr[] | interface parameter |
||||
| system.sw.packages[] | regexp parameter |
||||
| system.sw.packages.get[] | regexp parameter |
||||
| vfs.dir.count[] | regex_incl, regex_excl, regex_excl_dir parameters |
||||
| vfs.dir.get[] | regex_incl, regex_excl, regex_excl_dir parameters |
||||
| vfs.dir.size[] | regex_incl, regex_excl, regex_excl_dir parameters |
||||
| vfs.file.regexp[] | Yes | regexp parameter |
|||
| vfs.file.regmatch[] | |||||
| web.page.regexp[] | |||||
| SNMPトラップ | |||||
| snmptrap[] | Yes | Yes | No | regexp parameter |
|
| アイテム値の前処理 | Yes | No | No | pattern parameter |
|
| トリガー/計算アイテム用関数 | |||||
| count() | Yes | Yes | Yes | operator パラメータが regexp または iregexp の場合は pattern パラメータ |
|
| countunique() | Yes | Yes | |||
| find() | Yes | Yes | |||
| logeventid() | Yes | Yes | No | pattern parameter |
|
| logsource() | |||||
| 低レベルディスカバリ | |||||
| Filters | Yes | Yes | No | Regular expression field | |
| Overrides | Yes | No | In matches, does not match options for Operation conditions | ||
| アクション条件 | Yes | No | No | In matches, does not match options for Host name and Host metadata autoregistration conditions | |
| スクリプト | Yes | Yes | No | Input validation rule field | |
| Web監視 | Yes | No | Yes | regex: プレフィックス付きの Variables Required string field |
|
| ユーザーマクロのコンテキスト | Yes | No | No | regex: プレフィックス付きのマクロコンテキスト | |
| マクロ関数 | |||||
| regsub() | Yes | No | No | pattern parameter |
|
| iregsub() | |||||
| マップ内のリンクインジケーター | Yes | No | No | Pattern field (for text items) | |
| アイコンマッピング | Yes | Yes | No | Expression field | |
| 値のマッピング | Yes | No | No | マッピングタイプが regexp の場合の Value field |
|
| エージェント設定パラメータ | |||||
| AllowKeyRegexp | Yes | No | No | Pattern | |
| DenyKeyRegexp | |||||