

5 エスカレーション
概要
エスカレーションを使用すると、通知の送信やリモートコマンドの実行のための カスタムシナリオを作成できます。
実際には、これは次のことを意味します。
- ユーザーは新しい障害について即座に通知を受けることができます。
- 障害が解決されるまで通知を繰り返すことができます。
- 通知の送信を遅らせることができます。
- 通知を別の「より上位の」ユーザーグループにエスカレーションできます。
- リモートコマンドは、即座に実行することも、障害が長時間解決されない場合に実行することもできます。
アクションは、エスカレーションステップ に基づいてエスカレーションされます。各ステップには 継続時間があります。
デフォルトの継続時間と、個々のステップのカスタム継続時間の両方を 定義できます。1つのエスカレーションステップの最小継続時間は60秒です。
通知の送信やコマンドの実行などのアクションは、任意のステップから開始できます。 ステップ1は即時アクション用です。アクションを遅らせたい場合は、 後のステップに割り当てることができます。各ステップに対して、 複数のアクションを定義できます。
エスカレーションステップの数に制限はありません。
エスカレーションは、実行内容の設定時に定義します。エスカレーションは 障害時の実行内容でのみサポートされ、復旧時にはサポートされません。
エスカレーション動作に関するその他の事項
アクションに複数のエスカレーションステップが含まれている場合、さまざまな状況で何が起こるかを見てみましょう。
| 状況 | 動作 |
|---|---|
| 初回の障害通知が送信された後、対象のホストがメンテナンスに入った | アクションの設定にある 抑制された障害の操作を一時停止 設定に応じて、残りのエスカレーションステップは、メンテナンス期間による遅延後、または遅延なしで実行されます。メンテナンス期間によって操作がキャンセルされることはありません。 |
| 初回通知の送信後、期間アクション条件で定義された時間帯が終了した | 残りのエスカレーションステップはすべて実行されます。期間 条件で操作を停止することはできません。この条件は、アクションを開始するかどうかに影響しますが、操作には影響しません。 |
| メンテナンス中に障害が開始し、メンテナンス終了後も継続している(解決していない) | アクションの設定にある 抑制された障害の操作を一時停止 設定に応じて、すべてのエスカレーションステップはメンテナンス終了時点から、または直ちに実行されます。 |
| データなしメンテナンス中に障害が開始し、メンテナンス終了後も継続している(解決していない) | すべてのエスカレーションステップが実行される前に、トリガーが発火するまで待機する必要があります。 |
| 異なるエスカレーションが短い間隔で続けて発生し、重複した | 新しいエスカレーションが実行されると、以前のエスカレーションは置き換えられます。ただし、以前のエスカレーションでは、少なくとも1つのエスカレーションステップが常に実行されます。この動作は、トリガーのすべての障害評価で作成されるイベントに対するアクションに関係します。 |
| エスカレーションの実行中(メッセージの送信中など)に、イベントの種類に応じて: - アクションが無効になった トリガーイベントの場合: - トリガーが無効になった - ホストまたはアイテムが無効になった トリガーに関する内部イベントの場合: - トリガーが無効になった アイテム/ローレベルディスカバリルールに関する内部イベントの場合: - アイテムが無効になった - ホストが無効になった |
実行中のメッセージが送信され、その後、エスカレーションに関するメッセージがもう1通送信されます。後続のメッセージ本文の先頭には、キャンセルの理由を示すキャンセルテキスト(注: エスカレーションがキャンセルされました)が含まれます(例: 注: エスカレーションがキャンセルされました: アクション「<アクション名>」が無効になりました)。これにより、受信者はエスカレーションがキャンセルされ、これ以上ステップが実行されないことを把握できます。このメッセージは、それまでに通知を受信したすべての受信者に送信されます。キャンセルの理由はサーバーのログファイルにも記録されます(デバッグレベル 3=Warning以上)。 操作が完了していても、リカバリ操作が設定されており、まだ実行されていない場合は、エスカレーションがキャンセルされました メッセージが送信されることに注意してください。 |
| エスカレーションの実行中(メッセージの送信中など)にアクションが削除された | これ以上メッセージは送信されません。この情報はサーバーのログファイルに記録されます(デバッグレベル 3=Warning以上)。例: escalation canceled: action id:334 deleted |
エスカレーション例
例1
30分ごとに繰り返し通知を送信する(合計5回)"MySQL Administrators"グループに送信します。設定方法は以下の通りです。
- オペレーションタブで、デフォルトのオペレーションステップの期間を"30m"(30分)に設定します。
- エスカレーションのステップを"1"から"5"までに設定します。
- メッセージの受信者として"MySQL Administrators"グループを選択します。
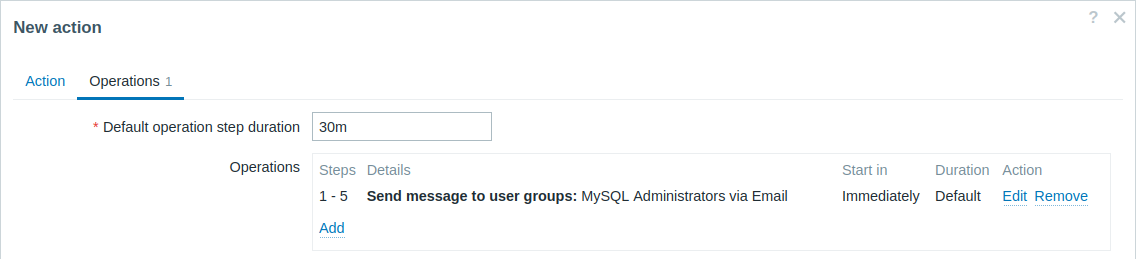
問題が発生してから0:00、0:30、1:00、1:30、2:00の時点で通知が送信されます(もちろん、問題がそれより早く解決された場合は除きます)。
問題が解決され、リカバリーメッセージが設定されている場合、このエスカレーションシナリオで少なくとも1つの問題メッセージを受信した人に送信されます。
アクティブなエスカレーションを生成したトリガーが 無効化された場合、Zabbixはすでに通知を受信したすべてのユーザーにその旨の情報メッセージを送信します。
例2
長時間継続している問題について遅延通知を送信します。設定方法:
- オペレーションタブで、デフォルトのオペレーションステップの期間を「10h」(10時間)に設定します。
- エスカレーションのステップを「2」から「2」に設定します。
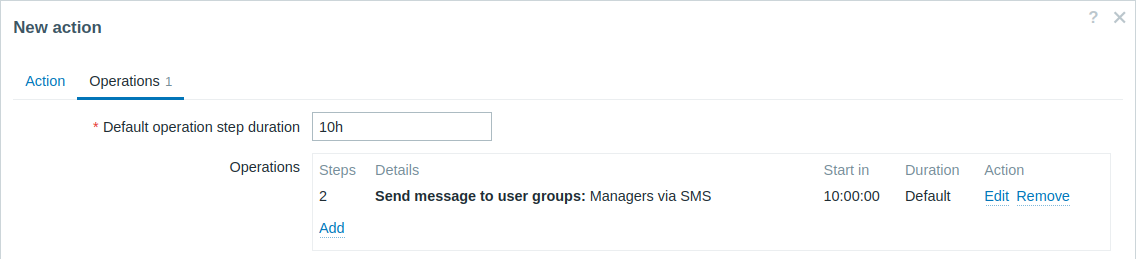
通知は、エスカレーションシナリオのステップ2、つまり問題発生から10時間後にのみ送信されます。
メッセージテキストを「問題が10時間以上継続しています」などにカスタマイズすることもできます。
例3
問題を上司にエスカレーションする。
上記の最初の例では、MySQL管理者への定期的なメッセージ送信を設定しました。この場合、管理者は問題がデータベースマネージャーにエスカレーションされる前に4回メッセージを受け取ります。マネージャーは、問題がまだ確認されていない場合、つまり誰も対応していない場合にのみメッセージを受け取ることに注意してください。
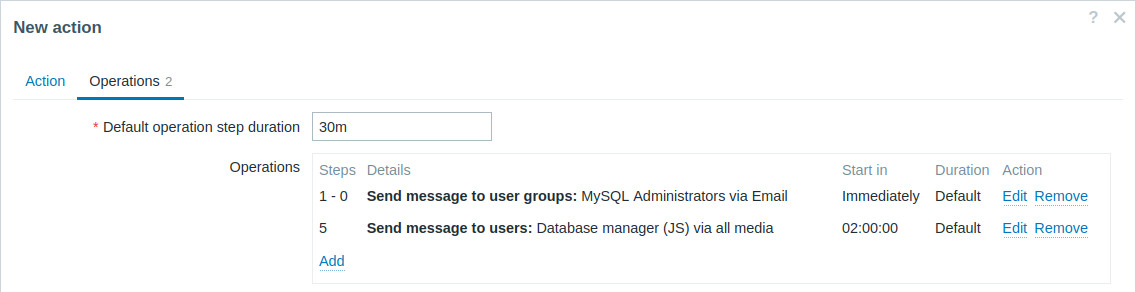
操作2の詳細:
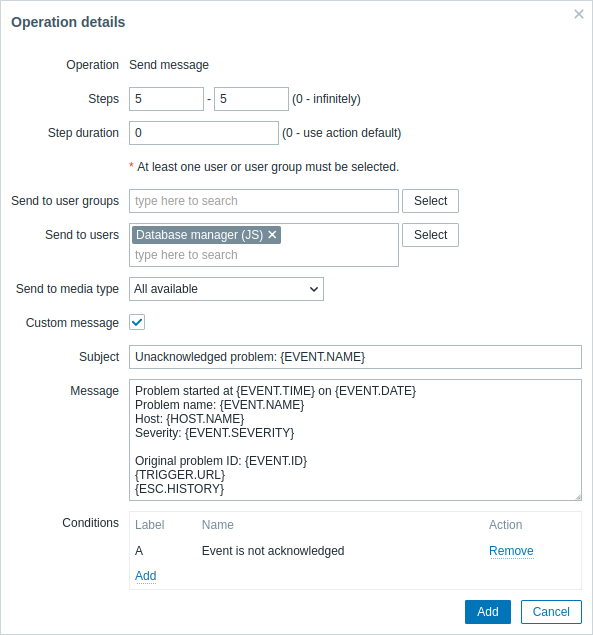
カスタマイズされたメッセージで{ESC.HISTORY}マクロを使用していることに注意してください。このマクロには、このエスカレーションで以前に実行されたすべてのステップ(送信された通知や実行されたコマンドなど)に関する情報が含まれます。
例 4
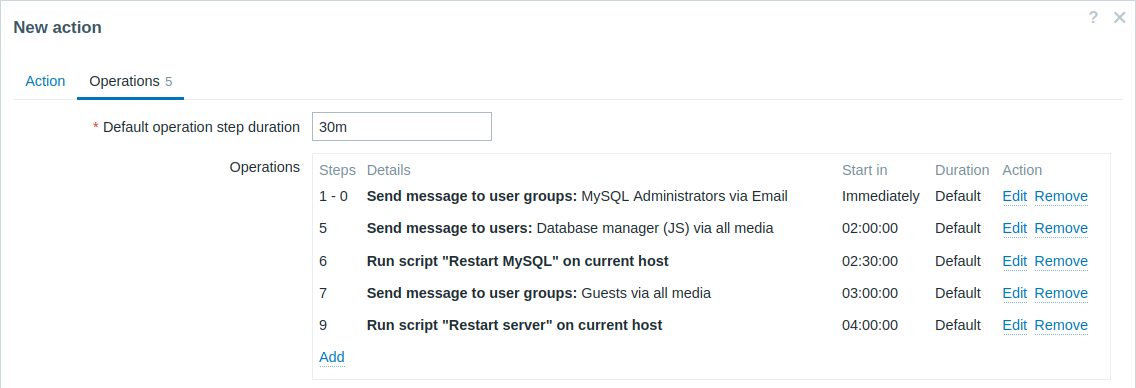
より複雑なシナリオ。 MySQL 管理者への複数のメッセージとマネージャーへのエスカレーションの後、Zabbix は MySQL データベースの再起動を試みます。 障害が 2:30 時間存在し、確認されていない場合に発生します。
それでも障害が解決しない場合は、さらに 30 分後に Zabbix がすべてのゲスト ユーザーにメッセージを送信します。
これで障害が解決しない場合は、さらに 1 時間後に、Zabbix は IPMI コマンドを使用して MySQL データベース (2 番目のリモート コマンド) でサーバーを再起動します。
例5
重複するステップ範囲とカスタム間隔を持つ複数のオペレーションを含むエスカレーション。デフォルトのオペレーションステップの継続時間は30分です。

通知は以下のように送信されます。
- 問題発生後、MySQL管理者には0:00、0:30、1:00、1:30に通知されます。
- データベースマネージャーには2:00と2:10に通知されます(後続のオペレーションで定義された短いカスタムステップ継続時間10分が、ここで設定された長いステップ継続時間1時間を上書きします。これは、オペレーションの詳細のステップ継続時間で、ステップが重複する場合の動作として説明されています)。
- Zabbix管理者には、問題発生後2:00、2:10、2:20に通知されます(カスタムステップ継続時間10分が適用されます)。
- ゲストユーザーには、問題発生後4:00に通知されます(ステップ8と11の間はデフォルトのステップ継続時間30分が有効になります)。